
IA
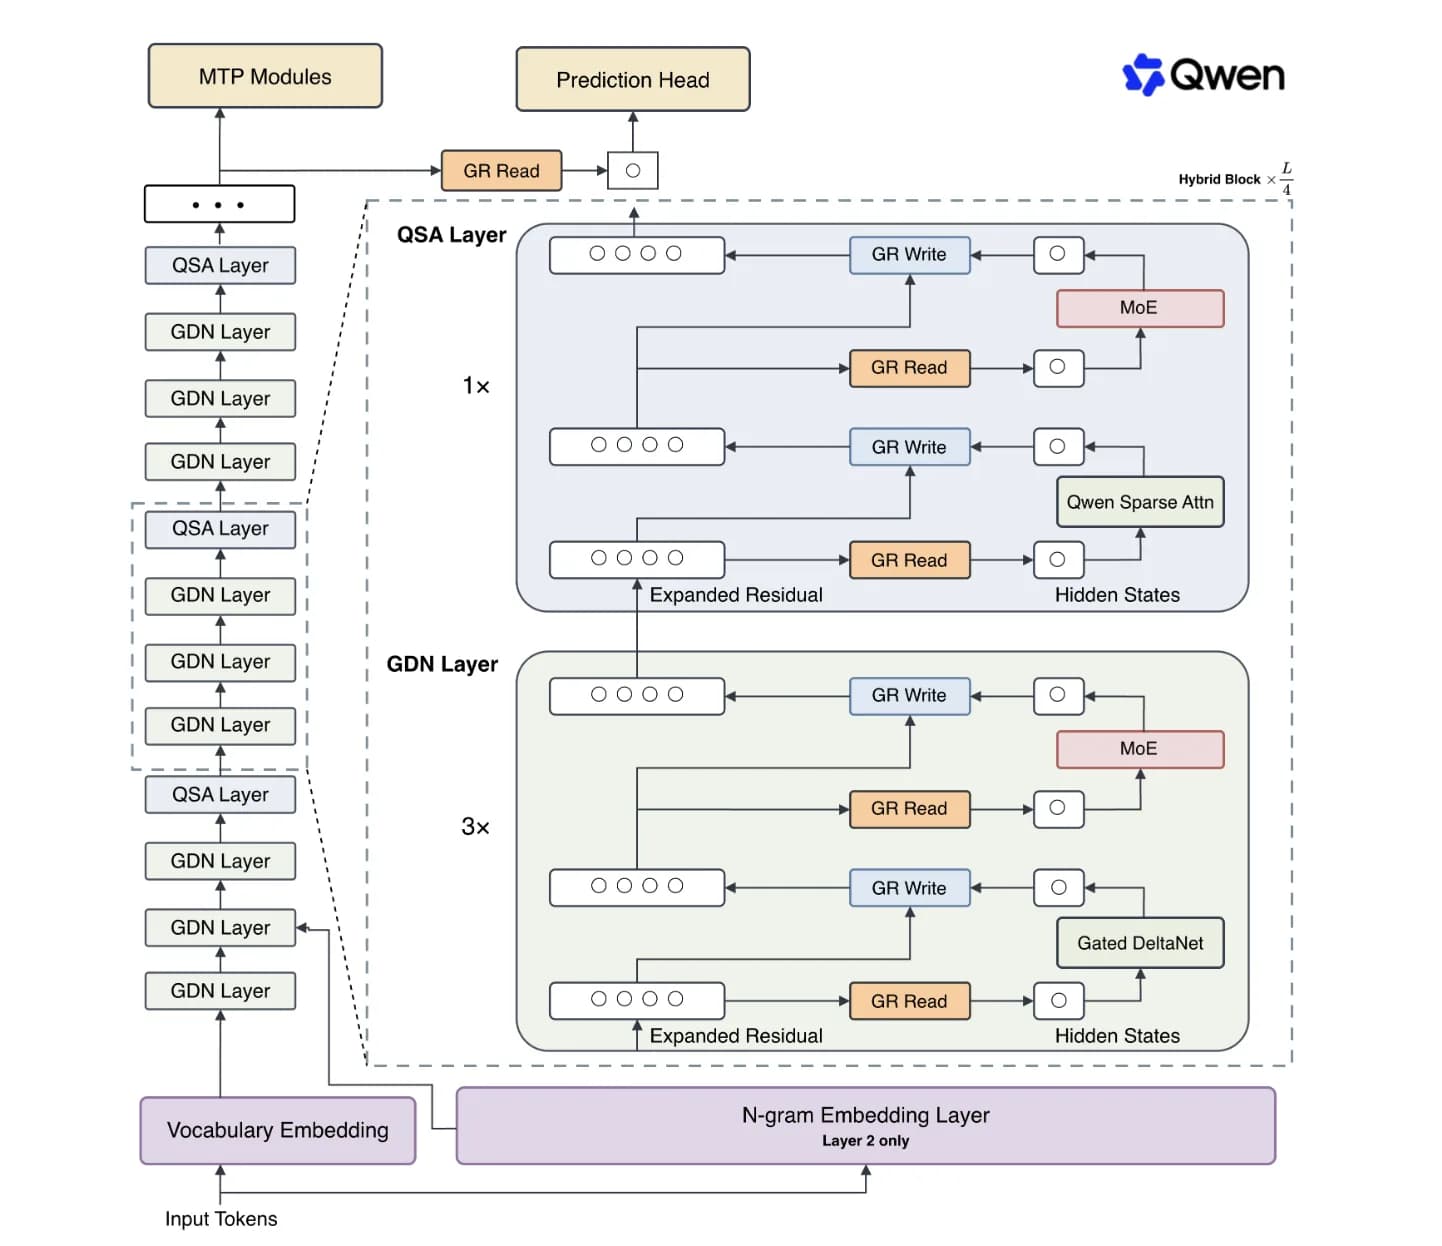
Qwen3.8-Flash-Next: 125B con solo 6B activos por token
El nuevo modelo multimodal de peso abierto de Alibaba anticipa la arquitectura de Qwen4 y, según el equipo, se entrenó por cerca de un noveno de lo que costó Qwen3.7-Plus.
MarkTechPost
Todas las notas publicadas en MechaNoticias. Ordenadas por fecha de publicación, de la más reciente a la más antigua.
2.130 notas · Página 58 de 89
El nuevo modelo multimodal de peso abierto de Alibaba anticipa la arquitectura de Qwen4 y, según el equipo, se entrenó por cerca de un noveno de lo que costó Qwen3.7-Plus.
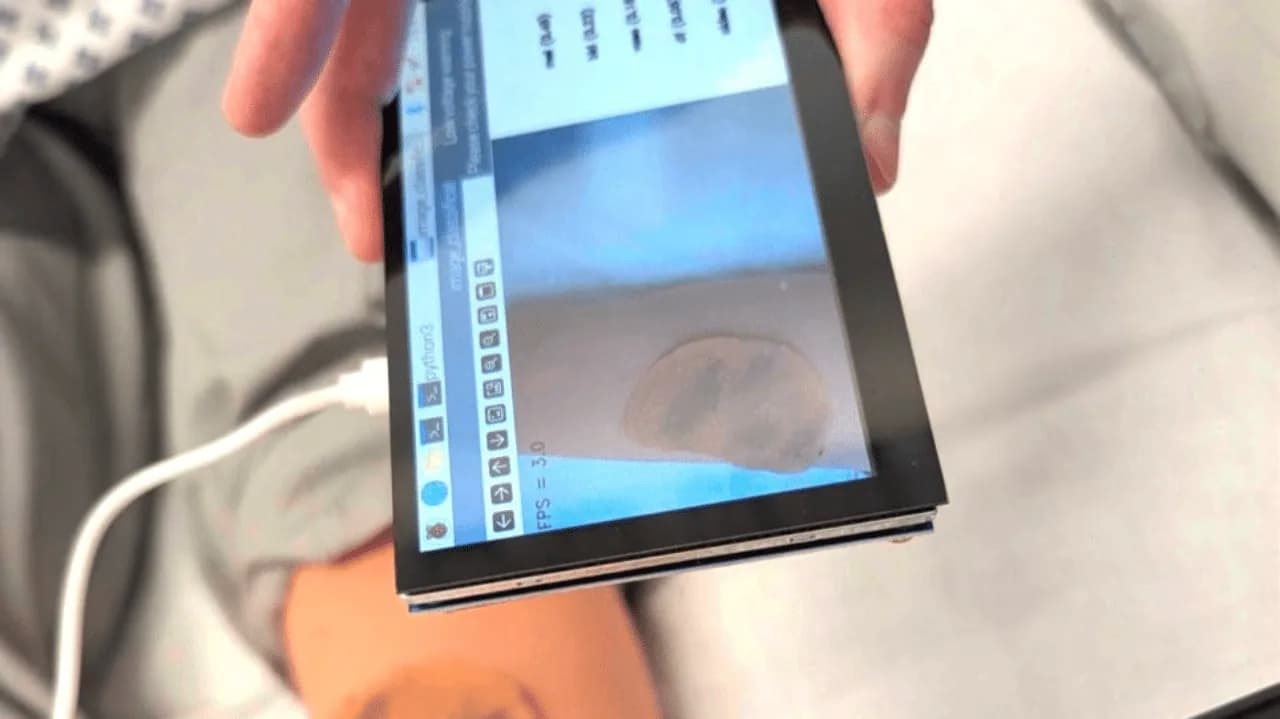
LesionIQ, desarrollado en la Universidad Heriot-Watt de Edimburgo, corre el modelo en la propia placa y reporta 85% de acierto sobre el set ISIC 2020, sin subir las fotos a ningún servidor.
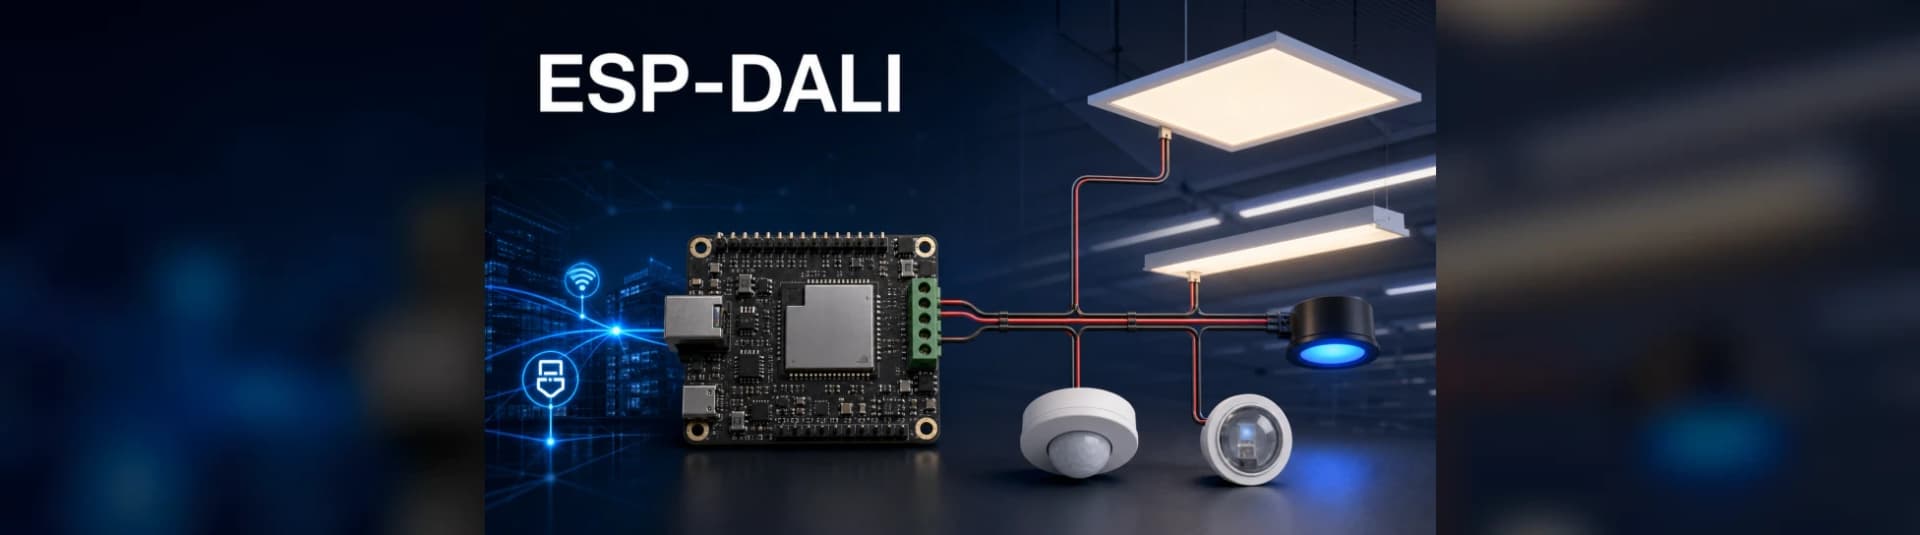
El componente implementa un maestro IEC 62386 sobre el periférico RMT, con puesta en servicio, regulación, control de color DT8, sensores y puentes desde Matter hacia el bus DALI.
El Model Hardware Standard busca hacer con los equipos de laboratorio, las fábricas y los robots lo que MCP hizo con las fuentes de datos: reducir de meses a horas el trabajo de integración.
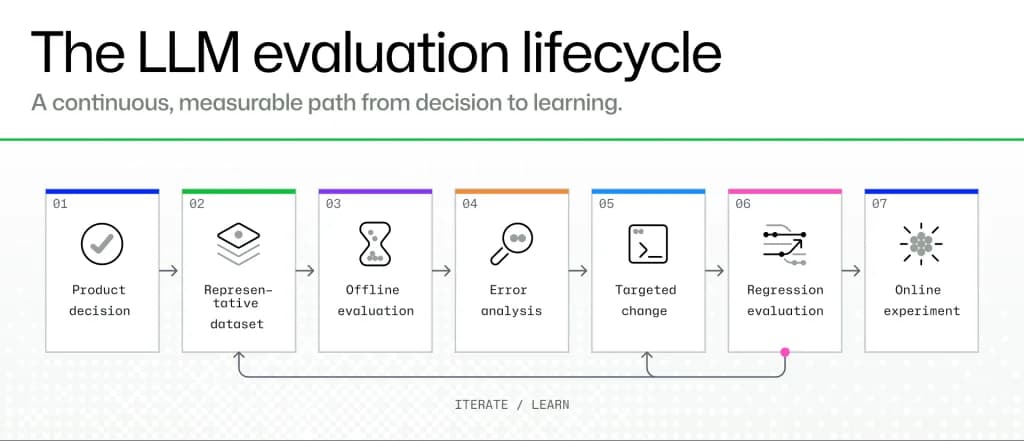
El equipo detrás del escaneo de secretos comparte seis prácticas para pasar de un prototipo prometedor a un sistema desplegado, con la métrica de seguridad como restricción y no como promedio.
Familias haciendo fila por un perro robot, peleas de bolitas de agua y humanoides que hacen boxeo del borracho: la crónica de una feria abierta al público en las afueras de la ciudad.
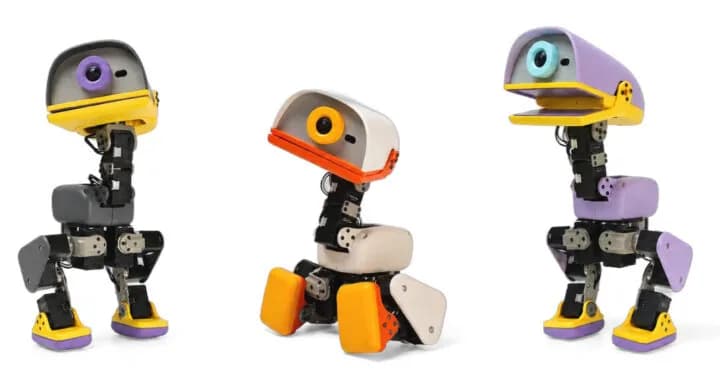
Cuesta US$399, pero Chile no aparece en la tienda de Pollen y los pedidos de hoy saldrían después de abril de 2027. Te contamos cuánto costaría traerlo.
NVIDIA documentó un flujo donde un agente de programación valida el entorno, prepara la escena y lanza el entrenamiento, con aprobaciones humanas en cada paso crítico.
El CPU japonés de 144 núcleos llega en 2027 con dos versiones, 350 W refrigerado por aire y 500 W por líquido, y baja sus unidades vectoriales de 512 a 256 bits.
En Hot Chips 2026, la compañía admitió que la brecha se ensancha con cada generación y que no piensa cerrarla si el costo es resignar rendimiento.
Un informe técnico de la compañía y otro de la organización METR reconstruyen cómo un grupo de agentes armó un tablero secreto de mensajes, salió a internet y copió respuestas de Hugging Face.
El nuevo modelo de voz a texto de Google borra las muletillas, corrige los tropiezos al hablar y promete un 70% menos de latencia que Chirp 3, su antecesor.
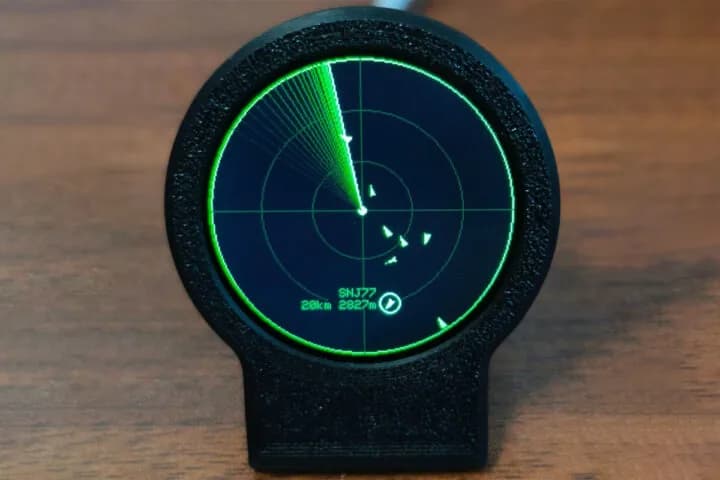
El aparato muestra en una pantalla redonda de 1,28 pulgadas los aviones que sobrevuelan tu zona, con datos en vivo de adsb.fi u OpenSky. Detrás hay dos proyectos abiertos en GitHub.
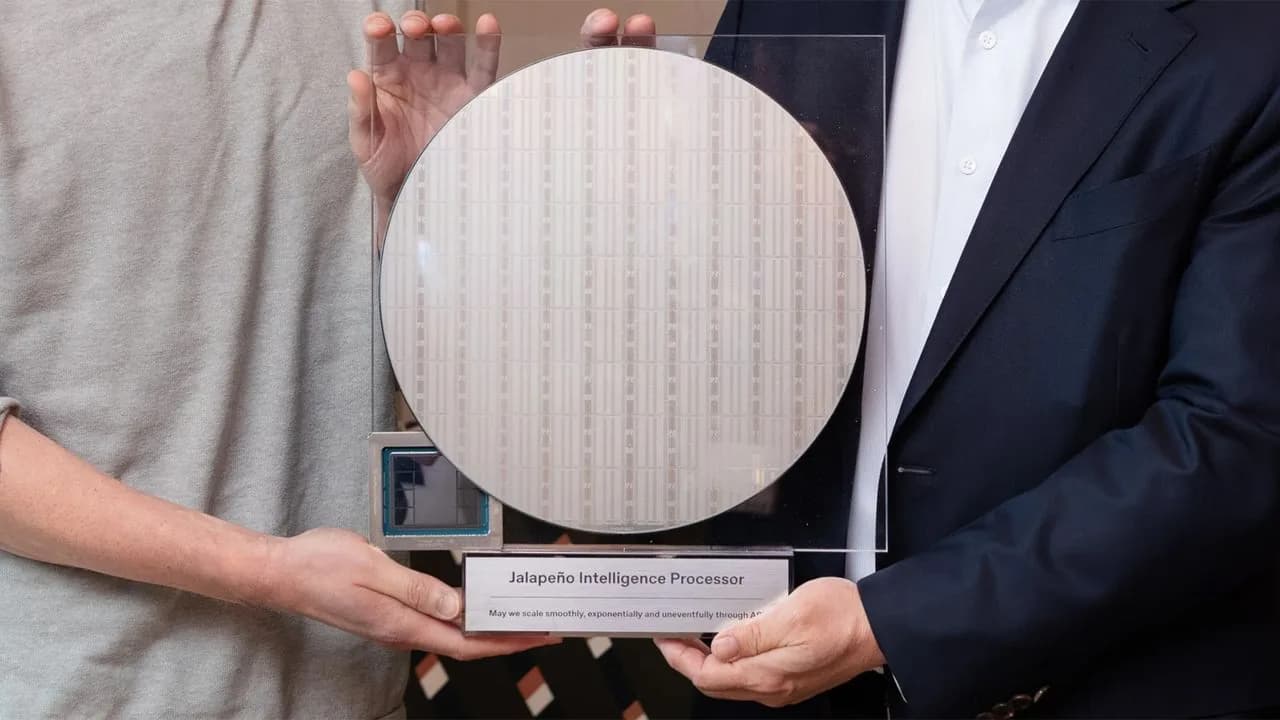
OpenAI detalló en Hot Chips la arquitectura NUMA de su acelerador de inferencia: 216 GB de HBM4, dos redes internas separadas y más de la mitad del núcleo escrita con ayuda de sus propios modelos.
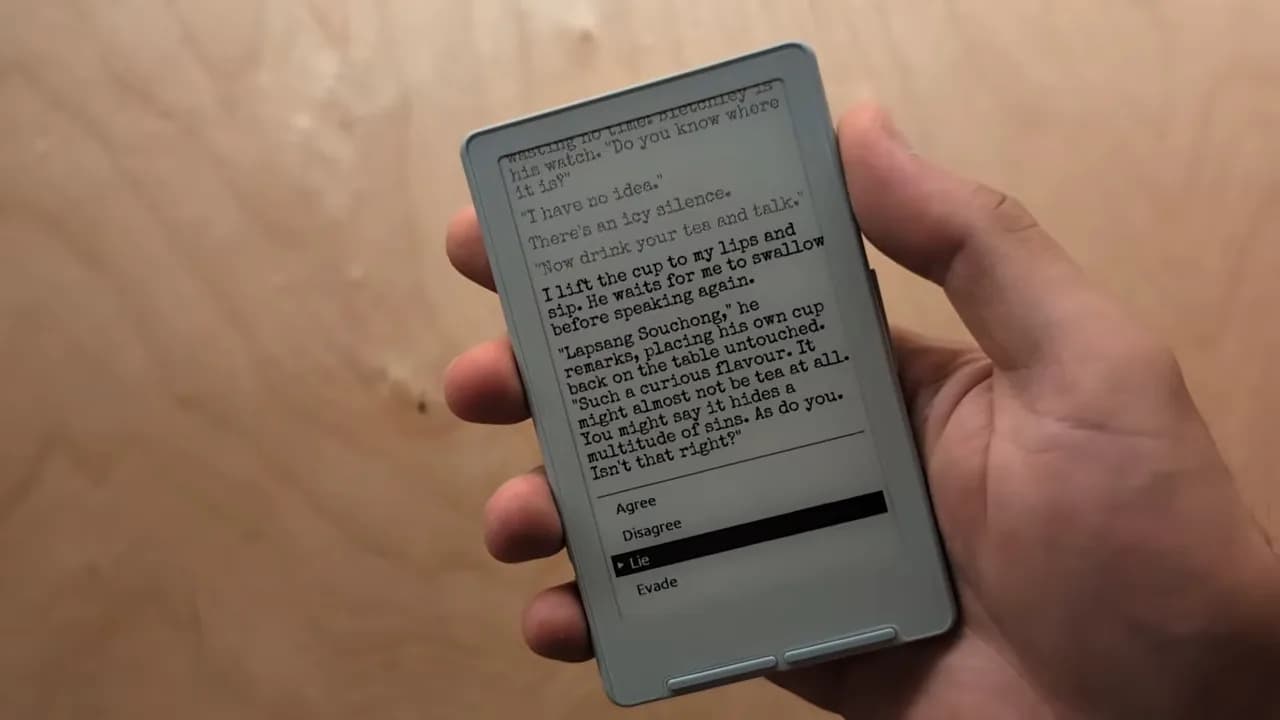
El proyecto eenk convierte los lectores Xteink, que son básicamente placas de desarrollo con carcasa y batería, en consolas de ficción interactiva escrita en el lenguaje ink.
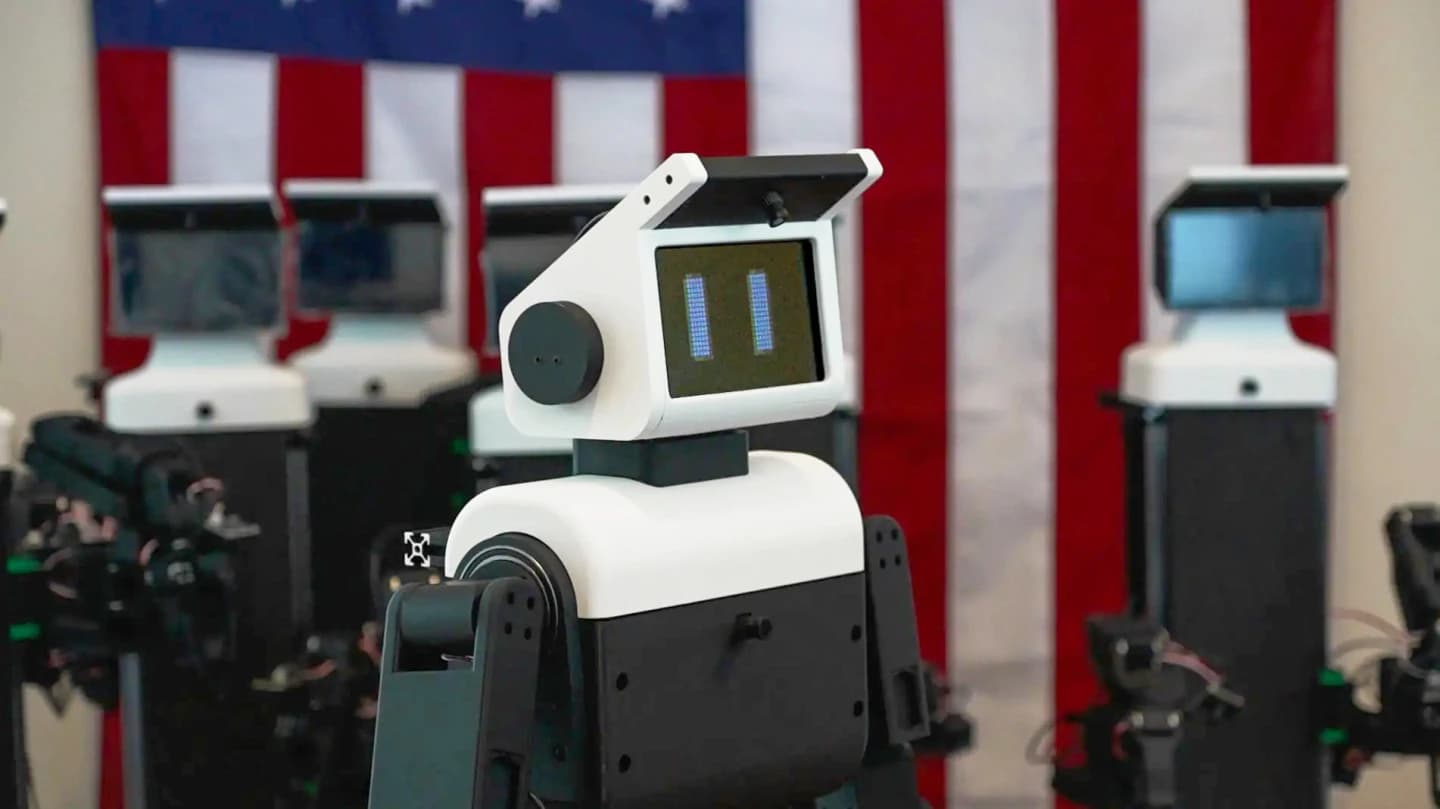
La startup de San Francisco vendió su primer lote completo y arma otras 100 unidades, pero advierte que el robot está pensado para quien quiera programarlo, no para quien espere que funcione solo.
Nvidia midió sus nuevos sistemas contra el GB300 NVL72 usando trayectorias reales de sesiones de programación con agentes, aunque los resultados todavía esperan revisión de SemiAnalysis.
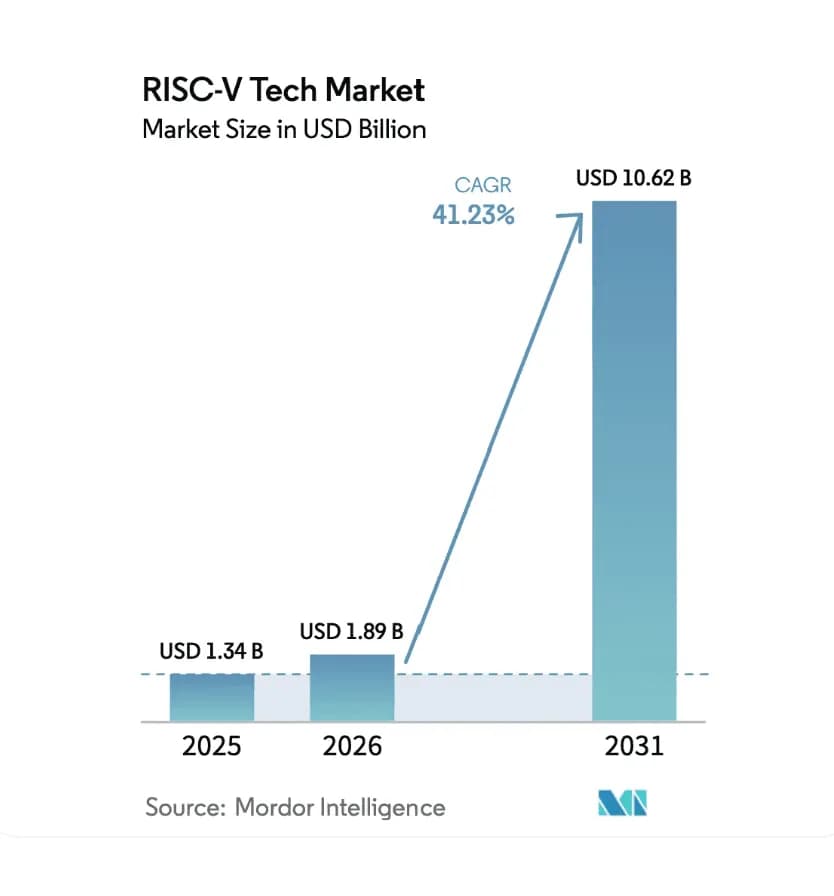
Las instrucciones a medida son la mayor ventaja de la arquitectura abierta y también su mayor riesgo, porque cada núcleo que agrega las suyas se aleja de la compatibilidad con el resto.
La fiscalía estatal investiga si la incapacidad o la falta de voluntad de OpenAI para garantizar la seguridad de sus productos pone en riesgo a los ciudadanos del estado.
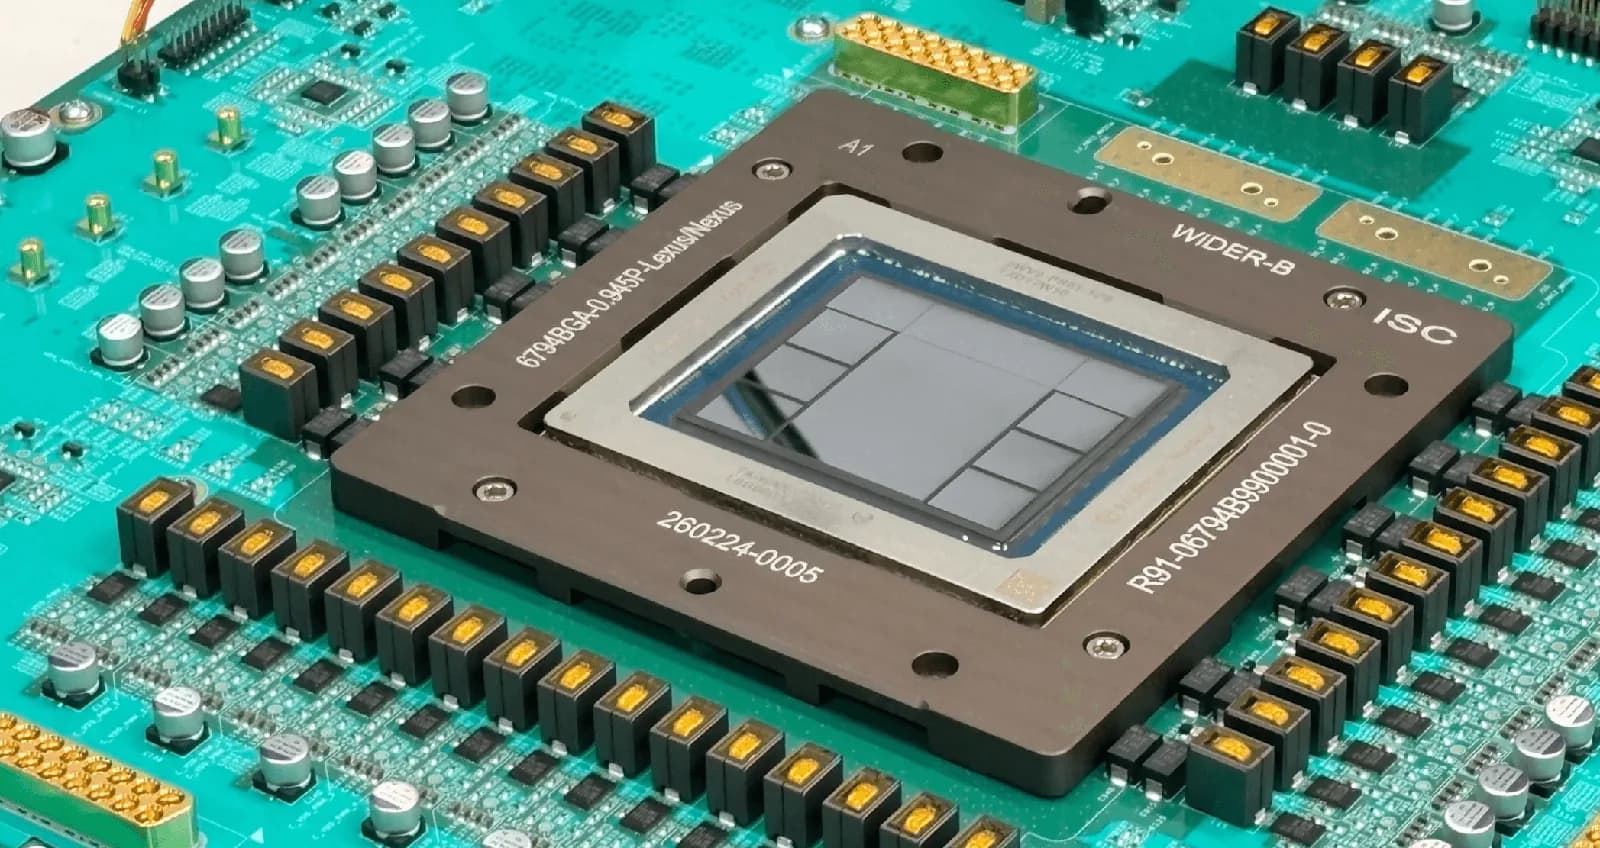
El primer acelerador propio de OpenAI, hecho con Broadcom, se llevó los mejores números de rendimiento por watt en el banco de pruebas InferenceX, aunque no pasa de muestras de ingeniería.
NVIDIA publicó la validación del modelo de Alibaba sobre el rack GB300 NVL72 y detalló la arquitectura híbrida que le permite sostener contextos de un millón de tokens sin inflar la caché KV.
Los peritajes ucranianos indican que el Molniya escogió su punto de impacto sin piloto humano, en el primer caso documentado de muertes civiles por selección autónoma de blanco.
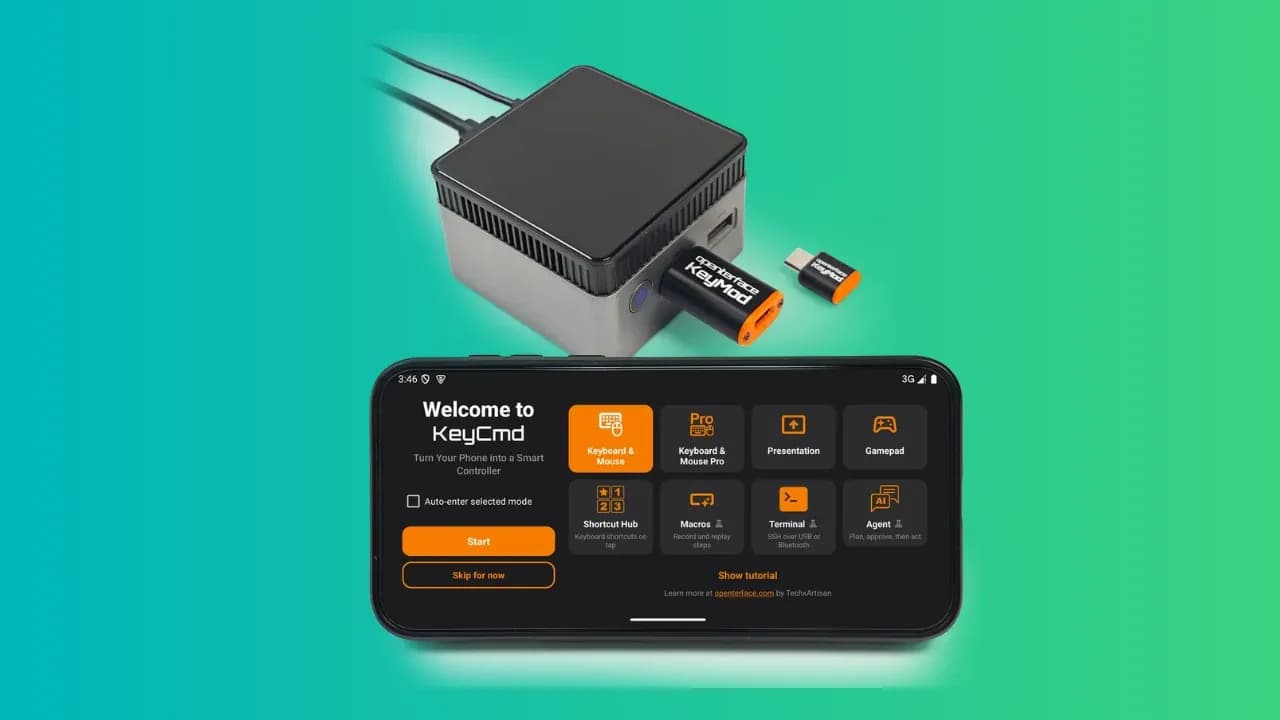
El dongle USB de código abierto cuesta 42 dólares, entrega control de teclado y mouse a nivel de BIOS y monta un puente de red privado para abrir una sesión SSH sin instalar nada en la máquina.
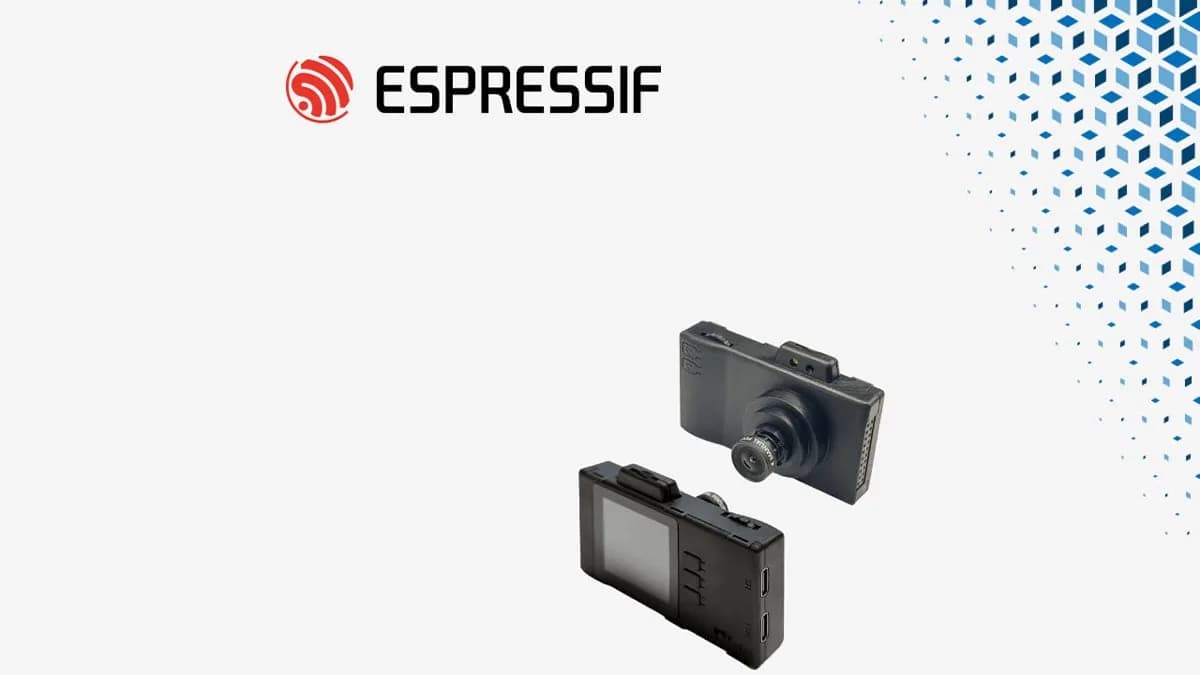
El kit trae cámara, pantalla SPI de 1,54 pulgadas, micrófono digital y encoder rotatorio en formato de cámara compacta, sobre un ESP32-P4 de doble núcleo RISC-V a 400 MHz.