Un proyecto de código abierto logra reconocimiento de voz en inglés, en tiempo real, sobre una placa con el ESP32-P4 de Espressif. No necesita conexión a internet, servicios en la nube ni un acelerador de IA separado, según informó Electronics For You el 28 de octubre.
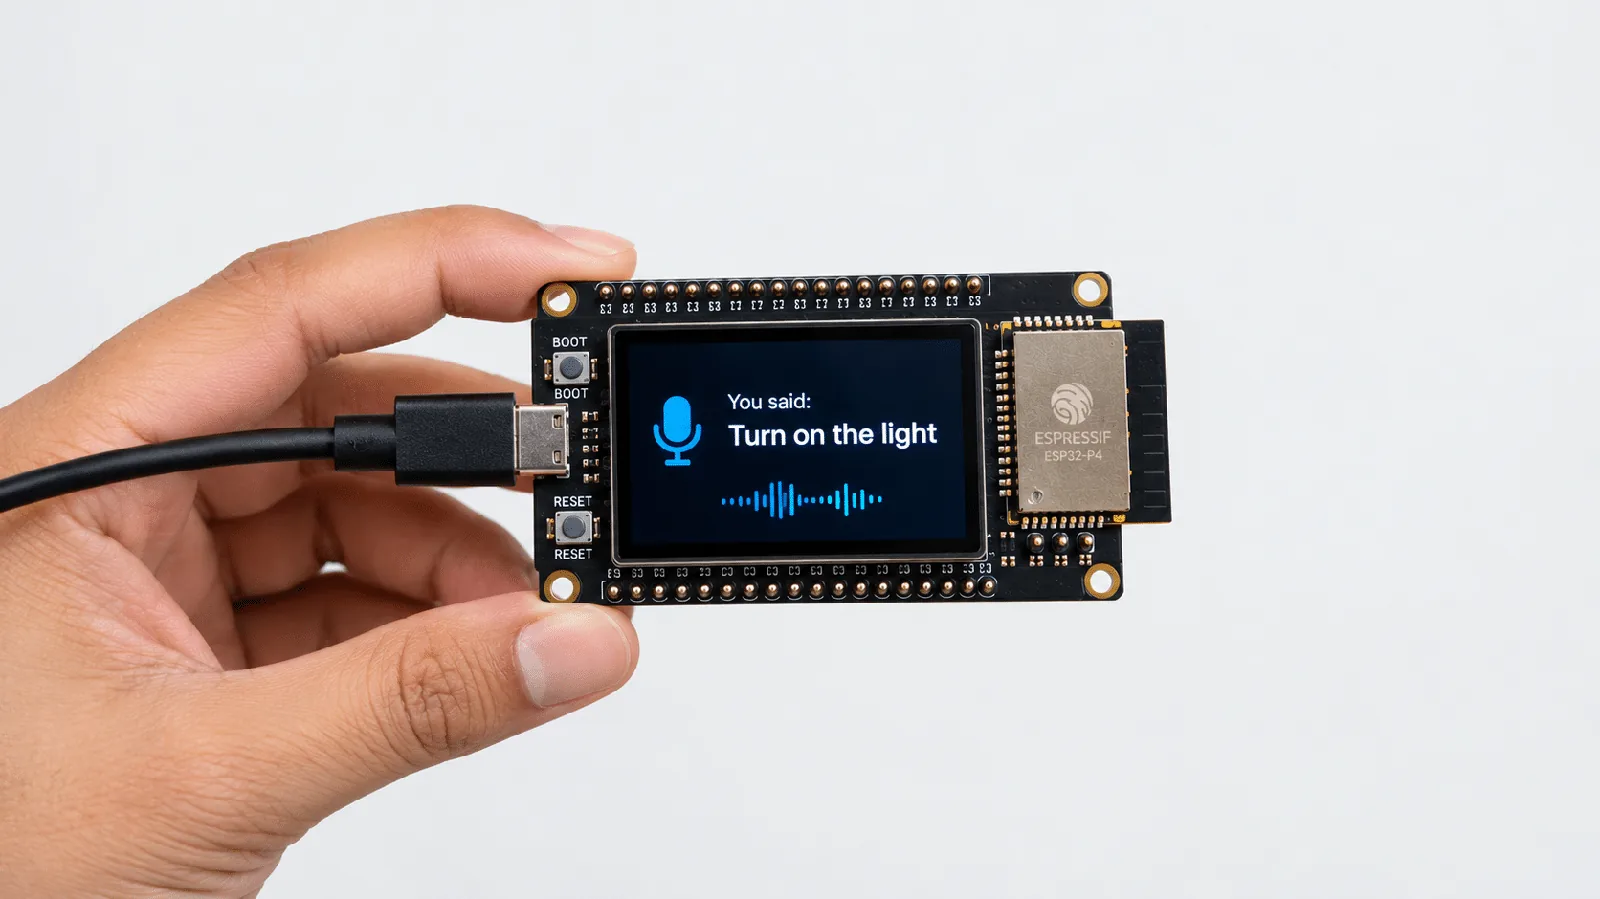
El proyecto convierte una placa de desarrollo en un asistente de voz sin conexión, que pasa a texto lo que se dice y responde a comandos hablados. Todo el procesamiento ocurre en la placa, así que el audio nunca viaja a un servidor externo. Tampoco depende del WiFi, lo que lo hace útil donde la conectividad falla o donde la privacidad importa.
¿Quién lo hizo y en qué corre?
Se llama esp32-pie-asr, lo desarrolló Boumedine Billal y está publicado en GitHub. Corre sobre el ESP32-P4X revisión v3, un microcontrolador RISC-V de dos núcleos. En vez de apoyarse en un acelerador neuronal dedicado, usa las instrucciones vectoriales PIE del propio chip. Además de los subtítulos en vivo en una pantalla conectada, trae seis demostraciones de control por voz.
El modelo, comprimido para caber en 32 MB
El corazón del sistema es Kroko, un modelo abierto de reconocimiento de voz de la empresa Banafo. Es una red Zipformer 2 Transducer de 65,7 millones de parámetros que procesa el audio en trozos cortos y va soltando palabras a medida que avanza.
El modelo original ocupa 71 MB. El proyecto lo baja a 26,65 MB con cuantización de 2 y 4 bits, y así los pesos caben en los 32 MB de PSRAM de la placa. Cargarlos desde una tarjeta microSD al arrancar toma cerca de 2,9 segundos.
El sistema también admite phrase biasing, o sea sesgar el reconocimiento hacia palabras y frases que el usuario escribe en archivos de texto plano guardados en la microSD.
¿Qué se necesita para replicarlo?
- Una placa ESP32-P4X-Function-EV-Board de Espressif (ESP32-P4X rev. v3, con 32 MB de PSRAM)
- Una tarjeta microSD
- Un cable USB-C
- Un computador con Google Chrome o Microsoft Edge
El repositorio oficial incluye un script en Python que descarga los pesos del modelo y los copia a la tarjeta. El firmware se puede flashear desde el navegador o con ESP-IDF v6.1 por línea de comandos.
La primera vez que se enciende, la placa crea en la tarjeta los archivos con las listas de frases. Desde ahí basta hablarle y mirar cómo aparecen los subtítulos. Esos archivos se pueden editar para adaptar las demos de control por voz.
¿Cuánto se equivoca y qué tan rápido responde?
Según el proyecto, la tasa de error de palabras es de 4,34% en el conjunto LibriSpeech test-clean y de 10,26% en test-other, que es más difícil. El modelo Zipformer 2 original, sin comprimir y corriendo en un PC, marca 3,94% y 9,17% en esas mismas pruebas.
| Conjunto de prueba | esp32-pie-asr en el ESP32-P4 | Zipformer 2 original en PC |
|---|---|---|
| LibriSpeech test-clean | 4,34% | 3,94% |
| LibriSpeech test-other | 10,26% | 9,17% |
En velocidad, procesa 1,28 segundos de audio en 0,90 segundos, con los dos núcleos a 400 MHz. Las palabras quedan fijas unos dos segundos después de dichas, y las acciones de control por voz se disparan entre 1,84 y 1,97 segundos después de que termina el comando.
El sesgo por frases mejora mucho el reconocimiento de comandos. Sobre 140 clips de prueba, baja la tasa de error de 19,5% a 3,4%. Con las listas de frases correspondientes, el reconocimiento de comandos llega a entre 94% y 99%, sin activaciones falsas en 88 clips de casi aciertos por demostración.
Licencias y límites
El motor, el firmware y las herramientas están en el repositorio esp32-pie-asr en GitHub bajo licencia Apache 2.0. Los pesos del modelo usan CC BY-SA 4.0, igual que Kroko. Hay además un firmware aparte, llamado live_transcriber, que entrega solo los subtítulos en vivo, sin las demos de control por voz. Cambiar el comportamiento de los comandos exige manejar C y ESP-IDF.
Por ahora solo reconoce inglés, y el árabe figura como trabajo planificado. Exige la placa ESP32-P4X indicada, con 32 MB de PSRAM, así que placas con menos memoria como el ESP32-S3 no sirven para este montaje. Por su retardo, calza mejor con subtítulos y comandos predefinidos que con una conversación natural.
Electronics For You plantea que en India podría servir como base para interruptores por voz, quioscos y subtítulos en salas de clases en zonas con internet poco confiable. El medio advierte que el modelo no está probado con el acento del inglés indio y no reconoce hindi ni otros idiomas de ese país. El sesgo por frases ayuda con nombres propios, lugares y términos técnicos, pero no agrega un idioma nuevo. Llevarlo a otras lenguas exigiría desarrollar y validar el modelo, y revisar que las licencias de los datos y del modelo sean compatibles.