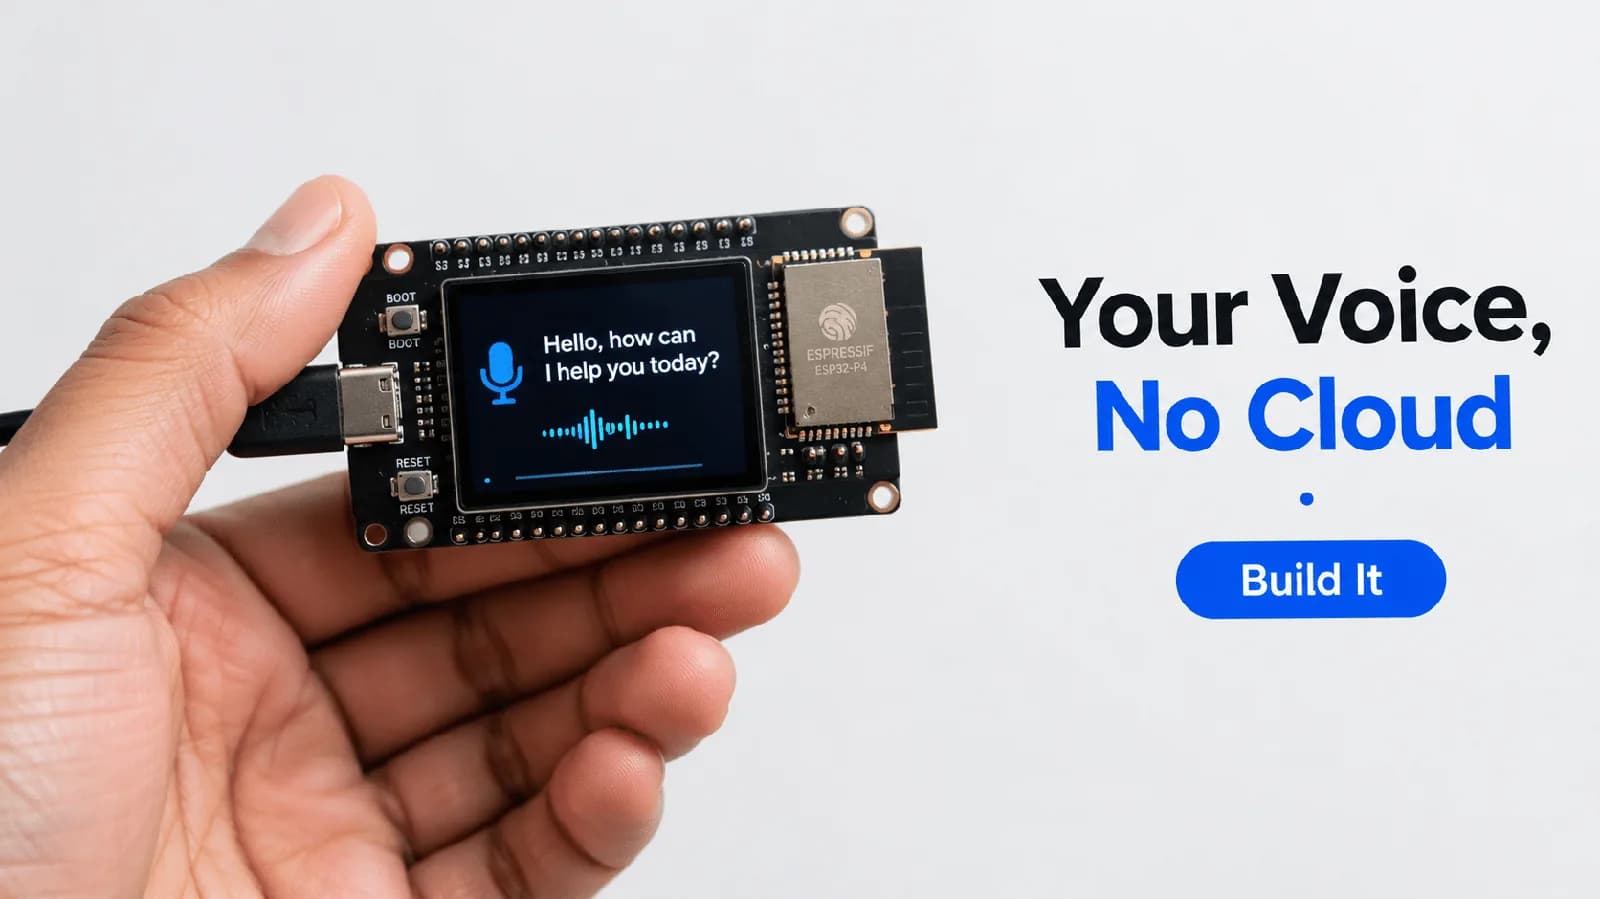
Un ESP32-P4 transcribe voz en inglés sin internet ni acelerador
El proyecto abierto esp32-pie-asr comprime un modelo de 65,7 millones de parámetros a 26,65 MB y lo corre entero en la placa, con subtítulos en vivo y seis demos de control por voz.
8 notas publicadas

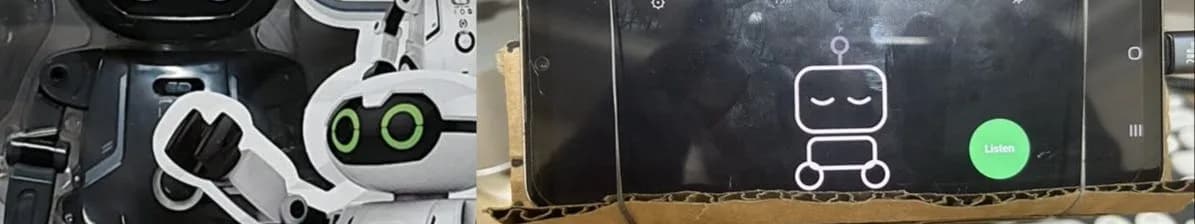
El maker Asten convirtió un Silverlit Maze Breaker en un robot con personalidad, un celular como cara y un modelo Qwen afinado para reaccionar en 200 ms.

La familia suma transcripción en 50 idiomas, síntesis de voz con emoción en más de 35 y un kit para armar agentes que escuchan, razonan y ejecutan tareas en tiempo real.

El modelo de transcripción en tiempo real entrega sus primeros resultados en poco más de 100 milisegundos, y MAI-Voice-2.1 habla 23 idiomas con la misma voz.

El sistema funciona sin conexión con Vosk y un modelo de 700 millones de parámetros, y resuelve los pedidos más comunes en menos de 5 ms sin llamar al modelo de lenguaje.

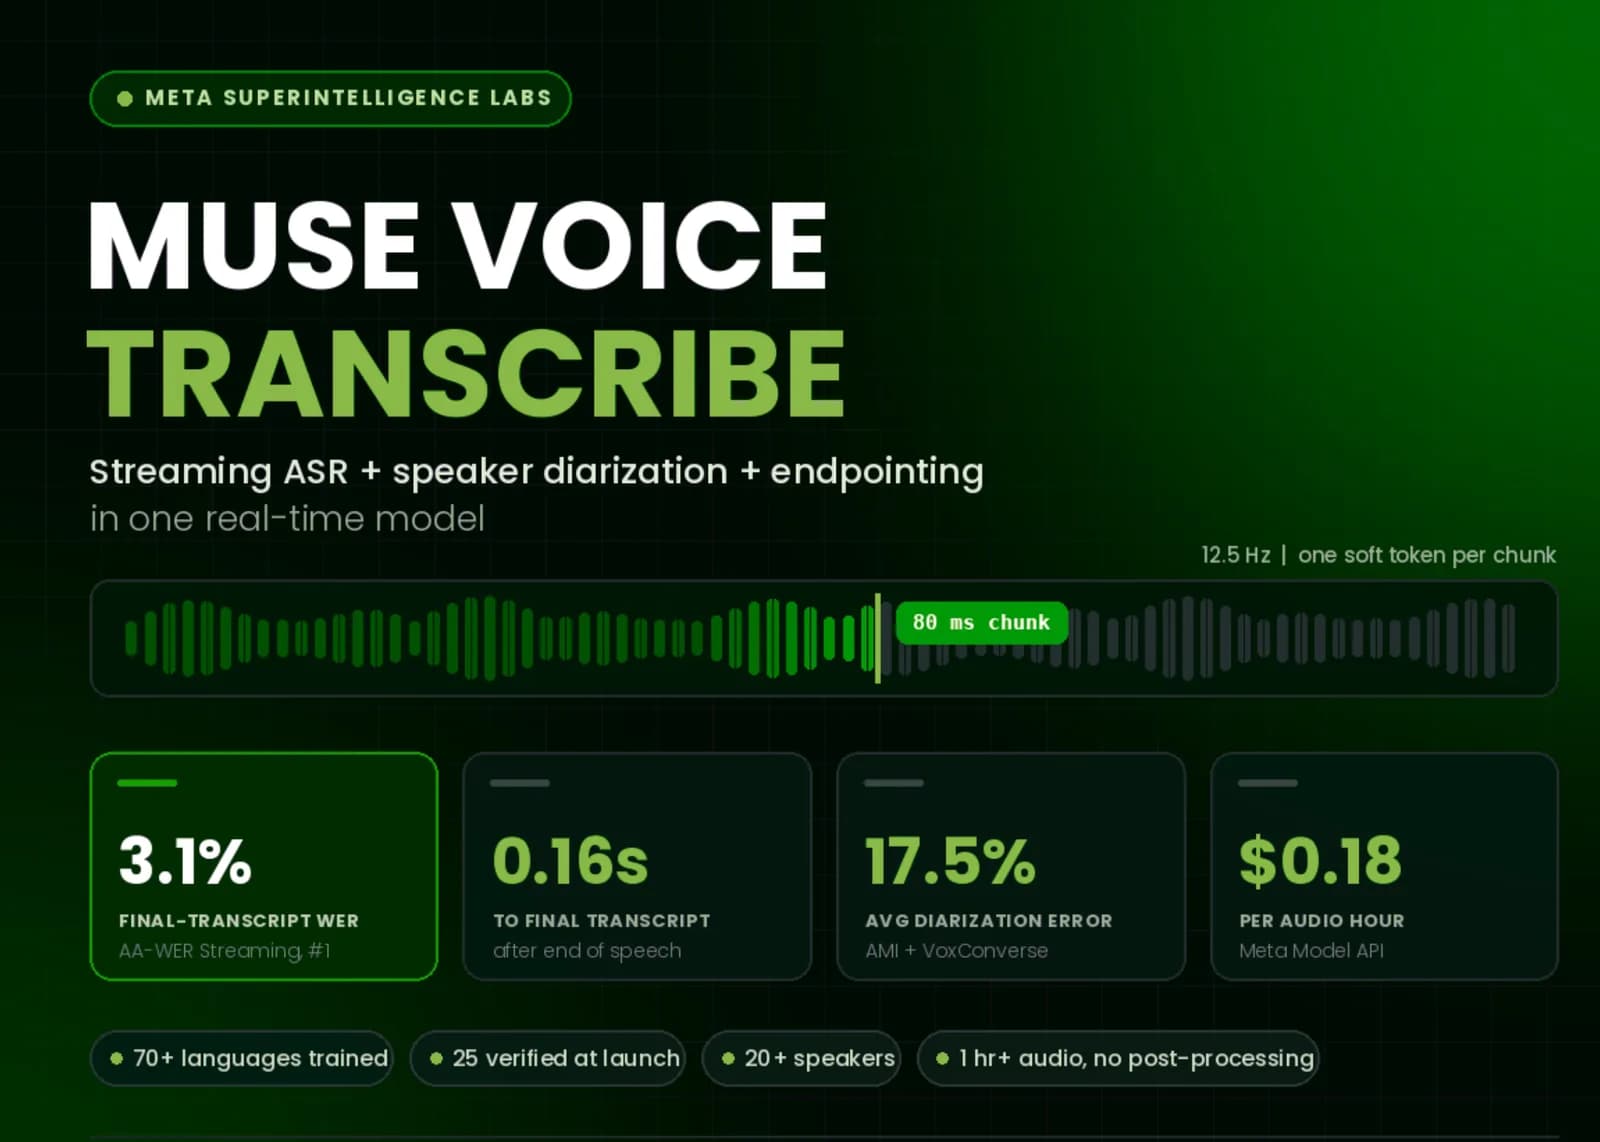
Meta presenta Muse Voice Transcribe, un modelo capaz de transcribir, identificar hasta 20 hablantes simultáneos y detectar pausas en tiempo real para asistentes IA.

Un solo modelo autorregresivo reemplaza a los tres sistemas encadenados que hoy usan las aplicaciones de voz: transcripción, separación de hablantes y detección de fin de turno.

El sistema de reconocimiento de voz tiene 2.000 millones de parámetros, se publica bajo licencia Apache 2.0 y ataca dialectos, mezcla árabe-inglés y vocabulario especializado.
Otros temas que aparecen junto a #reconocimiento de voz en nuestra cobertura editorial.