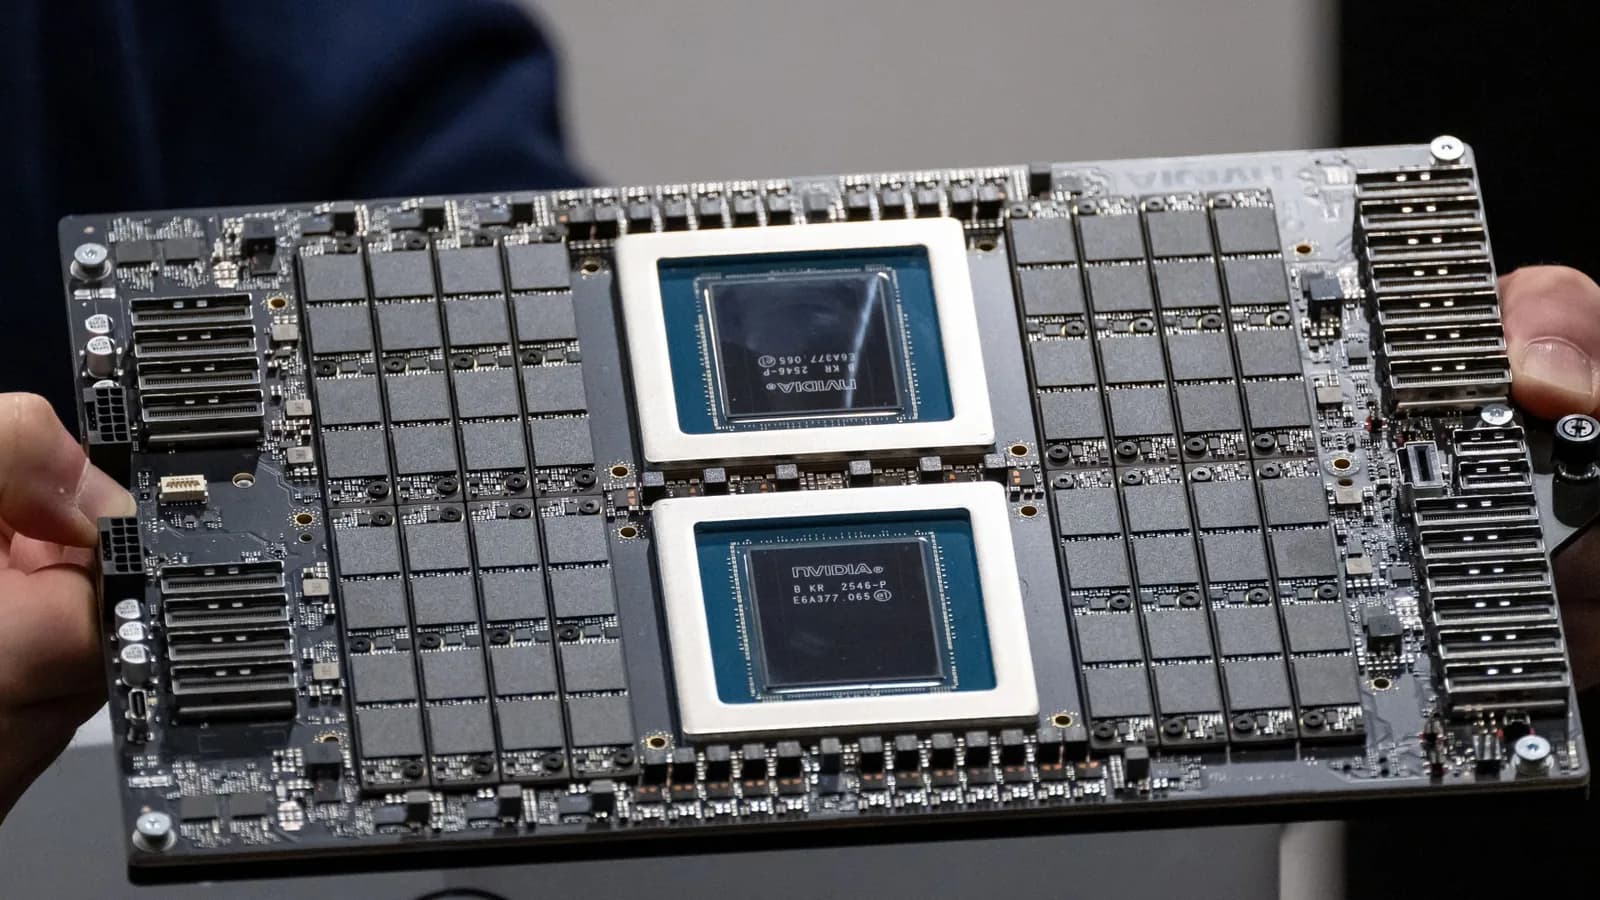
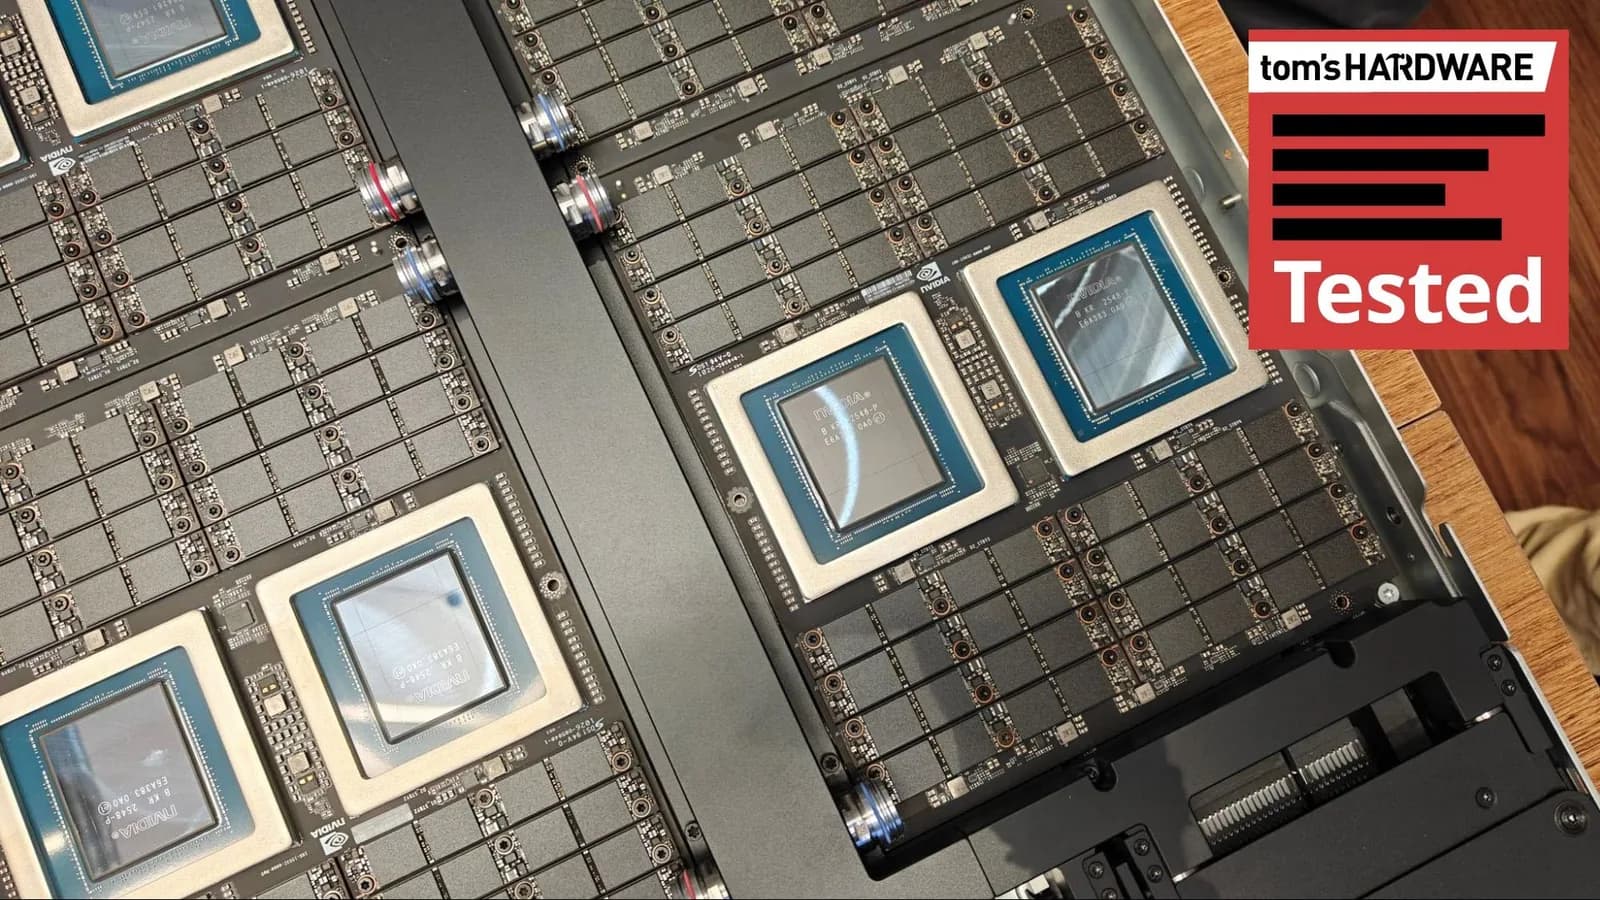
Tom's Hardware publicó el 30 de octubre de 2026 sus pruebas de Vera, la CPU de Nvidia para centros de datos, contra los Xeon 6 de Intel (Granite Rapids-AP) y los EPYC Turin de AMD. Nvidia presenta el chip como una CPU pensada para la IA agéntica, y según el medio esos argumentos de marketing tienen respaldo en los números.
Hoy no existen pruebas estandarizadas que midan un flujo agéntico completo sobre la CPU. Con las cargas disponibles, Vera muestra buenos indicios para ese uso. Encabeza las pruebas de Python, el lenguaje sobre el que se sostiene buena parte del software de IA, y entrega un ancho de banda de memoria muy alto tanto por zócalo como a nivel de sistema, gracias a la interconexión C2C entre chips Vera. Cuando muchos agentes consultan bases de datos grandes al mismo tiempo, ese ancho de banda pesa.
El chip llega a un mercado de servidores muy disputado. Por un lado están los chips Arm a medida que ya entraron al centro de datos, y por otro los x86 de AMD e Intel, que tienen la base instalada y una lista larga de clientes que trabajan con sus sistemas.
Lo que sorprendió al medio no fue el rendimiento en cargas cercanas a lo agéntico, sino que Vera también cumple en cargas generales de servidor, donde muchas veces iguala o supera a los AMD Turin y a los Intel Granite Rapids-AP comparables. En las cargas de frontend la balanza se equilibra y la mayor densidad de núcleos de los x86 suele ganar. Vera cambia esa densidad por rendimiento en operaciones de backend con muchos datos.
¿Qué trae la CPU Vera?
| Especificación | Nvidia Vera |
|---|---|
| Núcleos / hilos | 88 / 176 |
| Caché L2 | 2 MB por núcleo |
| Caché L3 | 164 MB por CPU |
| Memoria | Hasta 1,5 TB de SOCAMM2 LPDDR5X |
| Velocidad de memoria | Hasta 9.600 MT/s |
| Ancho de banda de memoria | Hasta 1,2 TB/s agregado, 14 GB/s por núcleo |
| PCIe | 88 carriles PCIe 6.4 (solo CPU), 96 carriles (Vera Rubin), bifurcación hasta x2, CXL 3.1 |
| TDP configurable | 250 W a 450 W |
Vera usa Olympus, el primer núcleo propio de Nvidia, y mejora en casi todo frente a Grace, que usaba un diseño de núcleo Arm de catálogo. Los 88 núcleos siguen la arquitectura Armv9.2-A y ejecutan dos hilos por núcleo con lo que Nvidia llama spatial multithreading.
El chip tiene un decodificador de 10 instrucciones de ancho, parecido al AGI de Arm, y la segunda generación del Scalable Coherency Fabric (SCF) de Nvidia. El SCF es una malla que reparte la caché L3 por todo el die y ofrece hasta 3,4 TB/s de ancho de banda interno, y según Tom's Hardware buena parte del rendimiento de Vera depende de él.
La memoria es SOCAMM2 LPDDR5X reemplazable a 9.600 MT/s. Eso da hasta 1,2 TB/s de ancho de banda total, cerca de 14 GB/s por núcleo, más del doble que los diseños densos Turin de AMD.
El medio quiso ver cómo se comporta frente a la competencia x86 antes de que empiecen a llegar Venice de AMD y Diamond Rapids de Intel.
Las plataformas de prueba
| Plataforma | Memoria | Procesadores probados |
|---|---|---|
| 2P Nvidia MGX Vera (referencia) | 16 x 96 GB (1,5 TB) Samsung LPDDR5-9600 ECC SOCAMM2 | Nvidia Vera |
| 2P Supermicro SYS-222HA | 24 x 64 GB (1,5 TB) Micron DDR5-8800 ECC MRDIMM | Intel Xeon 6980P |
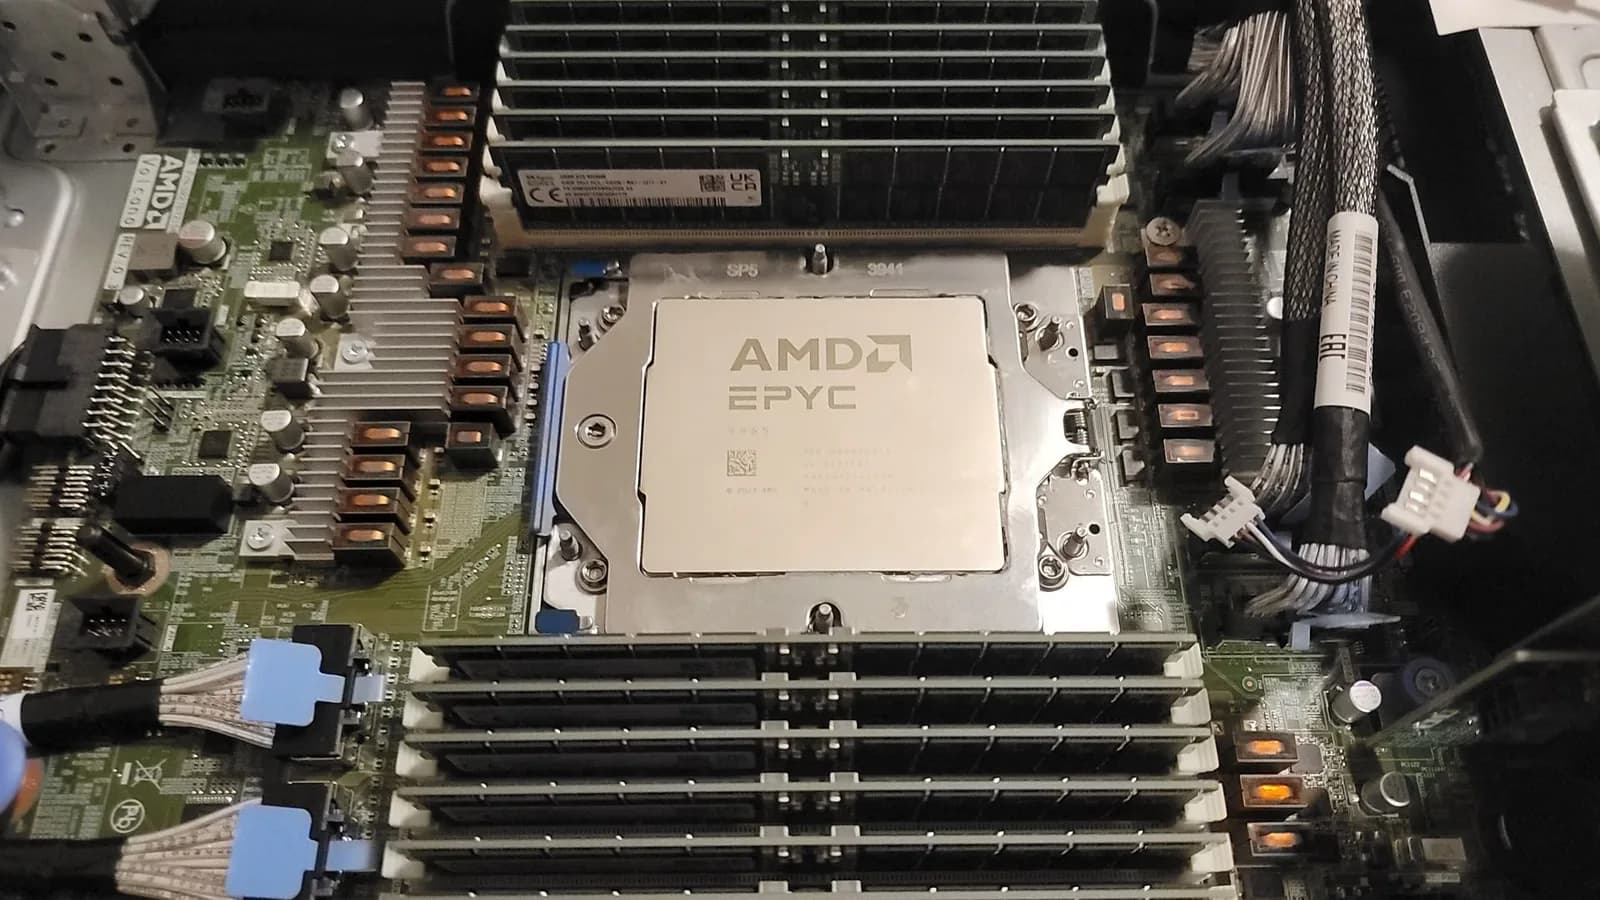
| 2P AMD Volcano (referencia) | 24 x 64 GB (1,5 TB) SK hynix DDR5-6000 ECC RDIMM | AMD EPYC 9965 y EPYC 9755 |
¿Qué hace una CPU en un flujo agéntico?
La definición de "CPU agéntica" depende de a quién se le pregunte, y hasta ahora la han moldeado sobre todo AMD y Nvidia. Tom's Hardware prefiere partir de cómo se despliegan hoy las plataformas de agentes.
Servicios como Meta Muse y OpenAI Dots ofrecen agentes persistentes que reservan una porción de cómputo en la nube. Son racks solo de CPU que se comunican con servidores de inferencia, donde corren los modelos. Lo que define su carga es la concurrencia, o sea cómo rinde cada sandbox cuando el chip está completamente cargado, y no el rendimiento de uno aislado.
Algunas llamadas a herramientas son pesadas, como compilar código o consultar bases de datos grandes. Leer y escribir archivos, correr pruebas o navegar con un navegador sin interfaz no exige mucho a la CPU por separado. Pero cuando el chip atiende miles de esas llamadas a la vez, las pequeñas ventajas se acumulan, y la topología de la CPU influye en cómo se sostiene el rendimiento a medida que crecen las sesiones.
El segundo rasgo es la variabilidad. Mark Lohmeyer, vicepresidente y gerente general de infraestructura de IA y cómputo de Google Cloud, le puso a Tom's Hardware el ejemplo de planificar unas vacaciones con un agente durante un mes, con ráfagas de trabajo separadas por días sin actividad.
"El uso real del cómputo subyacente ocurre básicamente en ráfagas, ¿cierto? Hay una ráfaga de uso al inicio, quizás por una hora, y luego se va, y un par de días después vuelve a haber una ráfaga para otro propósito y se va", dijo Lohmeyer. "Son cargas de trabajo muy largas, en la práctica de larga duración, pero muchas veces inactivas."
Si esas ráfagas coinciden en un servidor con contención de hardware, todas las sesiones se arrastran. A eso se suma el tipo de trabajo, que incluye compilación pesada, recorrido de grafos y consultas grandes a bases de datos, multiplicado por varios agentes con ciclos independientes que no se alinean entre sí.
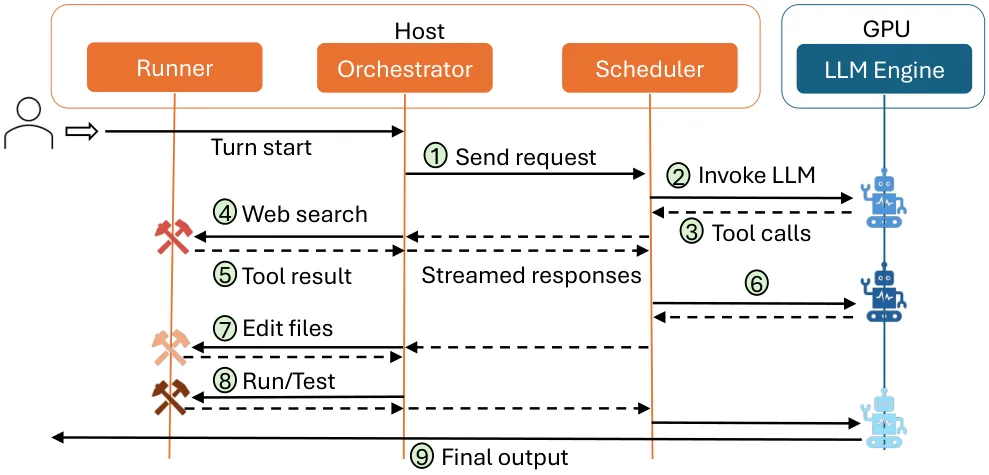
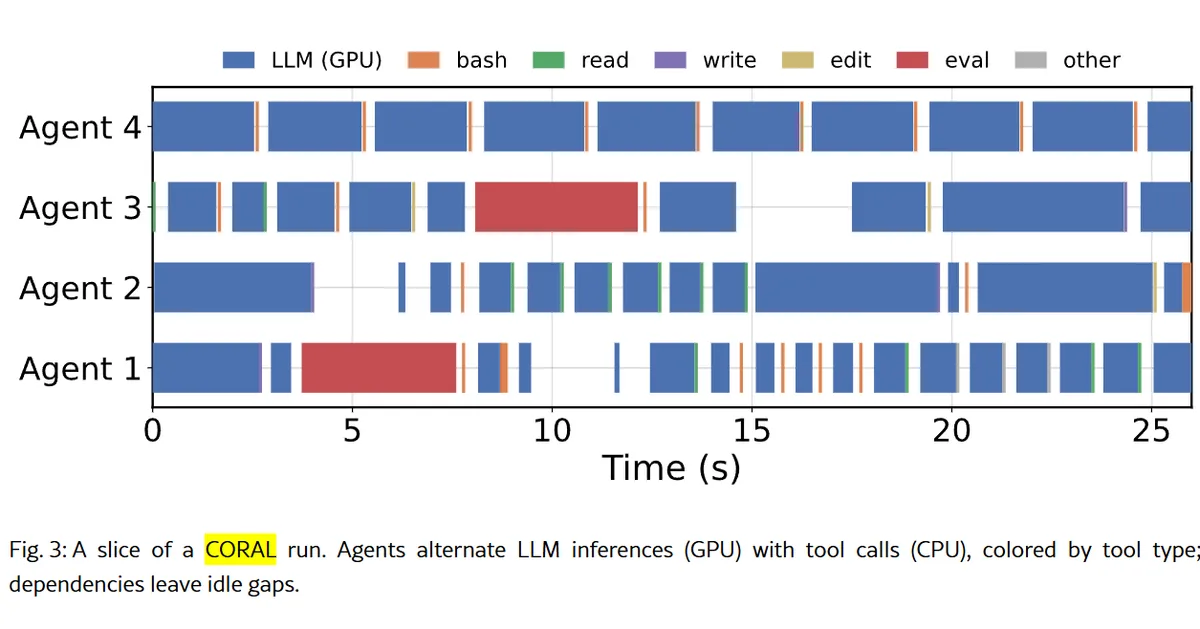
El estudio Architectural Implications of Agentic AI Workflows, publicado en agosto de 2026 por investigadores de la Universidad de Texas en Austin y Microsoft Azure, describe tres tareas de la CPU en un flujo agéntico. Además de programar la inferencia en la GPU, que es su papel en una consulta simple a un LLM, la CPU orquesta el estado y la comunicación de los agentes y ejecuta las herramientas y la lógica del agente, muchas veces en Python. El mismo trabajo muestra, en un corte de cuatro agentes durante menos de medio minuto, cómo las tareas pequeñas de CPU se alinean y generan esperas entre los turnos de GPU.
"La industria construyó una forma bastante buena de medir las cargas tradicionales", dijo Lohmeyer. "Creo que eso está pasando ahora con las GPU y las TPU para inferencia, por ejemplo. Creo que vamos a necesitar el mismo tipo de pruebas de referencia a nivel de industria para cargas agénticas, que probablemente todavía están surgiendo."
Cómo se hicieron las pruebas
No hay pruebas estandarizadas del ciclo agéntico completo al estilo de SPEC o TPC. Tom's Hardware dice tener pruebas internas en curso y menciona mediciones de proveedores como Modal, pero la industria aún no publica un conjunto común.
Mientras tanto, el medio midió a Vera mirando lo que importa en un ciclo agéntico. Compilación de código para agentes que programan, rendimiento de bases de datos para agentes de recuperación, lectura de archivos JSON grandes con la biblioteca simdjson (el formato con el que se comunican los agentes) y rendimiento en Python.
Nvidia no limitó las pruebas ni puso condiciones sobre la cobertura, según el medio. Entregó acceso remoto a un sistema Vera de dos zócalos y solo revisó que la plataforma estuviera bien configurada. Además de las pruebas ligadas a lo agéntico, Tom's Hardware corrió su batería general de servidores, con Java, criptografía, compresión y renderizado.
El medio advierte que un servidor no es un PC. Los operadores tienen acceso más profundo al hardware y un software ajustado a cada carga, así que no corresponde decir que un chip es "el mejor" como se hace con los procesadores de escritorio. Los hiperescaladores mantienen flotas variadas y las empresas eligen según la carga, el costo total de propiedad y una docena de variables propias.
SPEC CPU 2026
Hasta ahora la principal cifra pública de Vera era la de SPEC CPU 2026 intrate. Tom's Hardware corrió la suite completa de SPEC CPU 2026 para contrastar lo que afirma Nvidia y para medir también el rendimiento en punto flotante. Todas esas corridas son estimaciones, por la forma en que SPEC regula la publicación de resultados oficiales.