
Electrónica
ByteDance, Alibaba y Tencent piden 3 millones de RTX Pro 5500
Los pedidos superan los 35.000 millones de dólares, pero NVIDIA solo podría entregar entre 5% y 10% de lo que piden, según fuentes de Reuters.
Tom's Hardware
41 notas publicadas
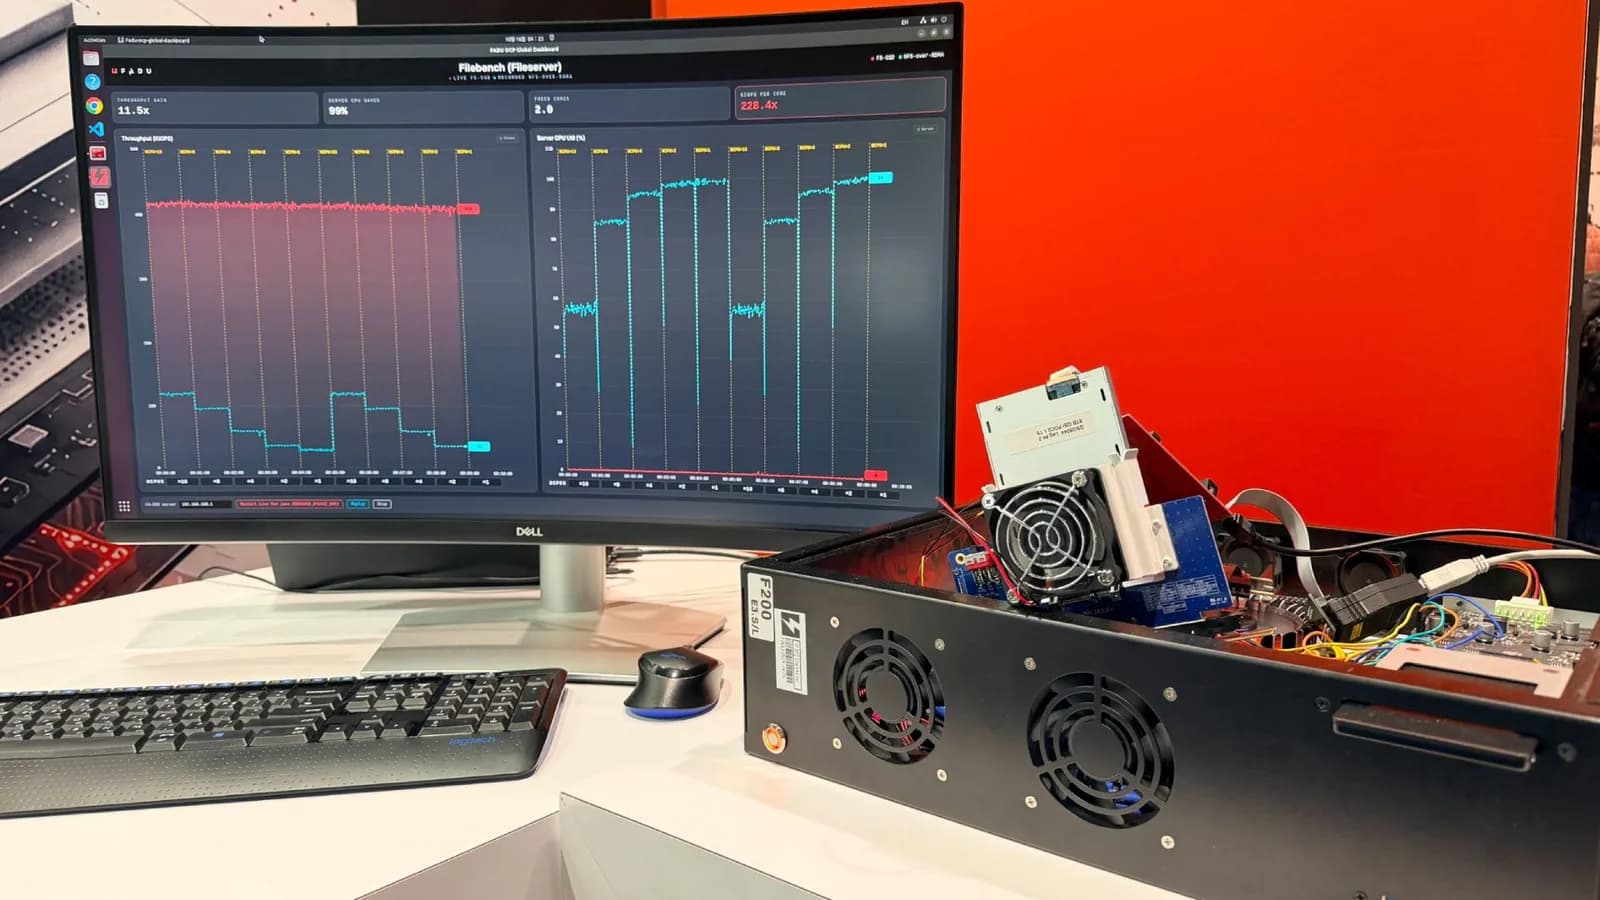
Su FS-SSD deja que GPU, DPU y tarjetas de red lean archivos sin pasar por el servidor, y en una prueba mantuvo 460.000 operaciones por segundo con un solo núcleo.
La cifra sale de un modelo de consumo por rack y de una metodología propia de Arm para agentes de IA, revisada por Signal65 a pedido de la empresa.
El chip propio de Azure llega en 2027 en racks de hasta 96 aceleradores, con ocho pilas de HBM4 y 18 TB/s de ancho de banda por chip.
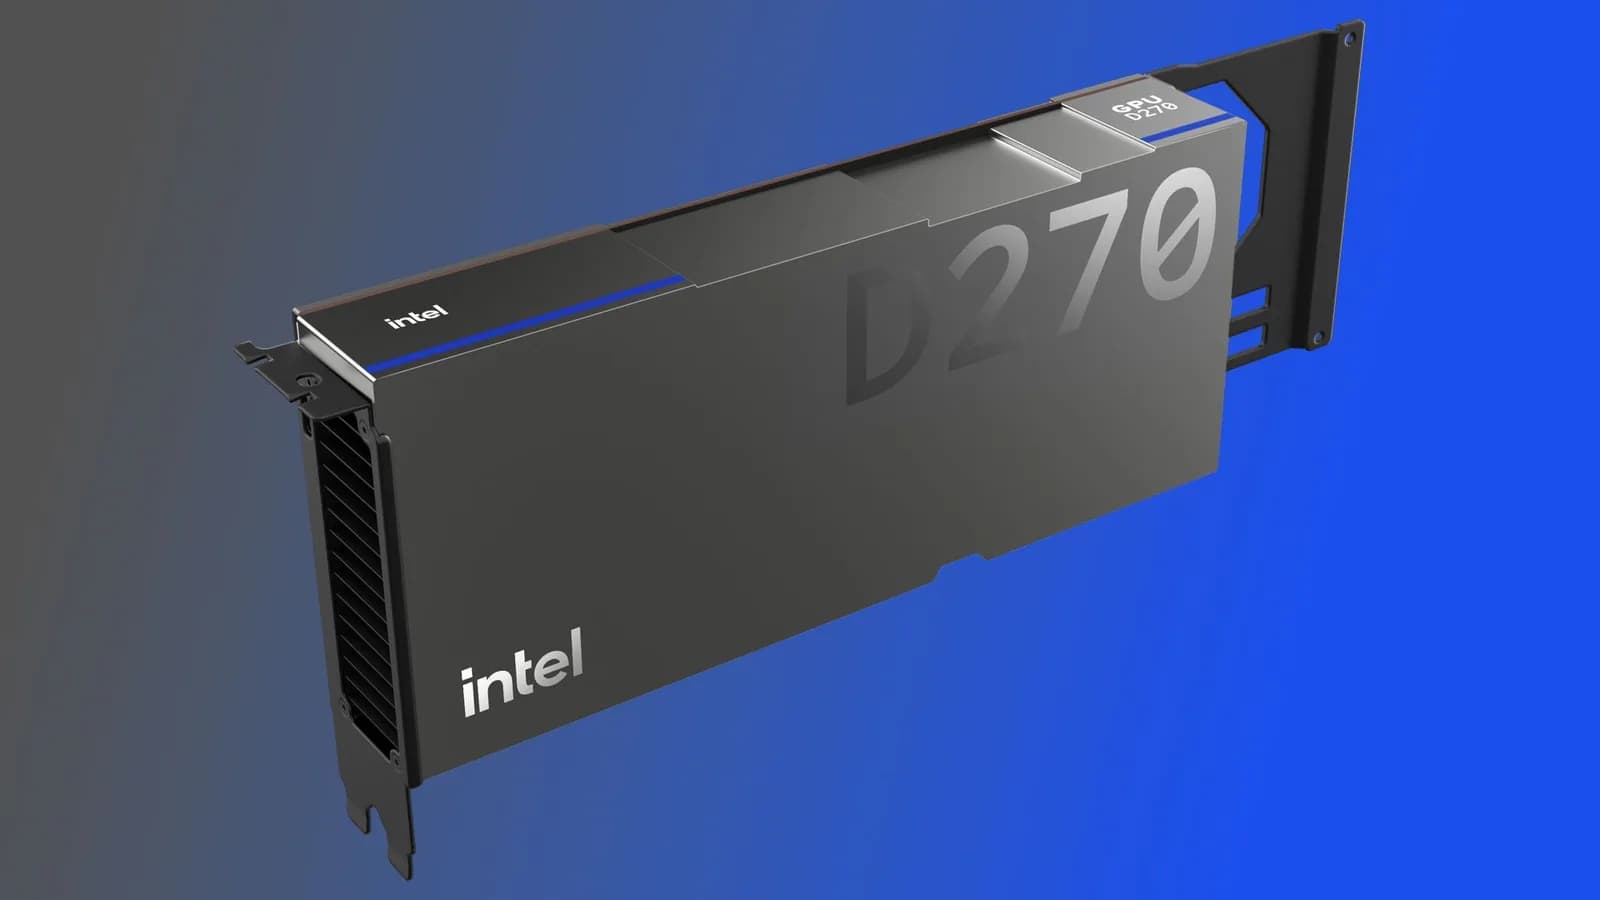
El acelerador de inferencia promete 1,3 PFLOPS en FP8, 1,5 TB/s de ancho de banda y refrigeración por aire en tarjetas PCIe de 350 W.
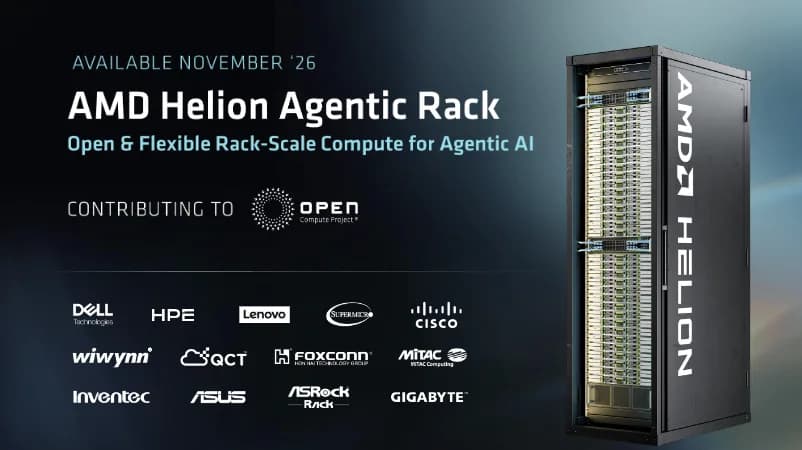
El diseño abierto para el Open Compute Project apunta a los servidores de CPU que usan los agentes de IA y AMD adelantó su llegada a noviembre de 2026.
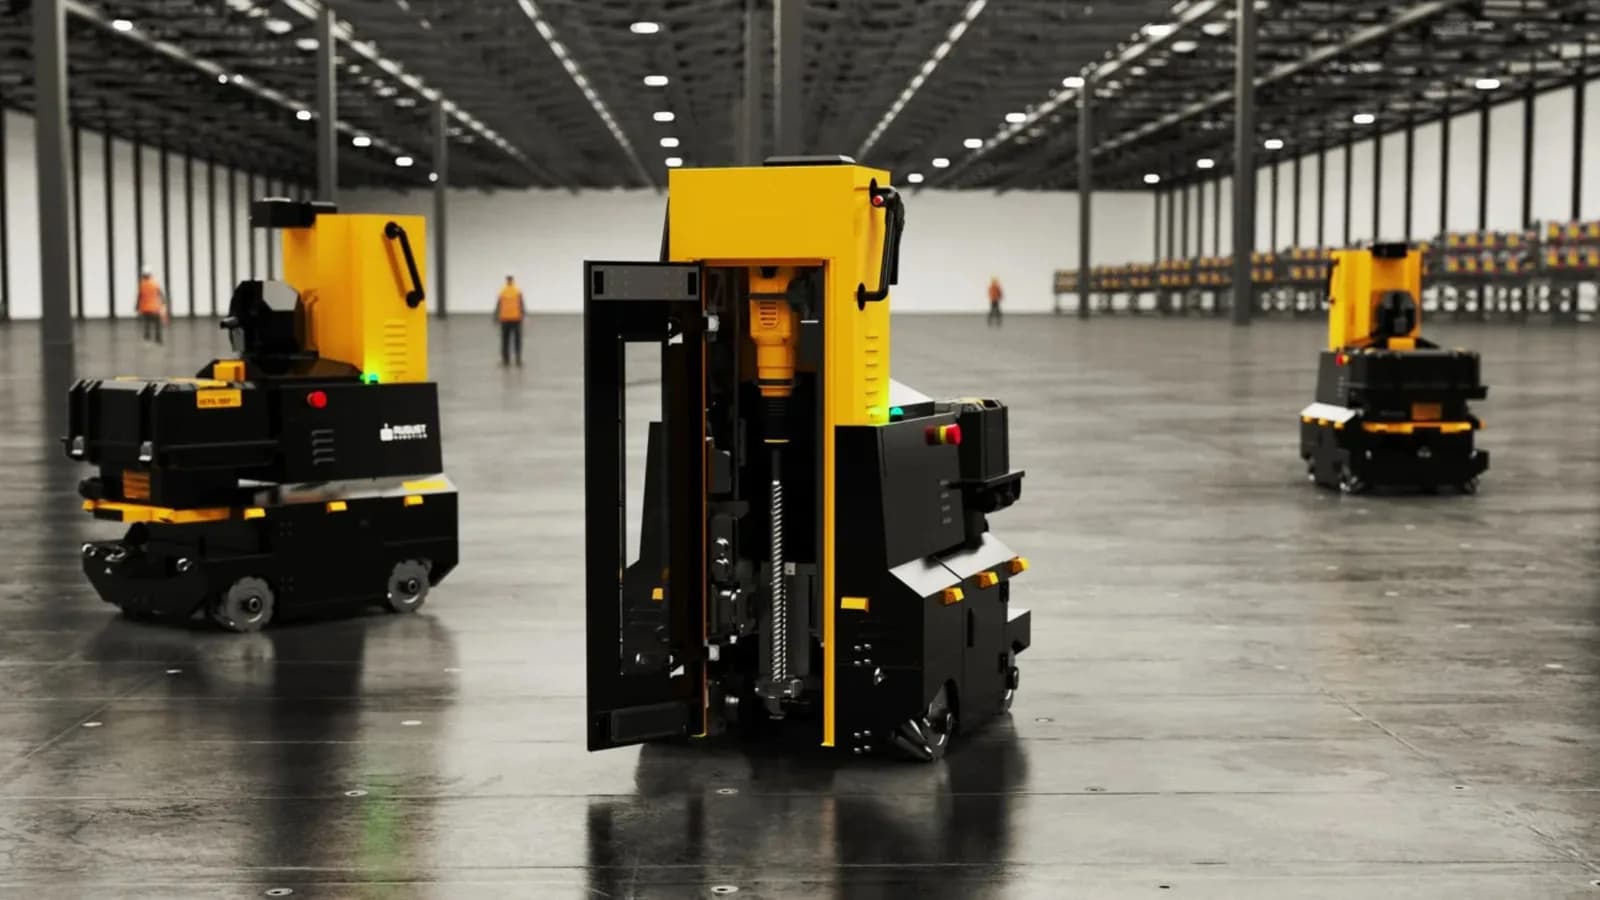
El robot, desarrollado con August Robotics para obras de centros de datos, ya hizo más de 385.000 perforaciones con más de 99% de precisión.
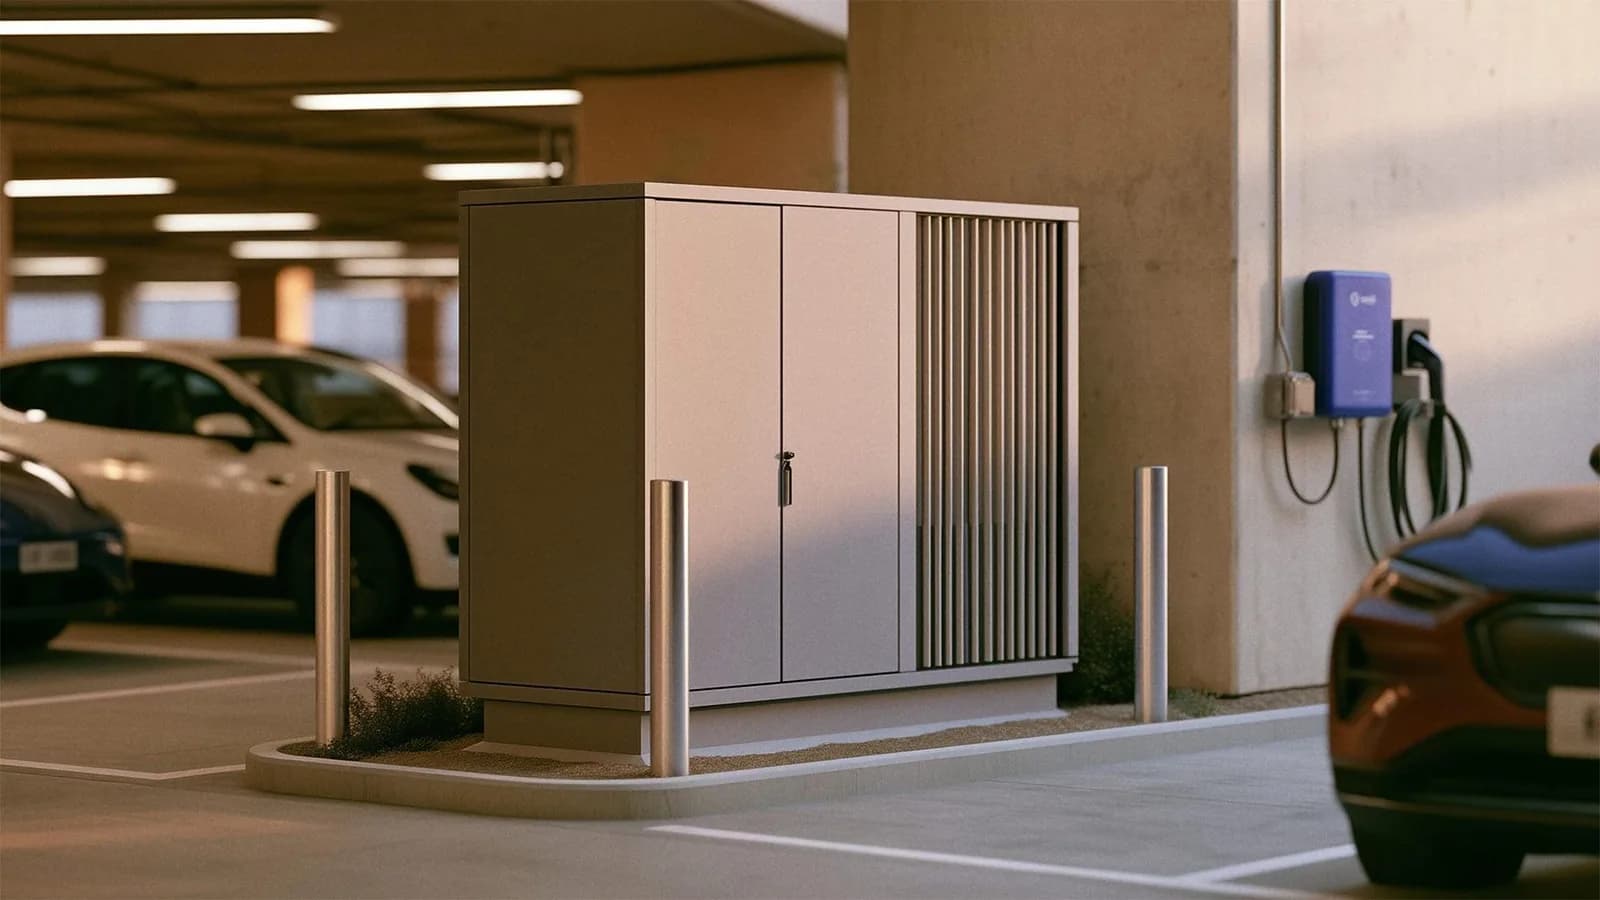
La empresa de carga de vehículos eléctricos diseñó gabinetes con hasta 48 GPU para aprovechar la potencia eléctrica que sus 1.600 estaciones no usan.
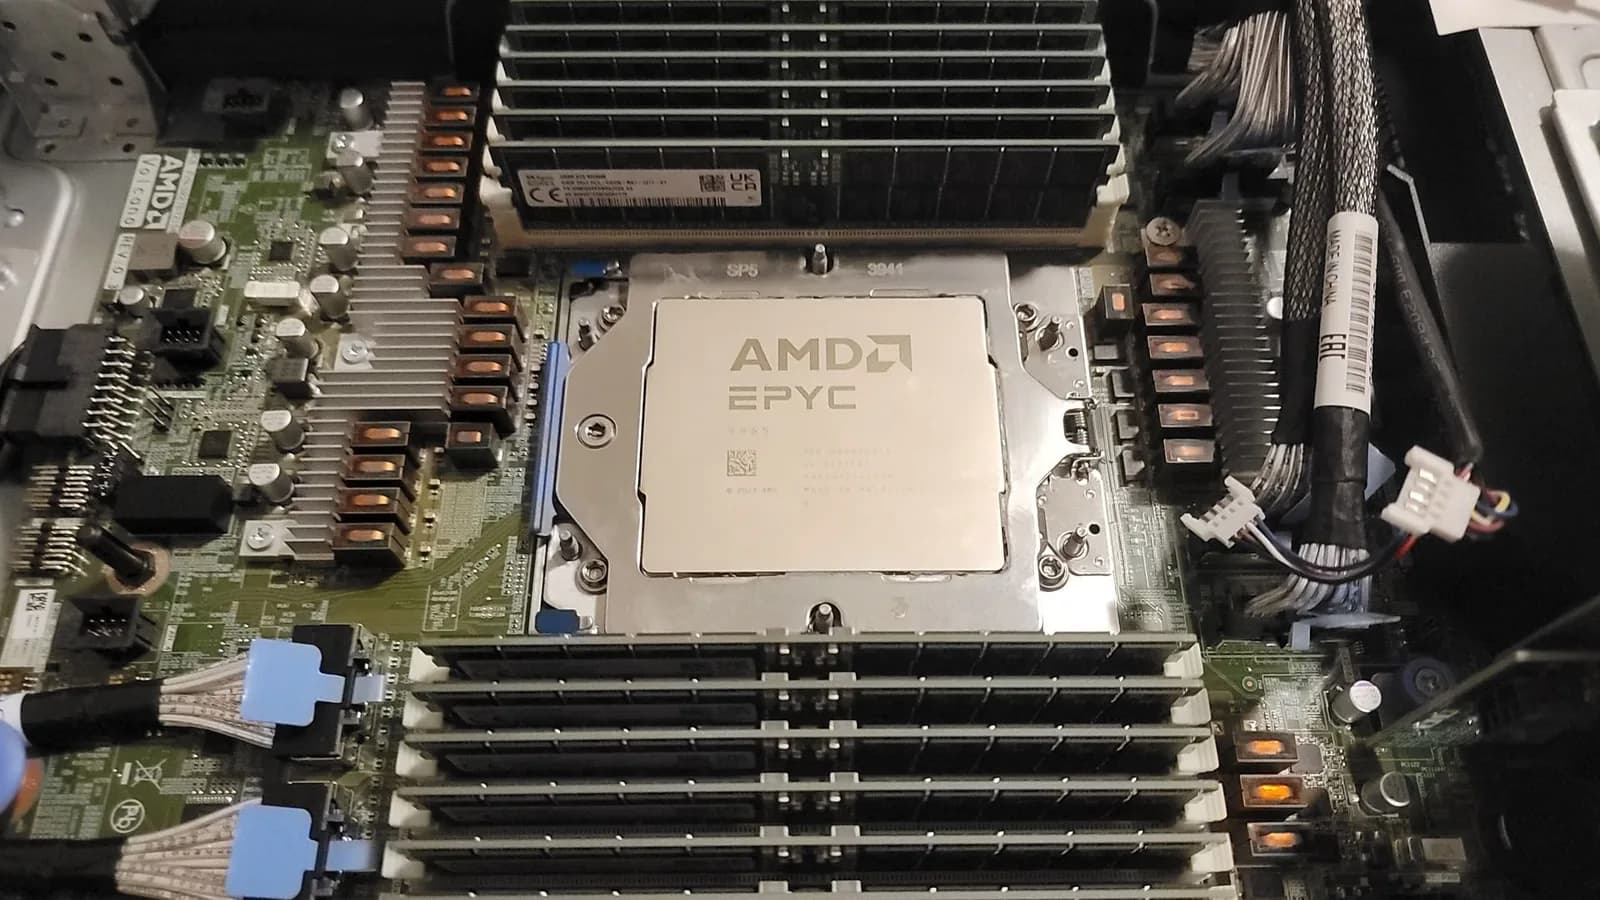
Richard Ho, jefe de hardware de OpenAI, dijo a Tom's Hardware que eligió Turin por madurez y que Vera, como CPU independiente, todavía está un poco atrás.
El prototipo lleva cuatro TPU a la órbita baja en la misión Transporter-18 de SpaceX, construido junto a Planet.
El satélite MVP del Proyecto Suncatcher despega la próxima semana en un Falcon 9 y sus chips solo aguantan unos 15 minutos antes de apagarse para enfriarse.
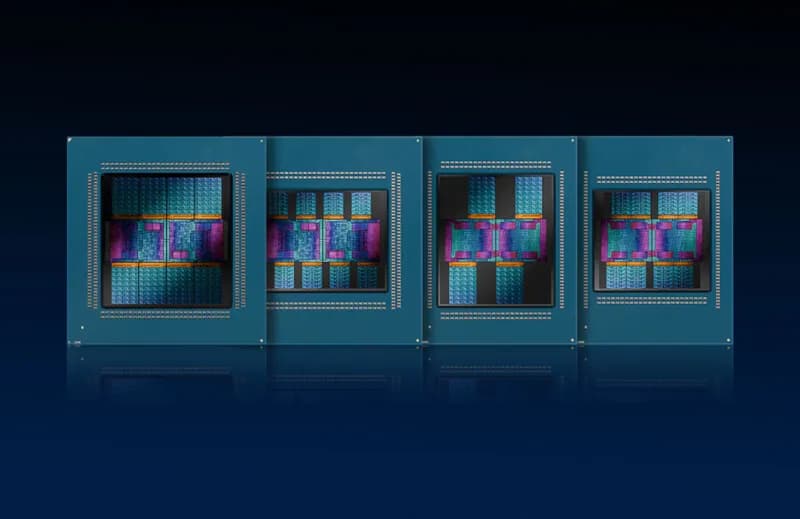
The Register reunió lo que se sabe de Zen 6 en servidores, desde el Venice de 256 núcleos hasta el Verano con LPDDR5x que AMD prepara contra Vera de Nvidia.
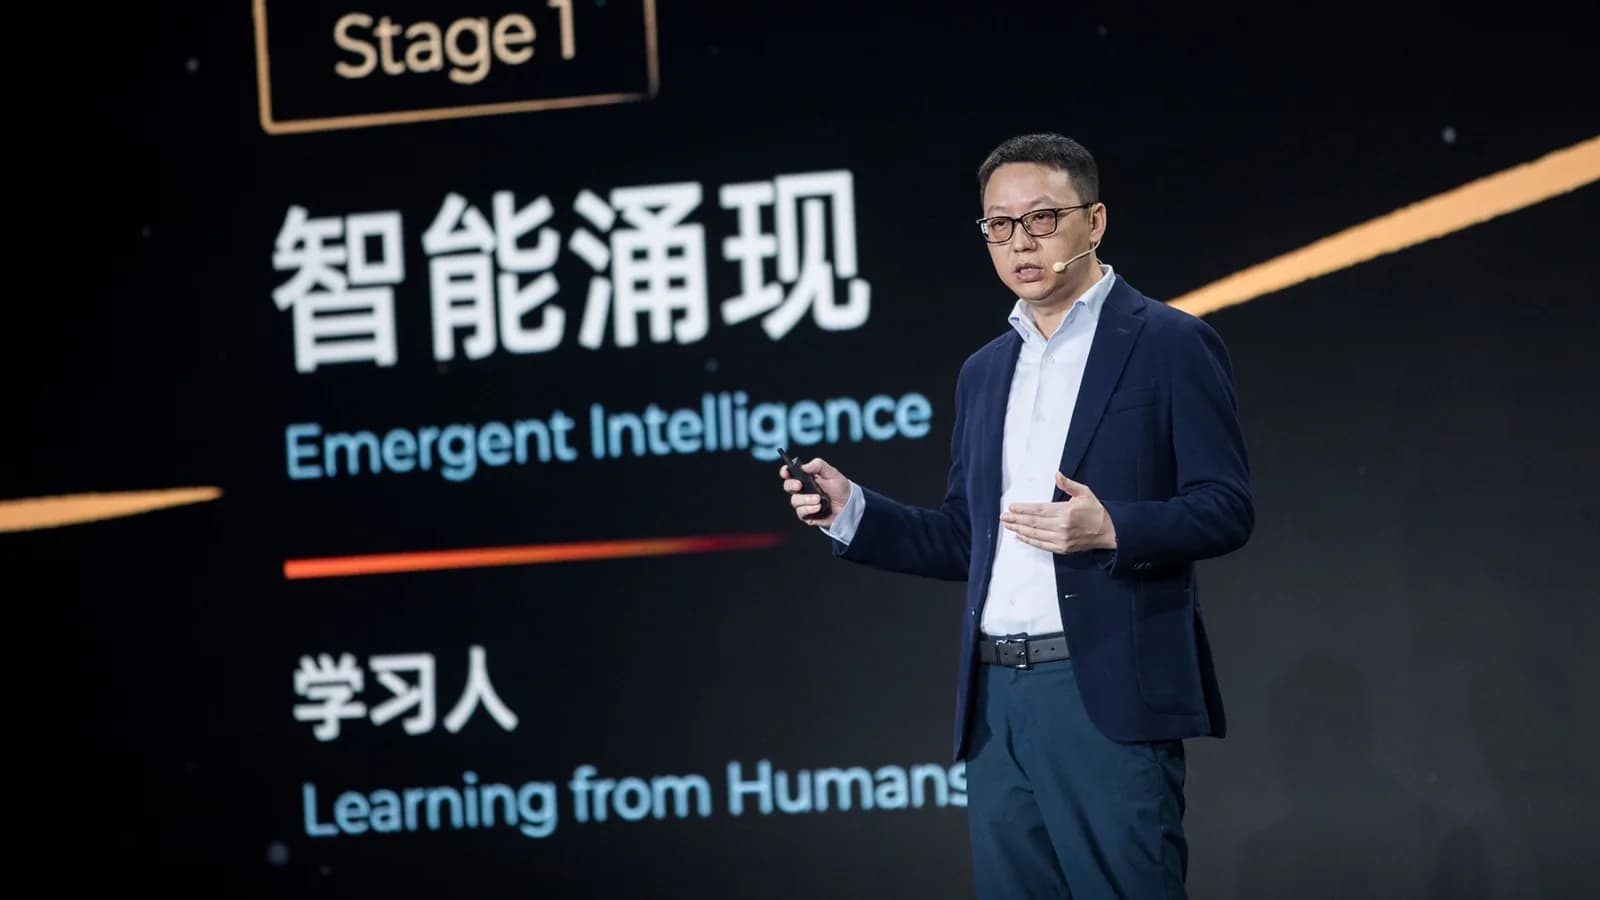
La compañía lo presentó en Hangzhou como el chip de IA más potente de China y anunció que Qwen 5 llegará con hasta 10 billones de parámetros.
El método del MIT aplica las reglas de valencia antes del paso caro de generación, que hoy se lleva cerca del 90% del costo de cómputo de crear un material usable.
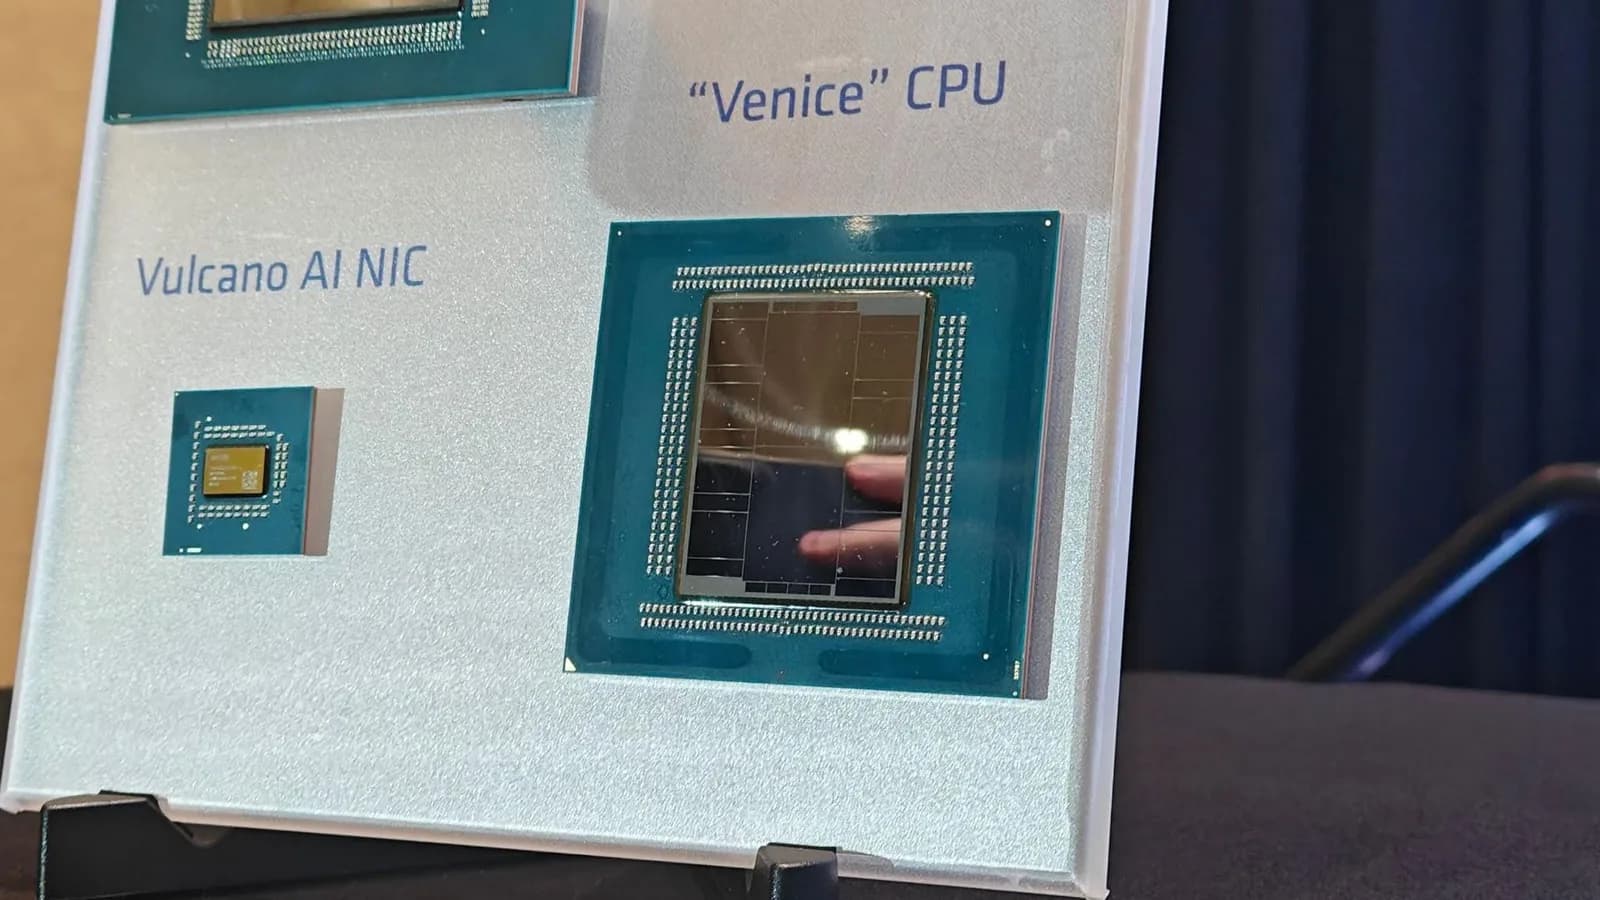
La empresa publicó un documento técnico con las mediciones de SPEC CPU 2026 y Stream, aunque compiló sus resultados con GCC 16.1 y los comparó contra los que Nvidia midió con GCC 15.2.
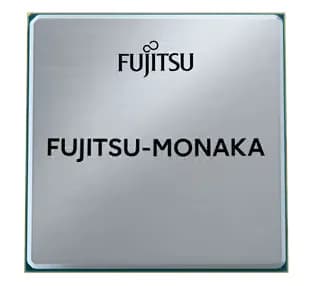
El procesador apila silicio de 2 nm para los núcleos y de 5 nm para la caché, llega en noviembre y apunta a inferencia de IA sin acelerador externo.
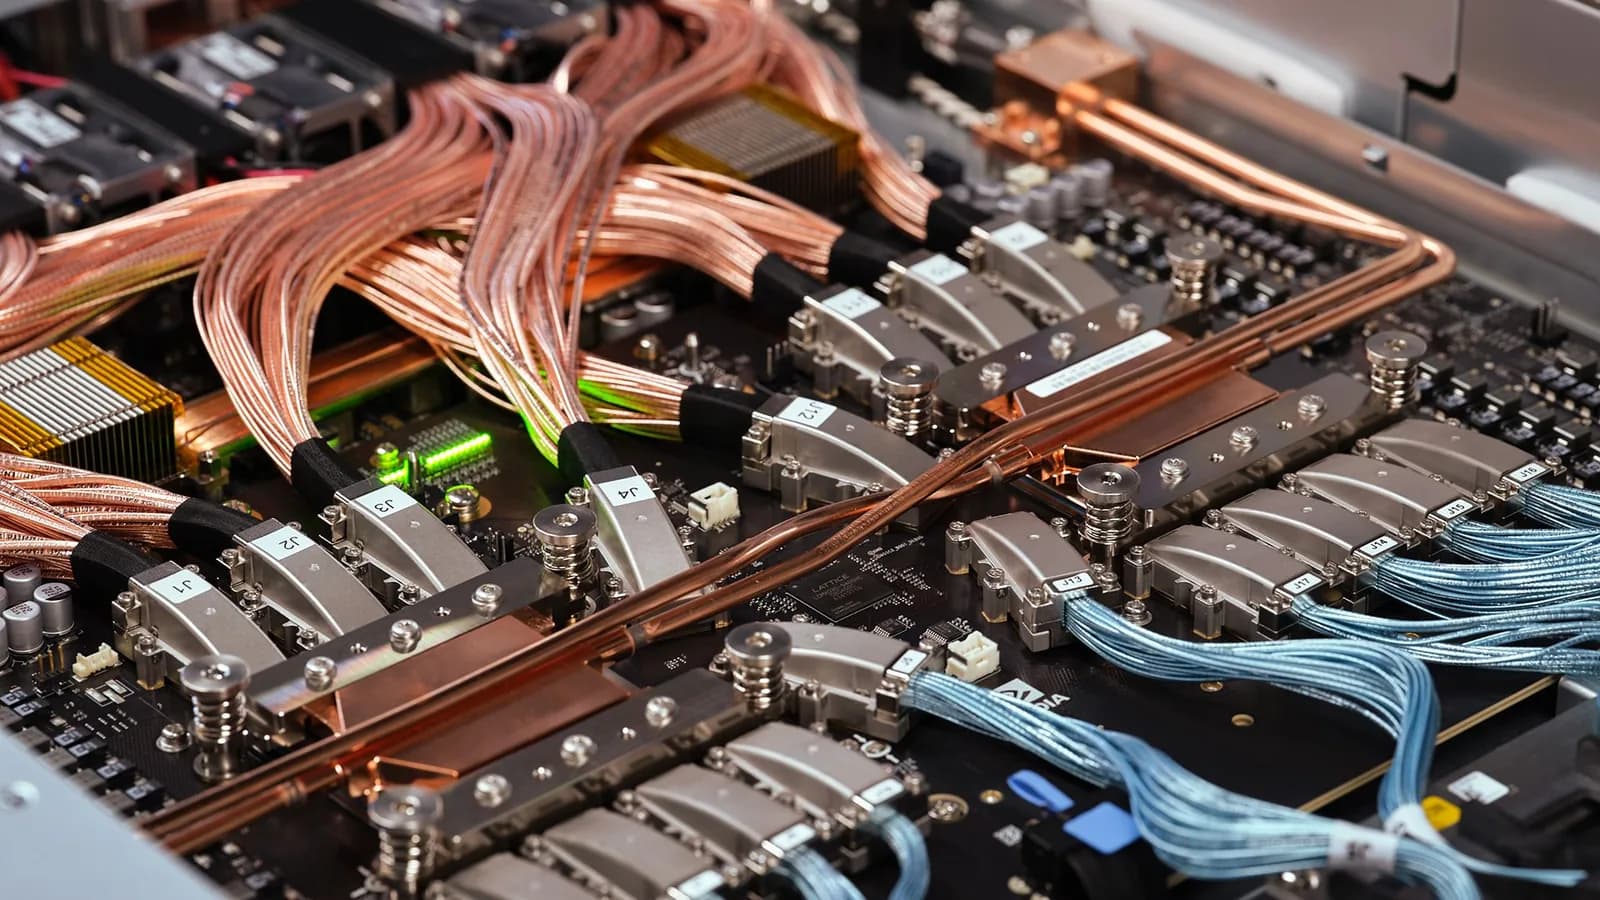
The Information reporta máquinas con dos y cuatro chips M8 Ultra para 2029, y que Apple mira la infraestructura NVLink Fusion porque su propia interconexión no le alcanza para escalar.
La medición de SemiAnalysis AgentX sobre el modelo DeepSeek V4 Pro compara el NVL72 de Vera Rubin contra el GB300 NVL72, y NVIDIA presentó el resultado en el AI Infra Summit.
El FUJITSU-MONAKA llega a 3,8 GHz, mueve memoria a 8800 MT/s y trae instrucciones de matrices para correr inferencia sin un acelerador aparte.
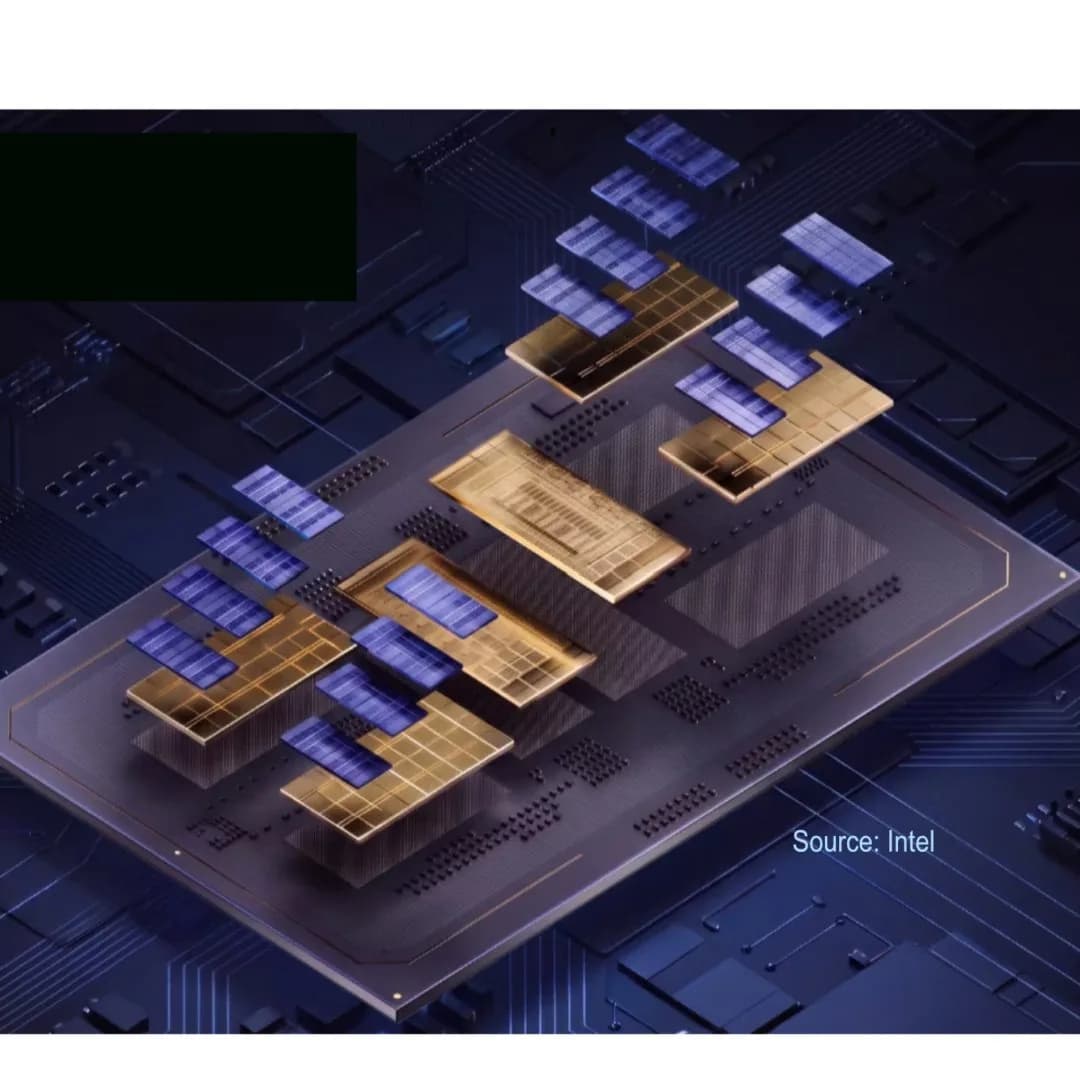
El procesador de 2 nm llevará 11 núcleos sobre 5,7 GHz que ejecutan z/Architecture y AArch64 sin emulación, y llegó junto a una tanda de anuncios ARM en la conferencia Hot Chips.
La plataforma combina celdas de titanato de litio con conversión de potencia y control en tiempo real, y se diseñó para carga y descarga continua a 10C.
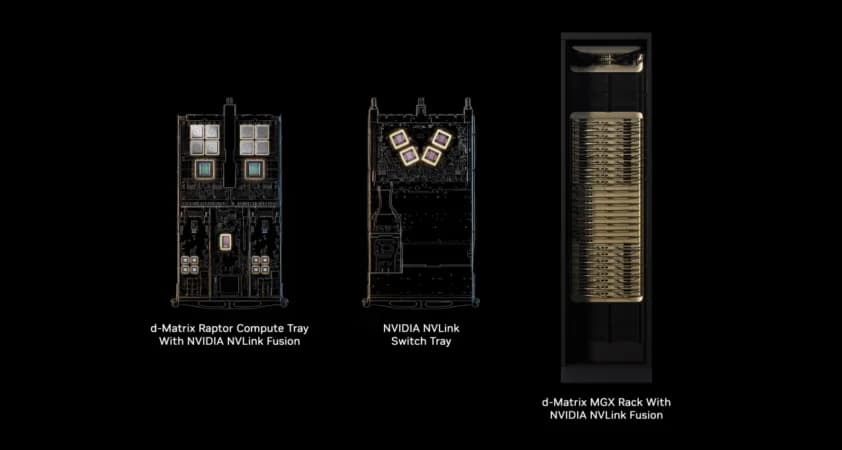
El fabricante de aceleradores de inferencia adopta la arquitectura de rack MGX en vez de construir su propia infraestructura de escala completa.
El acuerdo cubre varias generaciones de chips y suma un frente de conectividad óptica que apunta a 1,6 terabits por segundo.
Kyocera y la Universidad de Tohoku integraron un aislador óptico directamente sobre un chip de fotónica de silicio usando recocido láser, sin dañar el resto del circuito.
Una sola empresa japonesa, más conocida por los condimentos que por la microelectrónica, controla cerca del 95% de la película sobre la que se monta casi todo el silicio avanzado del planeta.
La startup de inferencia se suma a Qualcomm, Arm, Marvell, Amazon, Fujitsu y MediaTek en licenciar la interconexión de Nvidia, y renuncia a diseñar su propia red de escalado vertical.
La región argentina ofrece climas fríos, energía renovable y estabilidad, pero enfrenta desafíos críticos en infraestructura de fibra óptica y conectividad.
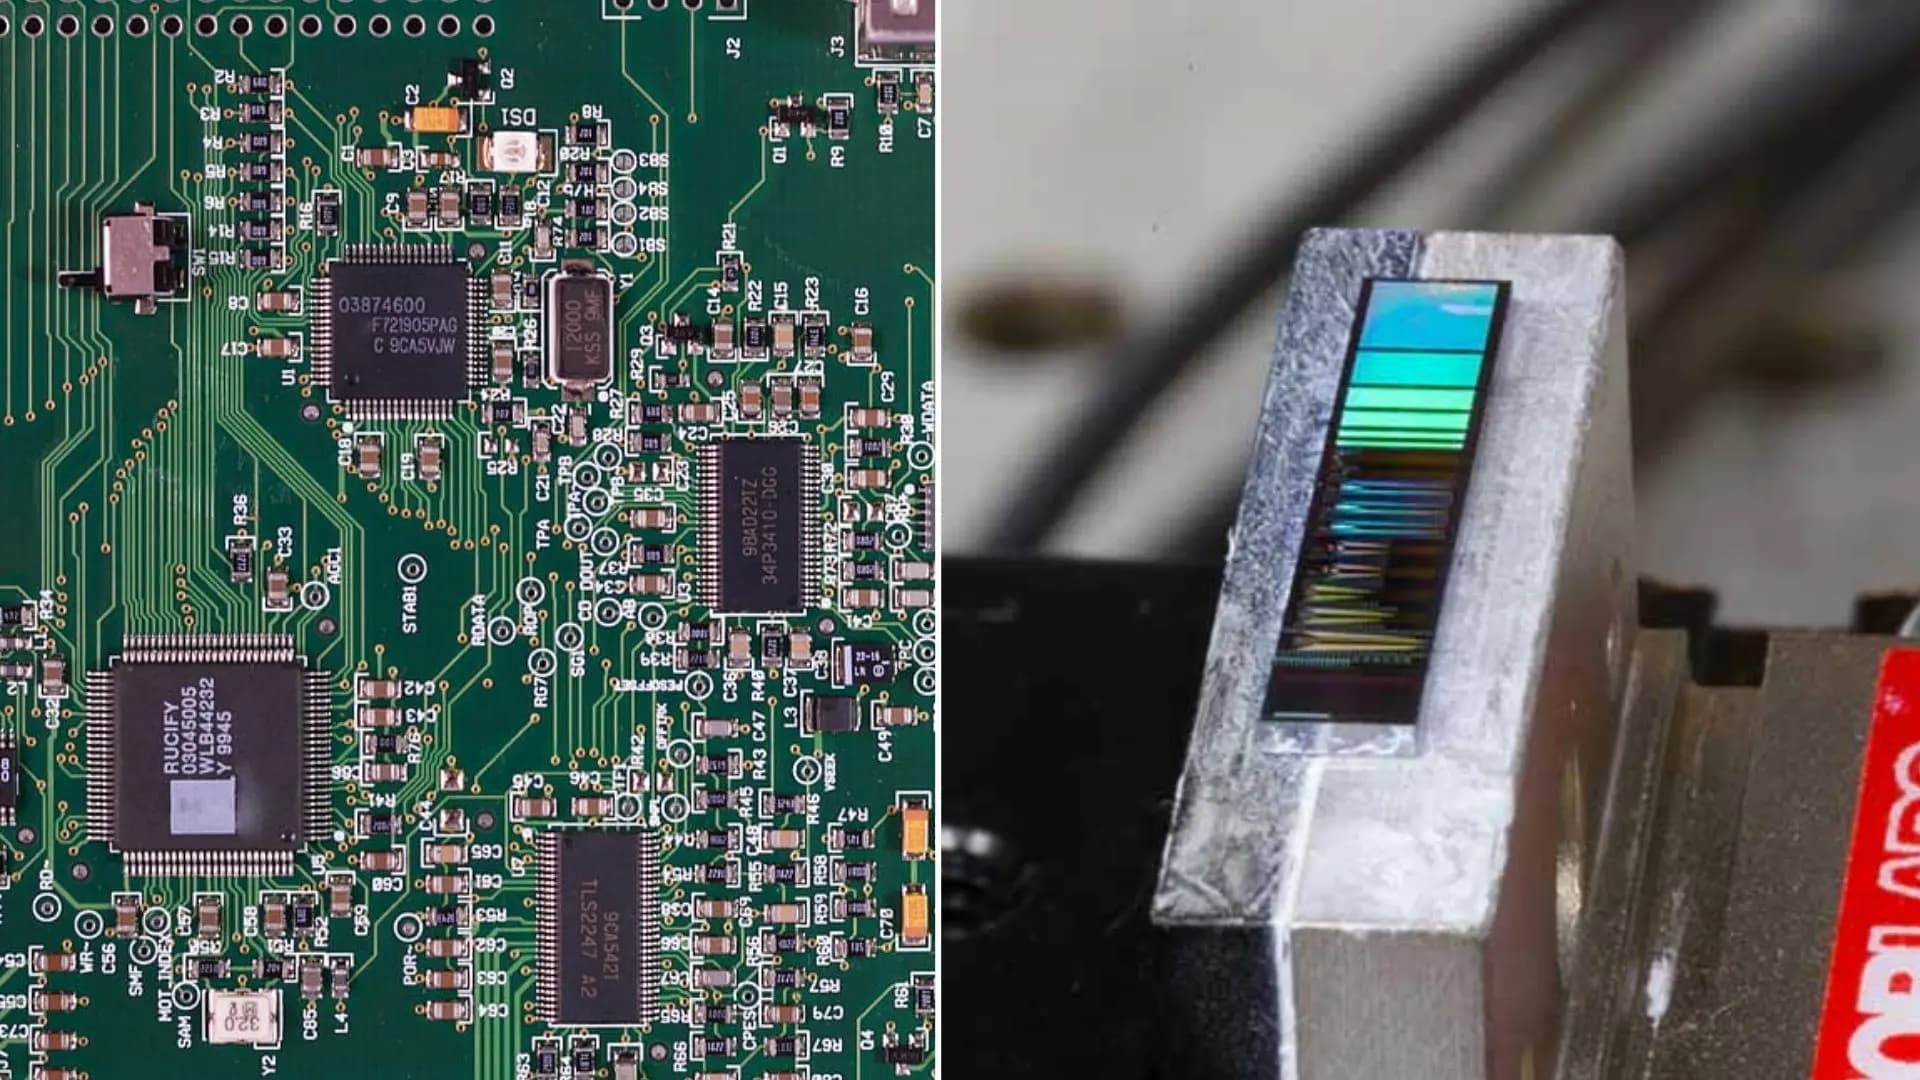
La industria converge en una arquitectura híbrida: silicio para el cálculo denso y luz para las interconexiones de alto ancho de banda que exige la inteligencia artificial.
El acuerdo cubre silicio personalizado para inferencia y óptica de 1,6 Tbps, aunque ninguna de las dos compañías entregó detalles concretos sobre los chips involucrados.
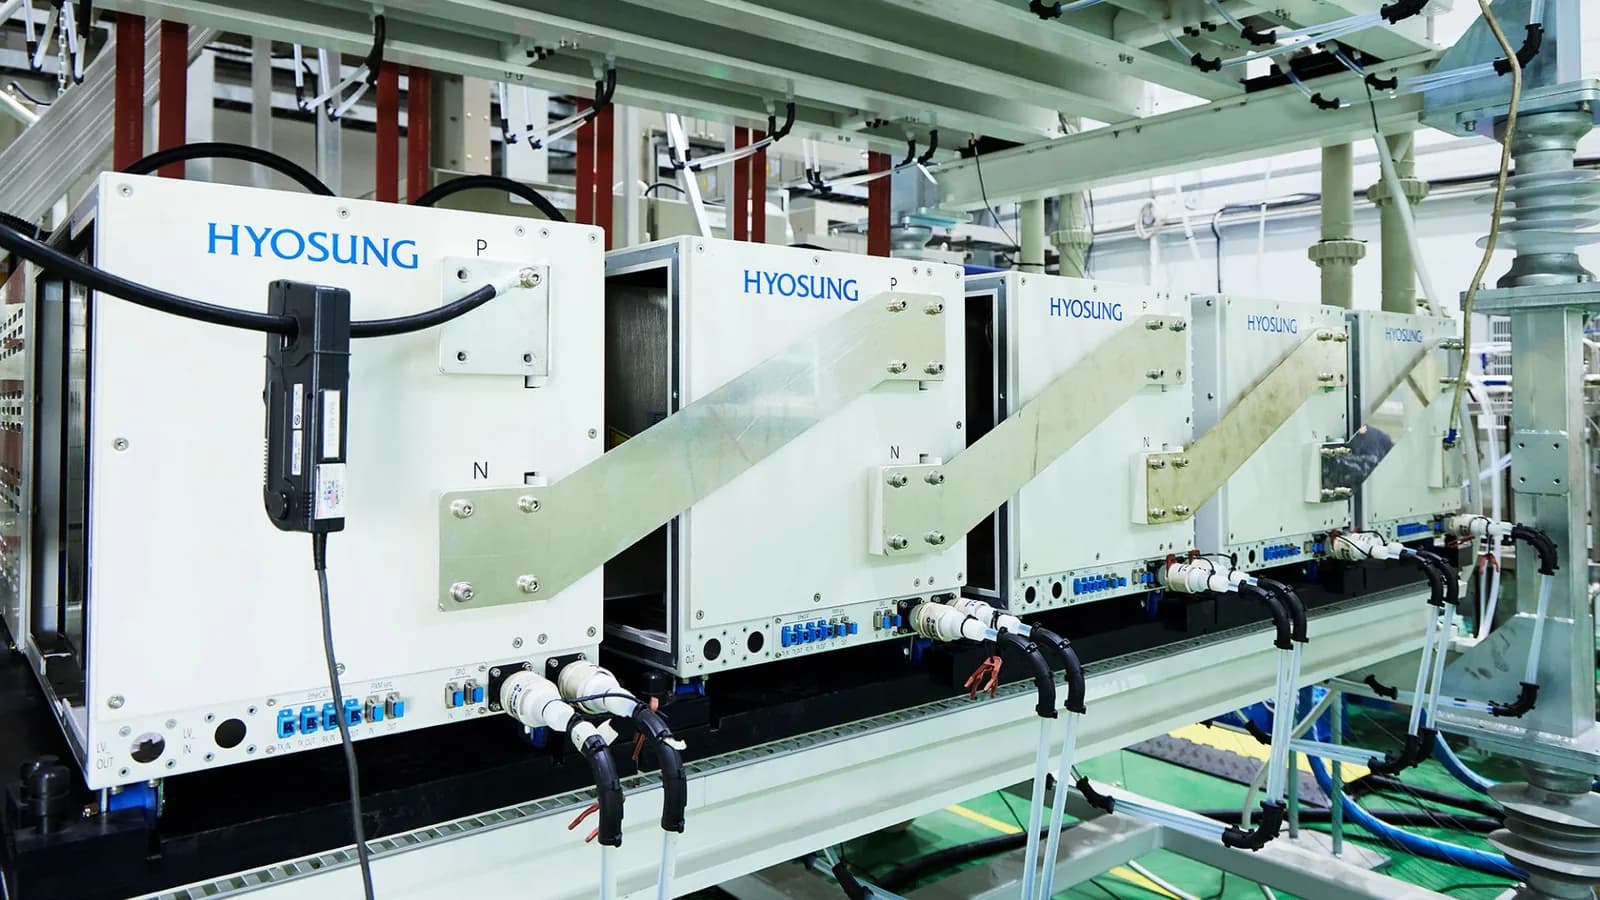
La firma coreana Hyosung Heavy Industries presentó un transformador de estado sólido de 1.05MVA, diseñado para optimizar redes eléctricas ante la alta demanda de IA.
Investigadores de Karlsruhe y Tsukuba reemplazaron el actuador eléctrico de un sistema elastocalórico por una aleación con memoria de forma que se contrae al calentarse.
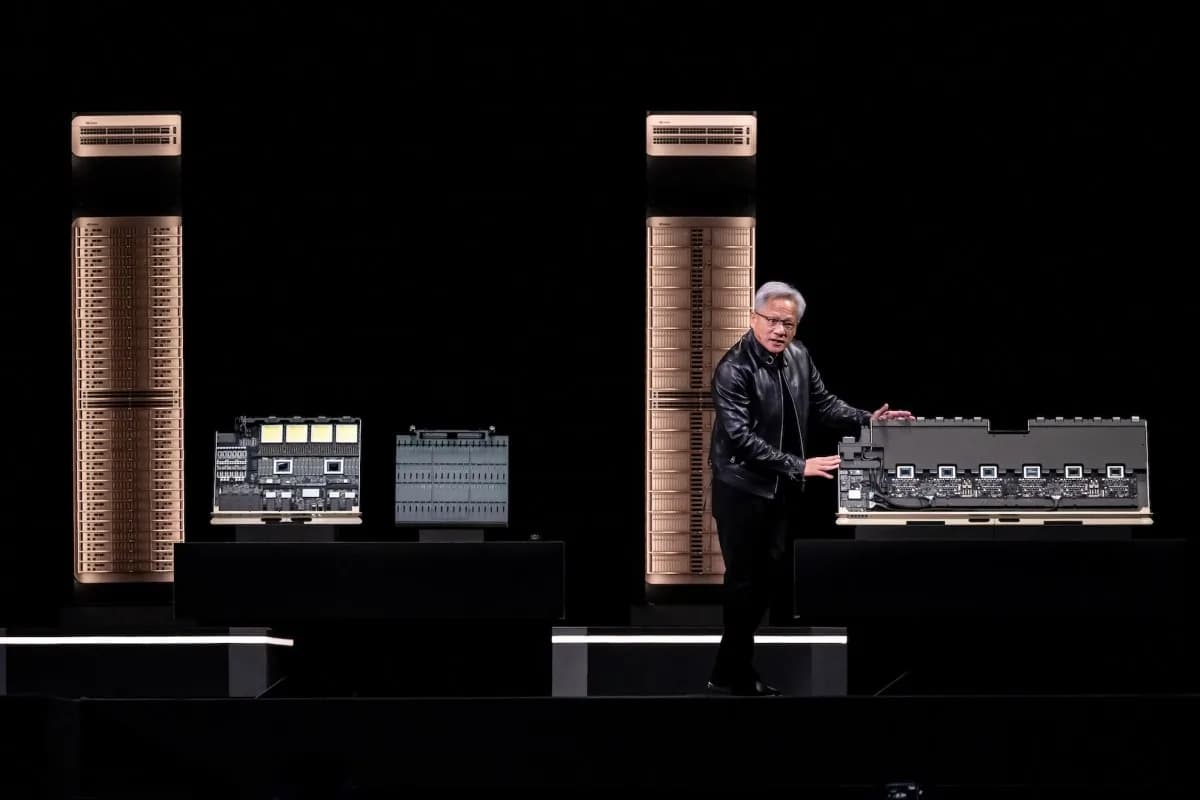
Tras los resultados trimestrales, el foco se movió a los sistemas que rodean al acelerador: la CPU Vera, el almacenamiento y la red que ordenan el tráfico en instalaciones de escala gigavatio.
La empresa ensaya brazos Kinova, máquinas de Watney y robots de ABB en sus centros de datos, y algunos trabajadores calculan que la automatización podría llevarse hasta el 80% de sus tareas.
El CPU japonés de 144 núcleos llega en 2027 con dos versiones, 350 W refrigerado por aire y 500 W por líquido, y baja sus unidades vectoriales de 512 a 256 bits.
Nvidia midió sus nuevos sistemas contra el GB300 NVL72 usando trayectorias reales de sesiones de programación con agentes, aunque los resultados todavía esperan revisión de SemiAnalysis.
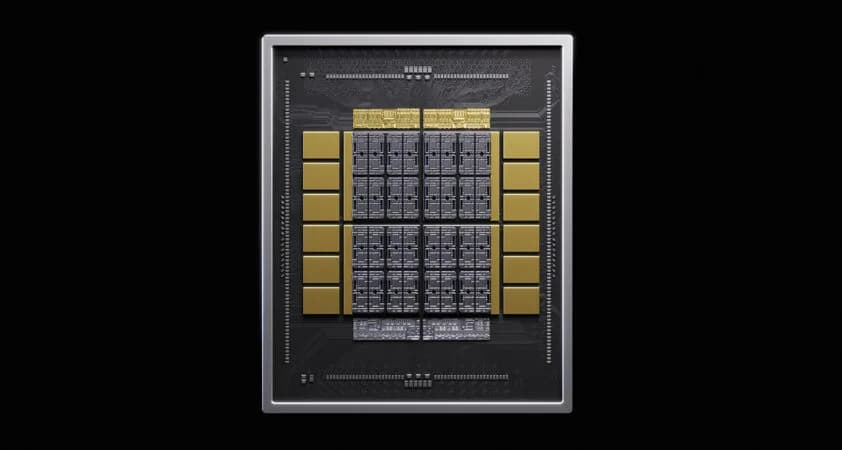
La compañía integra su controlador de memoria dentro de la pila HBM y promete 30% más ancho de banda, 15% menos consumo y 25% más área libre en el troquel de cómputo.
El procesador para servidores de IA agéntica llega con un enlace UCIe de 2 TB/s, doce canales de memoria DDR5-8800 y un consumo declarado de 300 vatios.
La Prime Enterprise RX-1600 entrega 1.600 W y llega a 95,38% de eficiencia al 20% de carga, por encima de lo que exige la certificación más alta del programa.
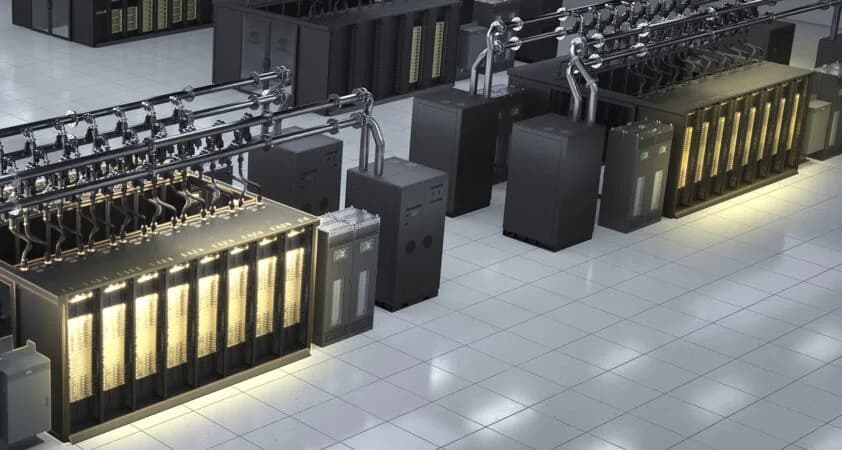
NVIDIA, Google y Microsoft empujan en la Open Compute Project una distribución en corriente continua de 800 voltios. Más de 80 fabricantes ya construyen equipos bajo esa especificación.
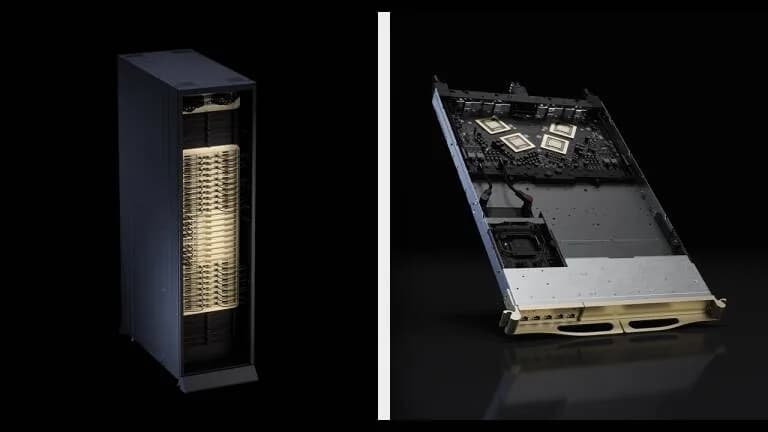
La sexta generación de la red de escalado vertical de NVIDIA promete 260 TB/s por rack y 130 TFLOPS de cómputo en red, con una mejora de 50 veces en tokens por watt entre Hopper y Blackwell.
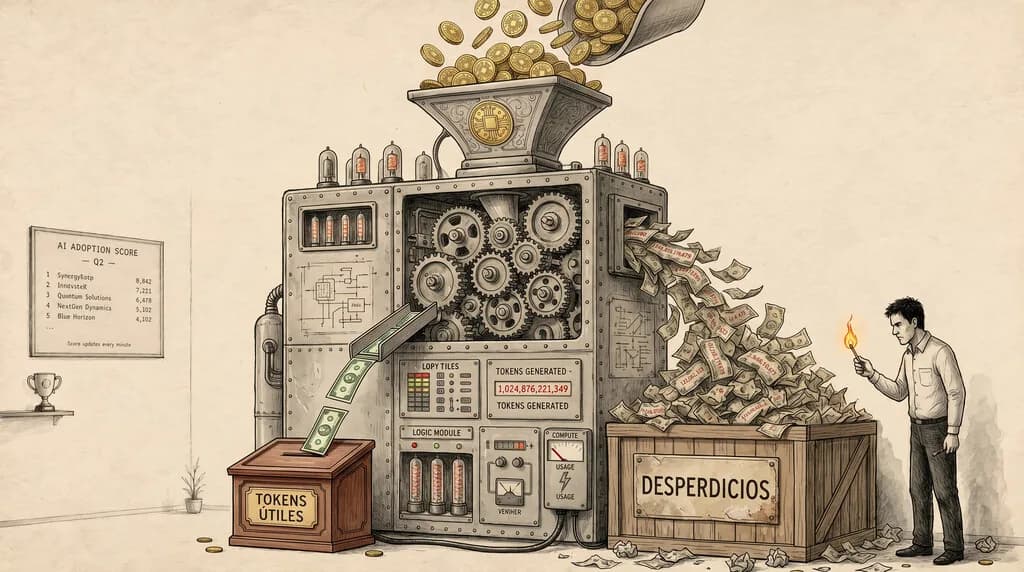
El consumo desmedido de tokens IA se ha convertido en una preocupación financiera. Las empresas buscan frenar el uso trivial para optimizar la productividad real.
Otros temas que aparecen junto a #centros de datos en nuestra cobertura editorial.