
Robótica
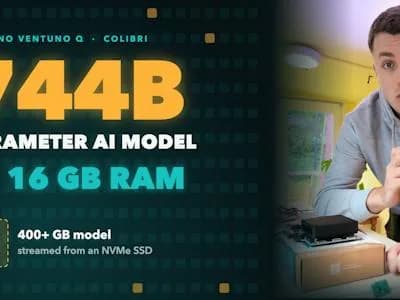
GLM-5.3 y sus 744.000 millones de parámetros corren en 16 GB de RAM
Jim Bruges carga desde un SSD solo los expertos que necesita cada token. Funciona, aunque GLM-5.3 tardó siete minutos en nombrar tres planetas.
Hackster.io
5 notas publicadas
El procesador apila silicio de 2 nm para los núcleos y de 5 nm para la caché, llega en noviembre y apunta a inferencia de IA sin acelerador externo.
El FUJITSU-MONAKA llega a 3,8 GHz, mueve memoria a 8800 MT/s y trae instrucciones de matrices para correr inferencia sin un acelerador aparte.
El paradigma de la inteligencia artificial cambia: la ejecución de modelos consume más recursos que su creación, impactando el mercado de hardware y precios.
El nuevo soporte multi-device del runtime habilita paralelismo de tensor y de contexto, y los benchmarks colocan a DeepSpeed Ulysses como la mejor estrategia para diffusion con secuencias largas.
Otros temas que aparecen junto a #inferencia ia en nuestra cobertura editorial.