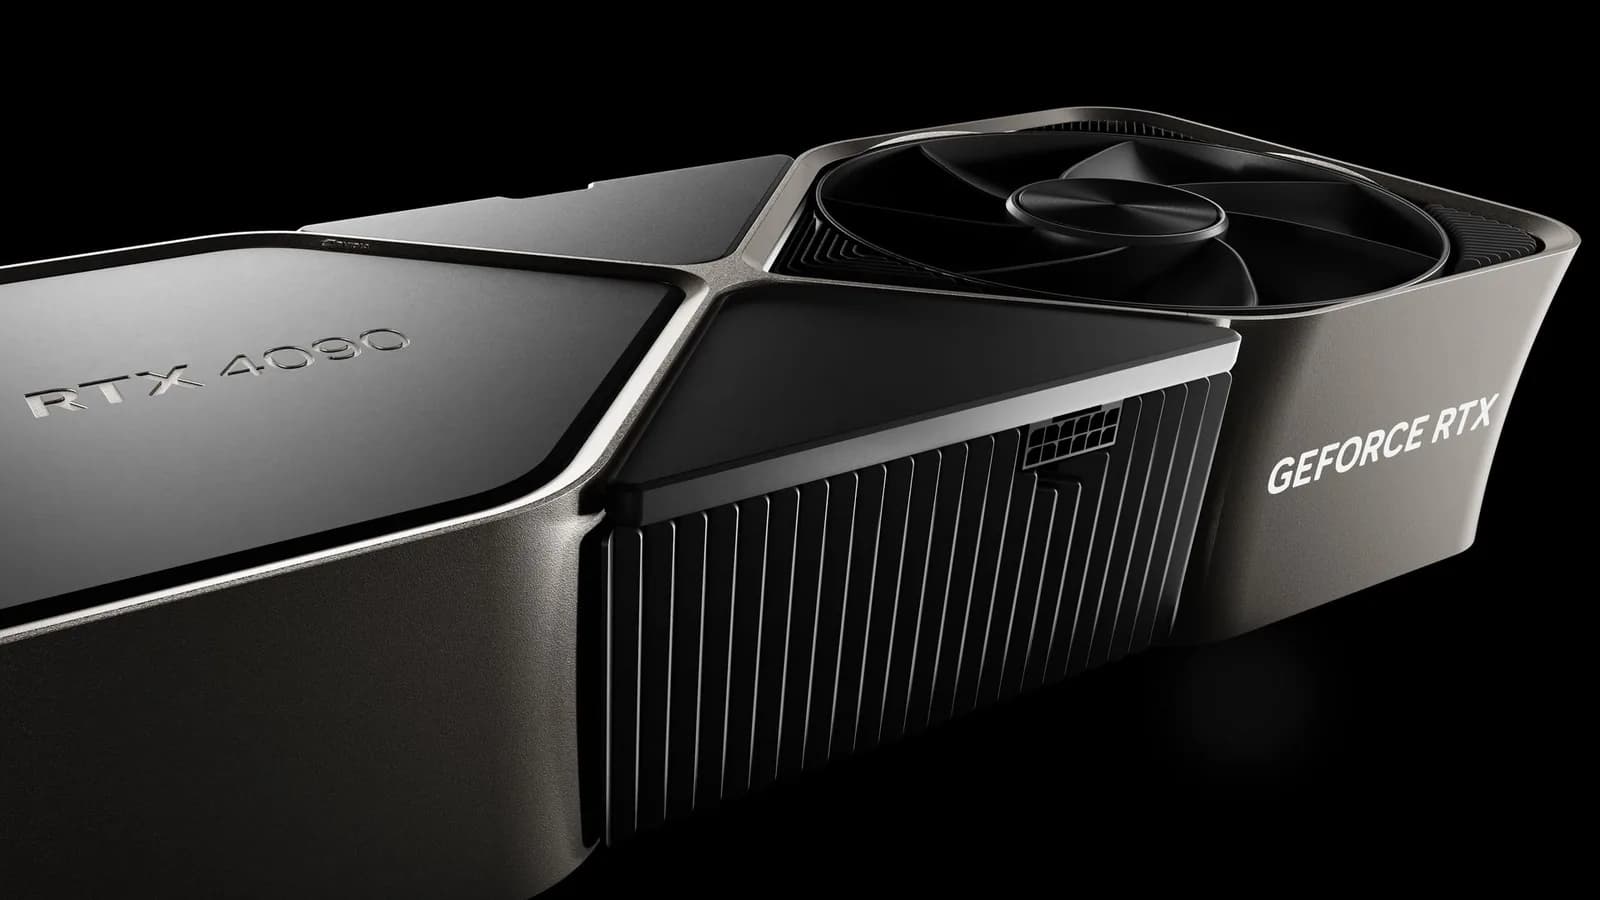
Un exploit de firmware duplica el rendimiento tensor de la RTX 4090
Tres proyectos levantan el límite que Nvidia impone a las GeForce RTX 20, 30 y 40 en matemática de matrices con acumulación FP32, con ganancias reales menores al doble.
54 notas publicadas

NVIDIA publicó una guía paso a paso con KvikIO para cargar archivos en la memoria de la GPU sin pasar por la CPU y comprobar qué ruta tomó cada lectura.

Los pedidos superan los 35.000 millones de dólares, pero NVIDIA solo podría entregar entre 5% y 10% de lo que piden, según fuentes de Reuters.

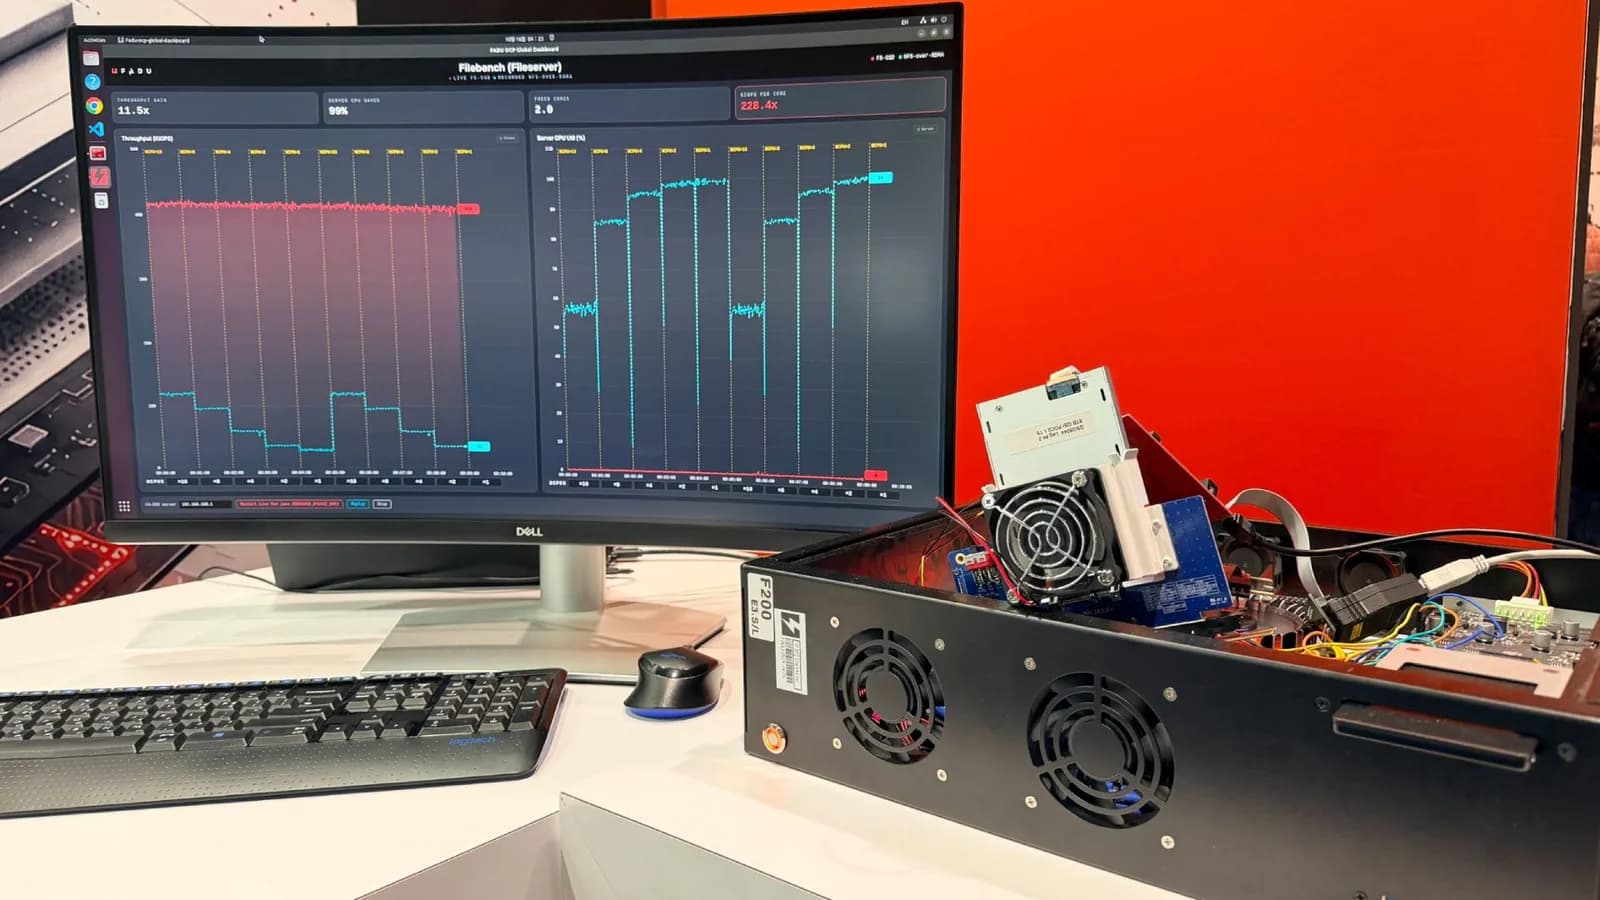
Su FS-SSD deja que GPU, DPU y tarjetas de red lean archivos sin pasar por el servidor, y en una prueba mantuvo 460.000 operaciones por segundo con un solo núcleo.

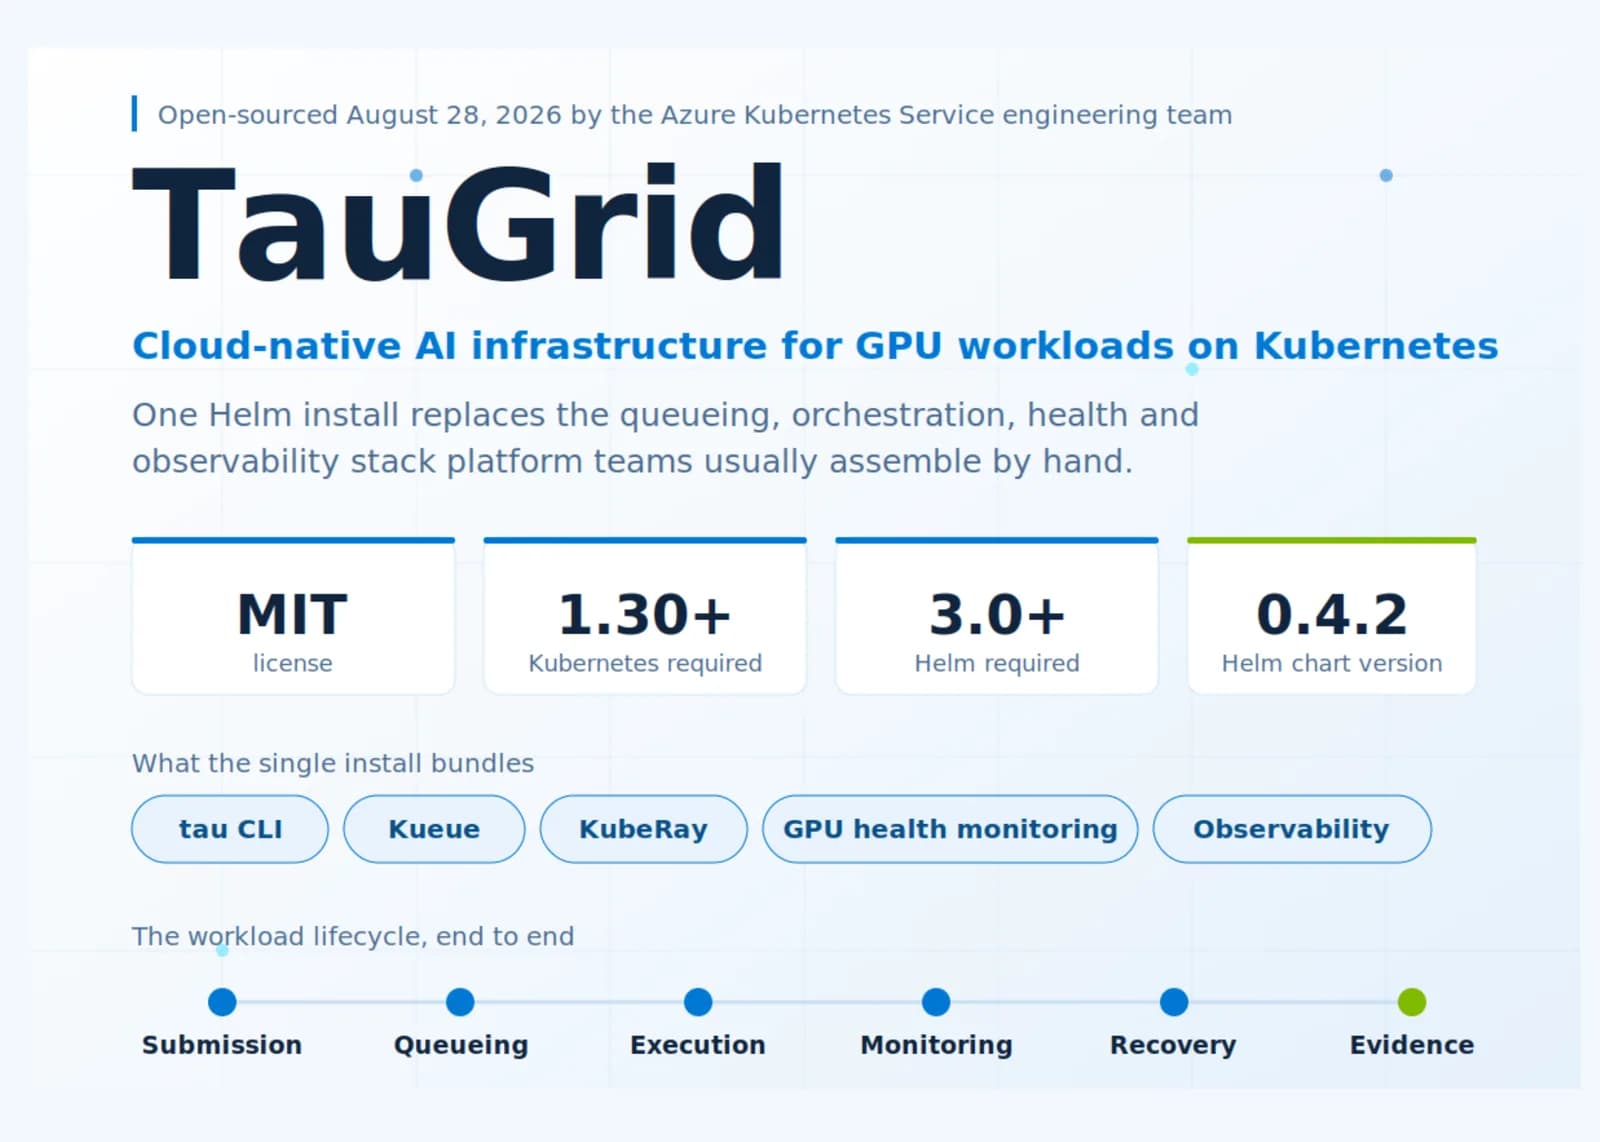
La plataforma de orquestación de GPU sobre Kubernetes queda abierta completa, junto a cuatro componentes que se pueden adoptar por separado.

Reemplaza al delegado GPU de TensorFlow Lite, funciona con OpenCL, OpenGL ES, Metal y WebGPU y se publica bajo licencia Apache 2.0.

Según el Financial Times, usan RTX 5090 y RTX Pro permitidas por los controles de exportación para cubrir un déficit de 1,5 millones de chips.

El sistema Minions reparte tareas de inferencia entre Mac con Apple Silicon y bajó esperas de más de 10 horas a minutos, según un paper de sus investigadores.

El motor de inferencia rompió la compatibilidad con torch.compile para correr más rápido en las GPU nuevas, y ahora construye un camino aparte para las viejas.

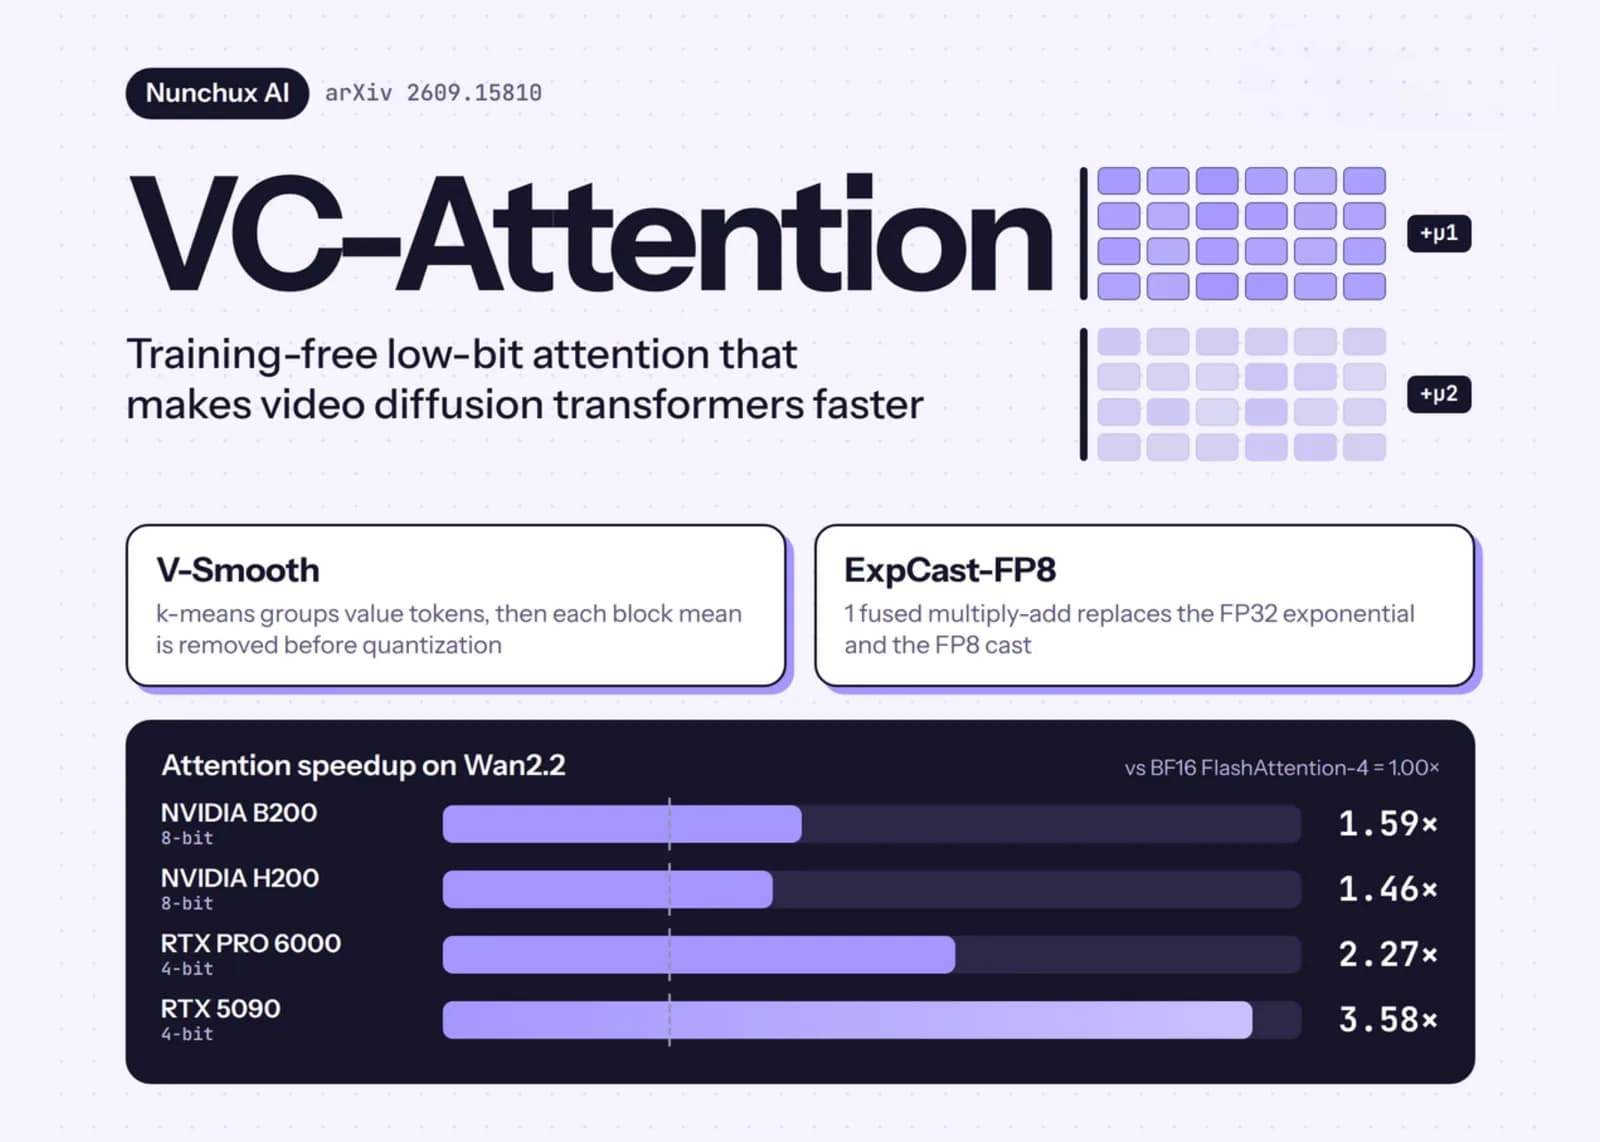
El kernel de Nunchux AI cuantiza solo el residuo de los valores y cambia la exponencial en FP32 del softmax por una multiplicación y suma fusionadas, sin entrenamiento previo.

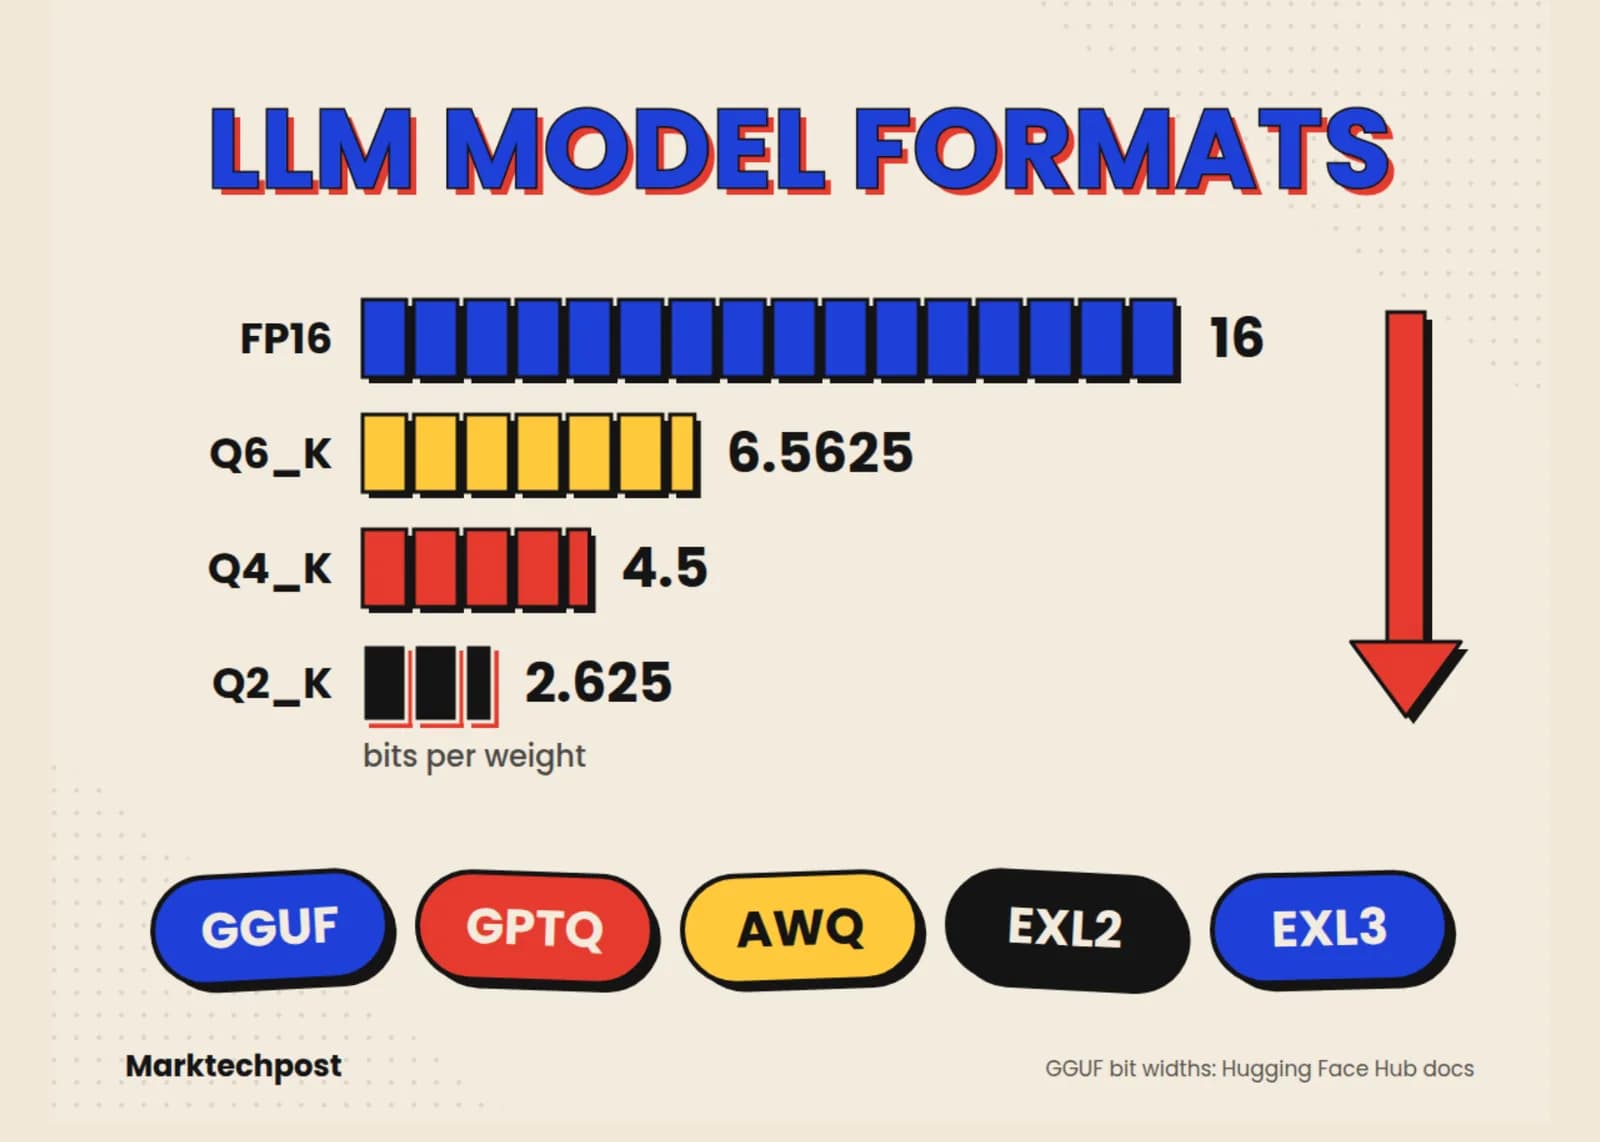
La confusión parte por mezclar dos capas distintas, el contenedor que guarda los tensores en disco y el método que aprieta los pesos a menos bits.

Un desarrollador reimplementó la red neuronal de NVIDIA con shaders de cómputo de WebGPU. Los pesos pesan 147 MB y cada cuadro tarda uno o dos segundos.

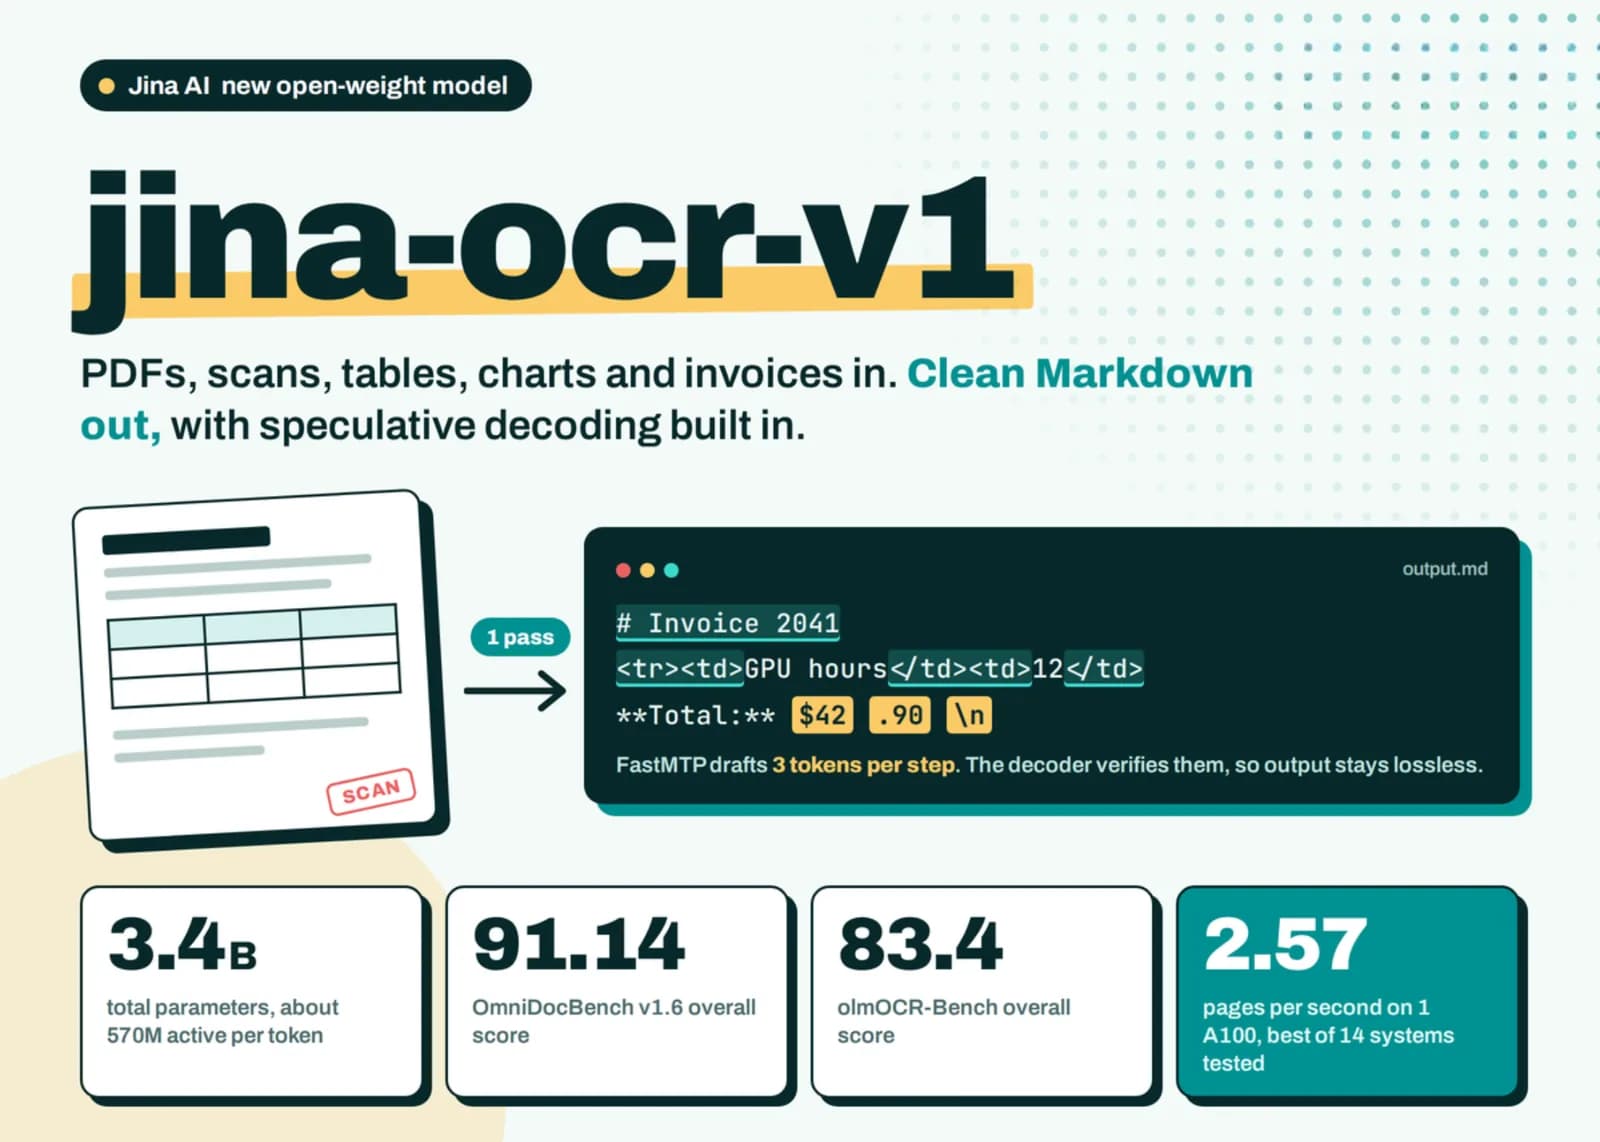
El lector de documentos tiene 3.400 millones de parámetros, activa unos 570 millones por token y trae adentro una cabeza de decodificación especulativa que casi duplica la velocidad en una NVIDIA L4.

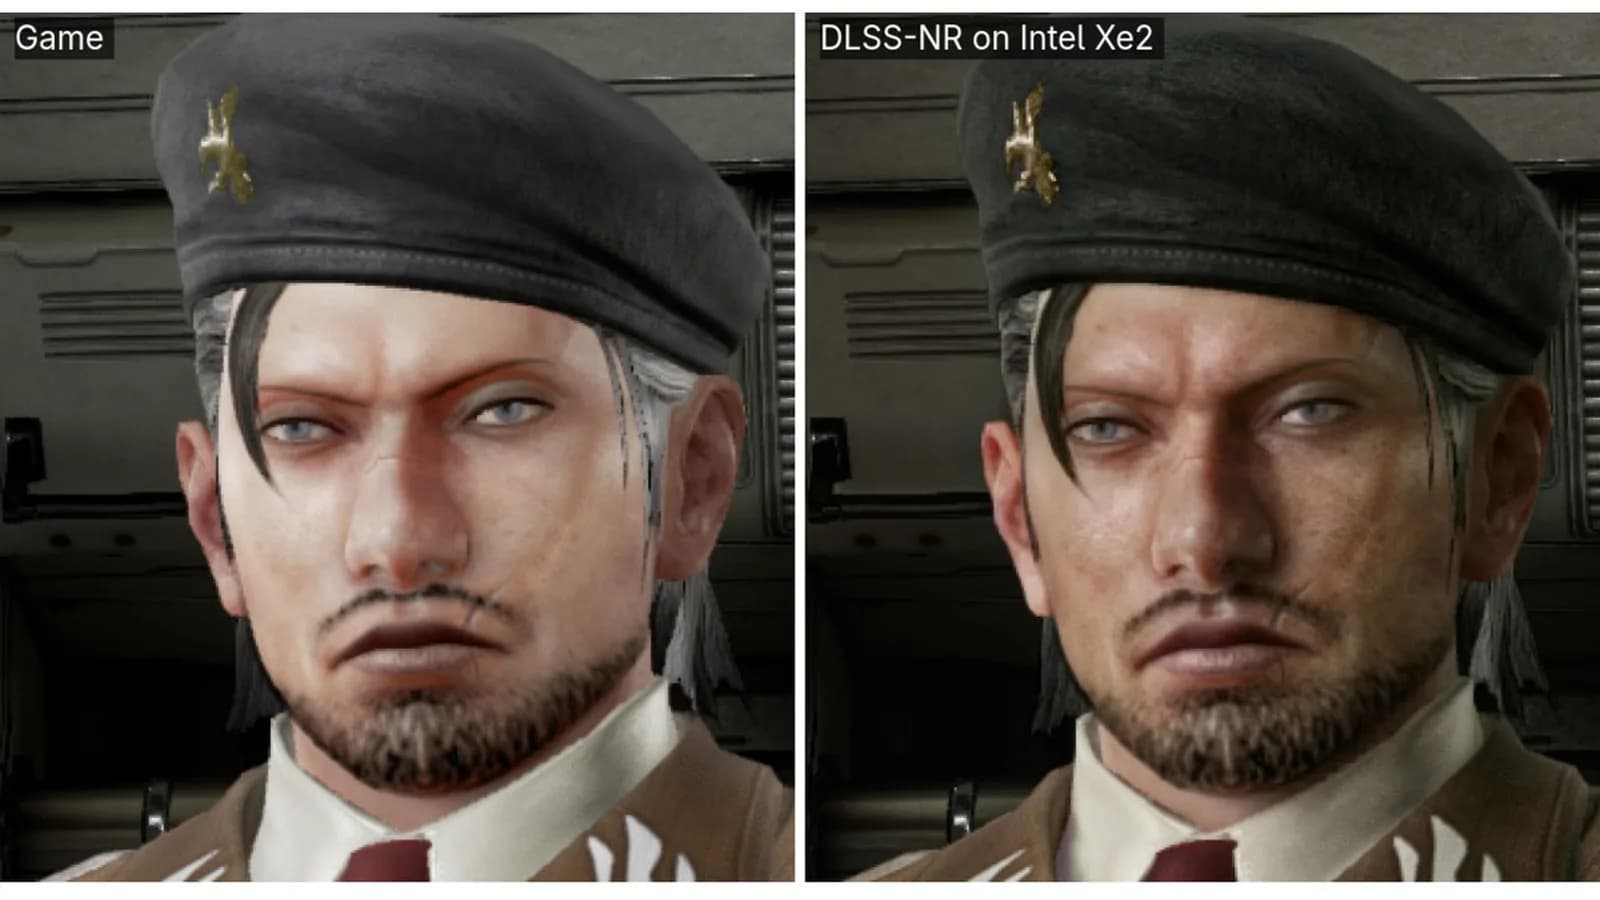
El proyecto dlss-nr-on-intel reimplementa la U-Net de 71 bloques sobre las unidades XMX de Xe2 con una extensión de Vulkan, y su autor dice que el código lo escribieron agentes de IA.

El Compute Runtime 26.35.39758.10 suma soporte inicial para PISA, la ISA portátil de Intel para GPU, que la propia Phoronix compara con el NVPTX de NVIDIA.

El equipo de Azure Kubernetes Service publicó bajo licencia MIT las cinco piezas que los equipos de plataforma solían integrar a mano para correr entrenamiento sobre Kubernetes.

Los kernels de Transformer Engine para JAX atacan los tensores irregulares del enrutamiento sin descartes, en una línea base donde la comunicación entre GPU se comía el 84% del tiempo de kernel.

Huawei, Cambricon, Moore Threads y Biren empujan procesadores propios, pero el obstáculo que ninguno ha resuelto es el entorno de software que rodea a las GPU de Nvidia.

El servidor X11 escrito desde cero en Rust ya reparte trabajo entre dos GPU y destrabó el límite que dejaba a Counter-Strike 2 en la mitad de los cuadros por segundo.

El lenguaje de dominio específico de PyTorch para escribir kernels de alto rendimiento ya se puede empaquetar, autoajustar y distribuir desde el Hub, con configuraciones preajustadas incluidas.

La desagregación encode-prefill-decode separa el encoder de visión del resto de la inferencia y rinde en cargas con muchas imágenes, pero se vuelve contraproducente con salidas largas.

La nueva versión del kit de NVIDIA extiende CUDA a Windows sobre Arm, estrena soporte preliminar para la arquitectura Rubin y renueva el control de GPU compartidas con MPS V3.

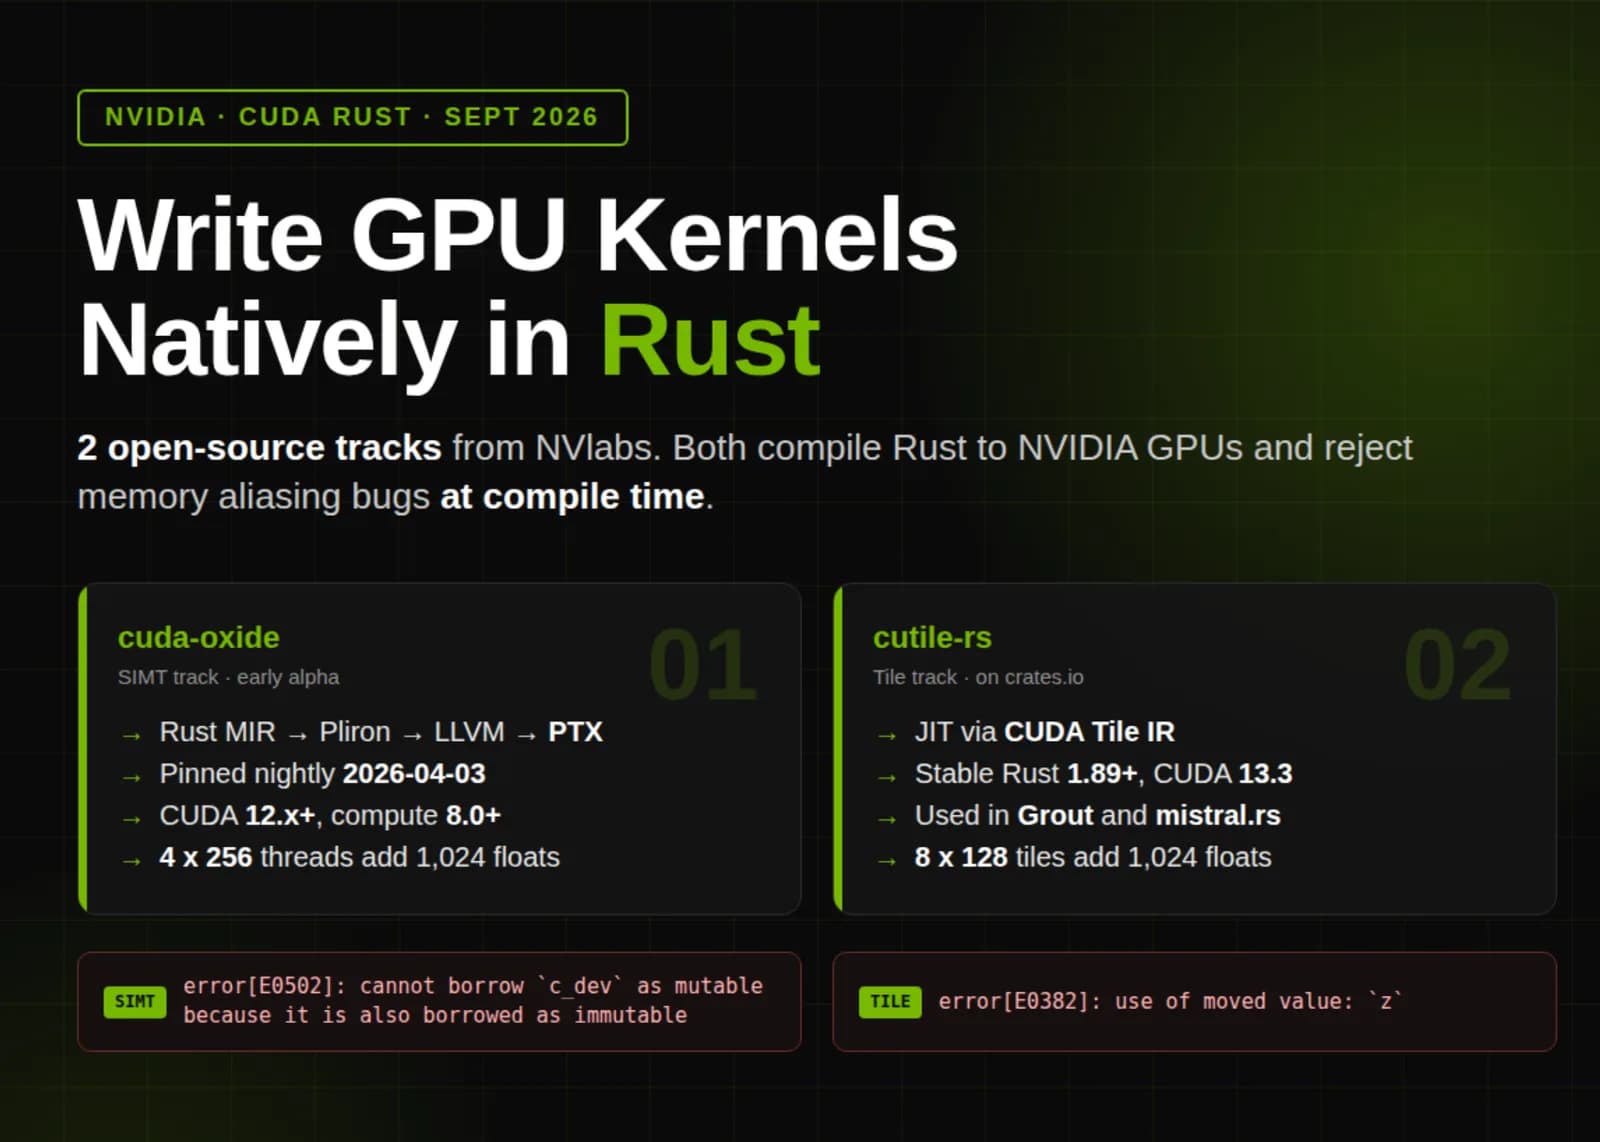
cuda-oxide compila el modelo SIMT y cutile-rs el modelo Tile, ambos apoyados en el sistema de propiedad de Rust para rechazar errores de aliasing en tiempo de compilación.

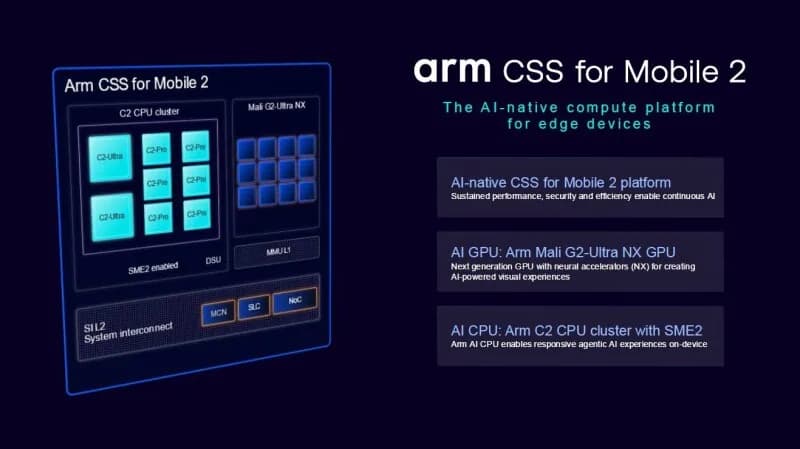
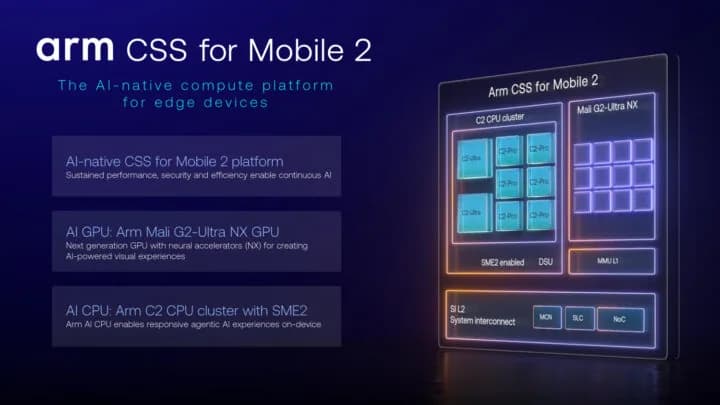
La nueva plataforma CSS para Mobile 2 busca optimizar la IA agentica y el rendimiento gráfico con un consumo energético limitado a solo 1 vatio.

NVIDIA expande su ecosistema con dos nuevas vías para escribir kernels de GPU utilizando Rust, facilitando la seguridad y el rendimiento en el desarrollo.

Arm introduce su plataforma CSS for Mobile 2, integrando los nuevos núcleos C2-Ultra, C2-Pro y la GPU Mali G2-Ultra NX con aceleración de IA nativa.

NVIDIA publica las reglas prácticas para decidir cuántos tokens adelantar y con qué mecanismo generarlos, sin perder precisión en la inferencia.

La ingeniería detrás de Perplexity explica cómo Ivy, Tulip y ROSE gestionan la carga de trabajo para sus modelos de embedding a escala web.

La herramienta, presentada en IFA 2026, manda subtareas de un agente local a los computadores de la red doméstica que tengan ciclos de GPU libres.

El objetivo abarca compiladores, entornos de ejecución, firmware y codiseño de hardware y software, con una vacante abierta que describe a Rust como dirección técnica central y no como accesorio.

La nueva herramienta de código abierto de Nvidia permite distribuir tareas de IA entre múltiples dispositivos de tu red, optimizando drásticamente los tiempos de procesamiento.

Un recorrido práctico sobre una tubería de procesamiento de imágenes que, con cambios de pocas líneas, pasa de arrastrar un error de memoria compartida a correr con flujos asincrónicos.

El Personal AI Router es software libre, funciona con GeForce RTX 20 en adelante y también con chips Apple M4, y aprovecha los equipos mientras nadie los usa.

La compañía publicó un marco de trabajo que ordena el cálculo alrededor del uso real de la carga, con cuatro escenarios de empresa y sus requisitos de memoria.

El salto de versión ordena un esquema de numeración que se había vuelto confuso y llega con la primera entrega bajo el nuevo ciclo de lanzamientos cada seis semanas.

El motor sombra de NVIDIA mantiene una réplica ya inicializada en la misma GPU y comparte los pesos en memoria, con lo que el reinicio en frío de 283 segundos se vuelve innecesario.

NVIDIA libera junto a CUDA 13.3 un conjunto oficial de bibliotecas con versionado semántico, y declara a Python un ciudadano de primera clase de su plataforma, a la par de C++.

Un experimento con 45 flujos generados por un agente de programación muestra que el detalle del prompt cambia el código y su costo, pero no la física del resultado.

La nueva actualización de la API Vulkan introduce la extensión VK_EXT_cooperative_matrix_maintenance1, optimizando el rendimiento en machine learning e inferencia.

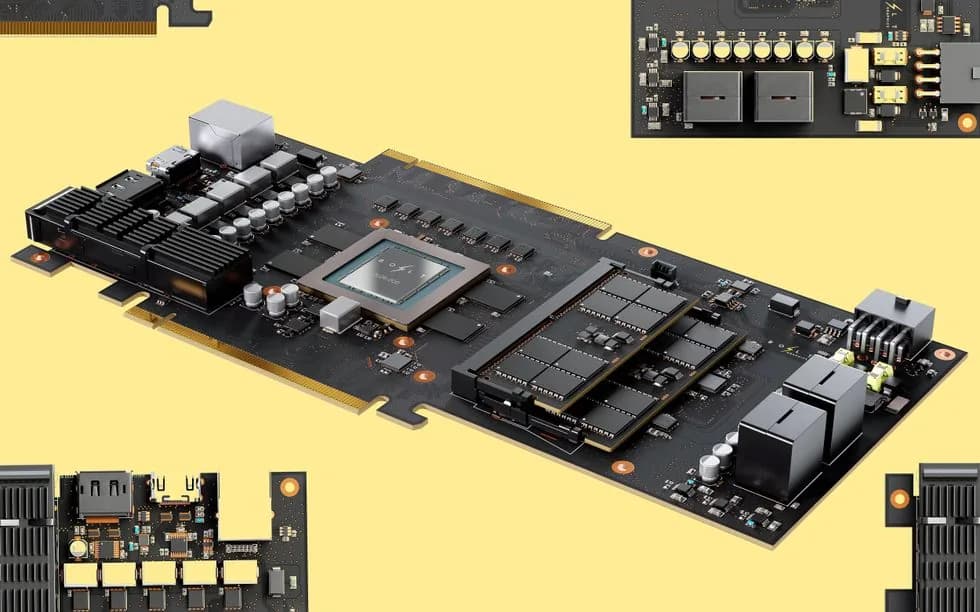
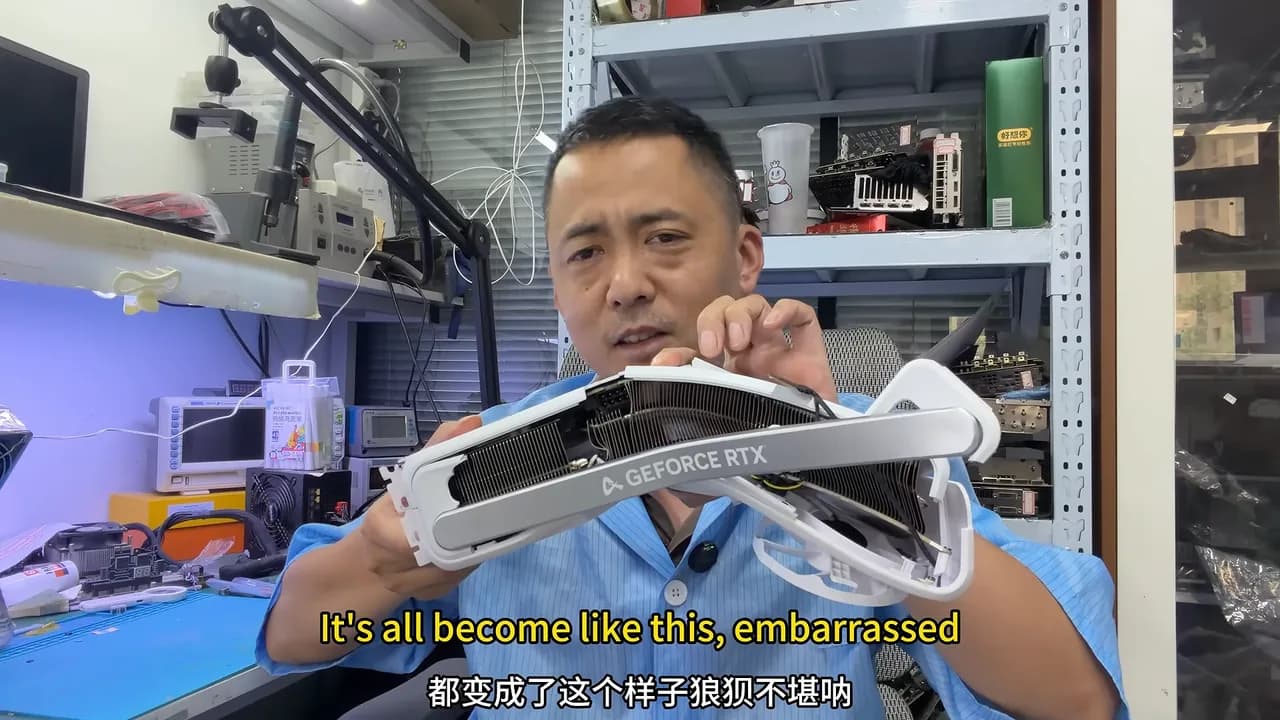
El PCB corto de esta variante apenas alcanzó el punto de curvatura y salvó al núcleo, así que toda la reparación se redujo a resoldar un único módulo de memoria.

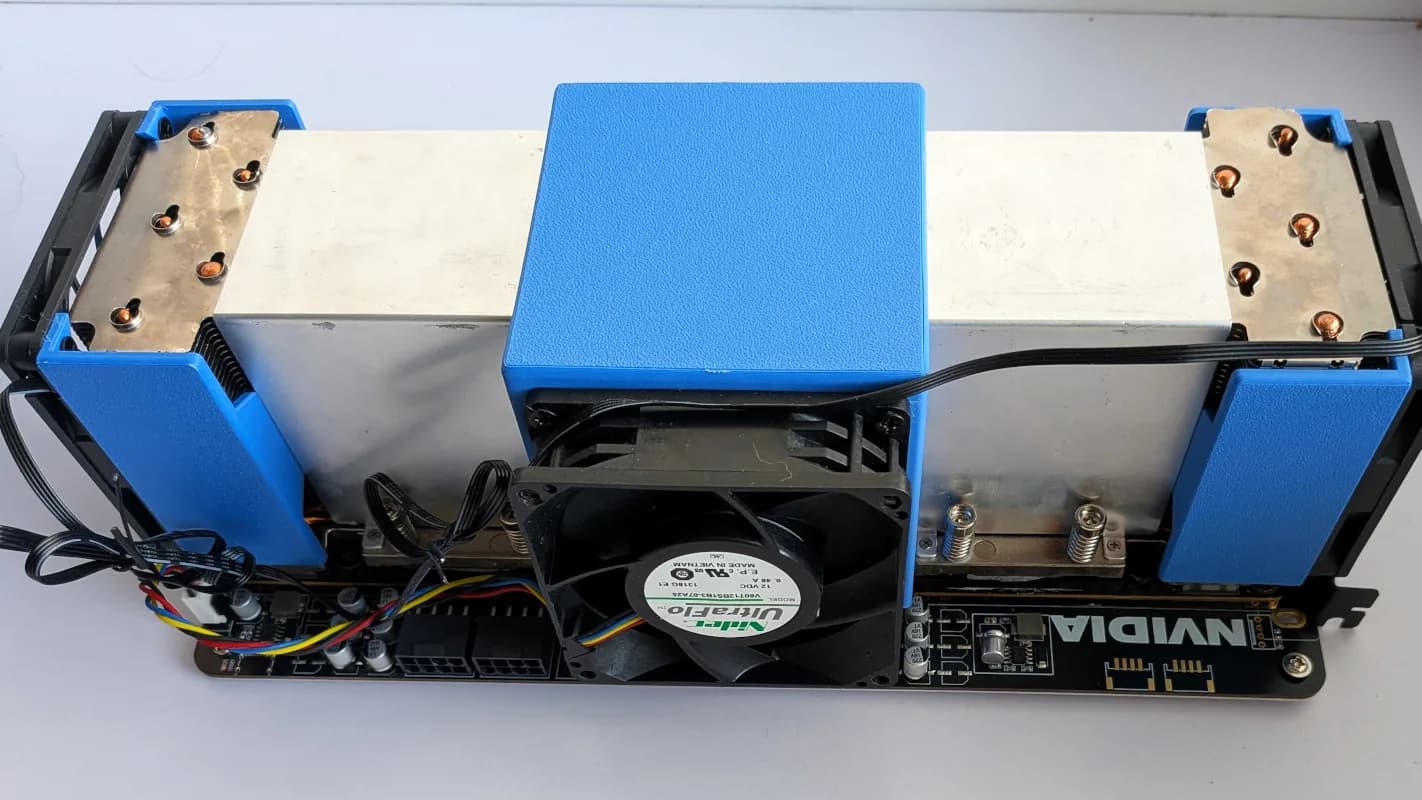
Andrew rescató tarjetas Tesla V100 de 2017 del mercado de segunda mano y armó una placa PCI para dos GPUs, capaz de correr modelos como Gemma 4 26B y Qwen3 35B por completo en memoria.

Aprende a integrar herramientas de verificación de errores y depuración en tiempo real para optimizar el rendimiento de tus aplicaciones de trazado de rayos en la GPU.

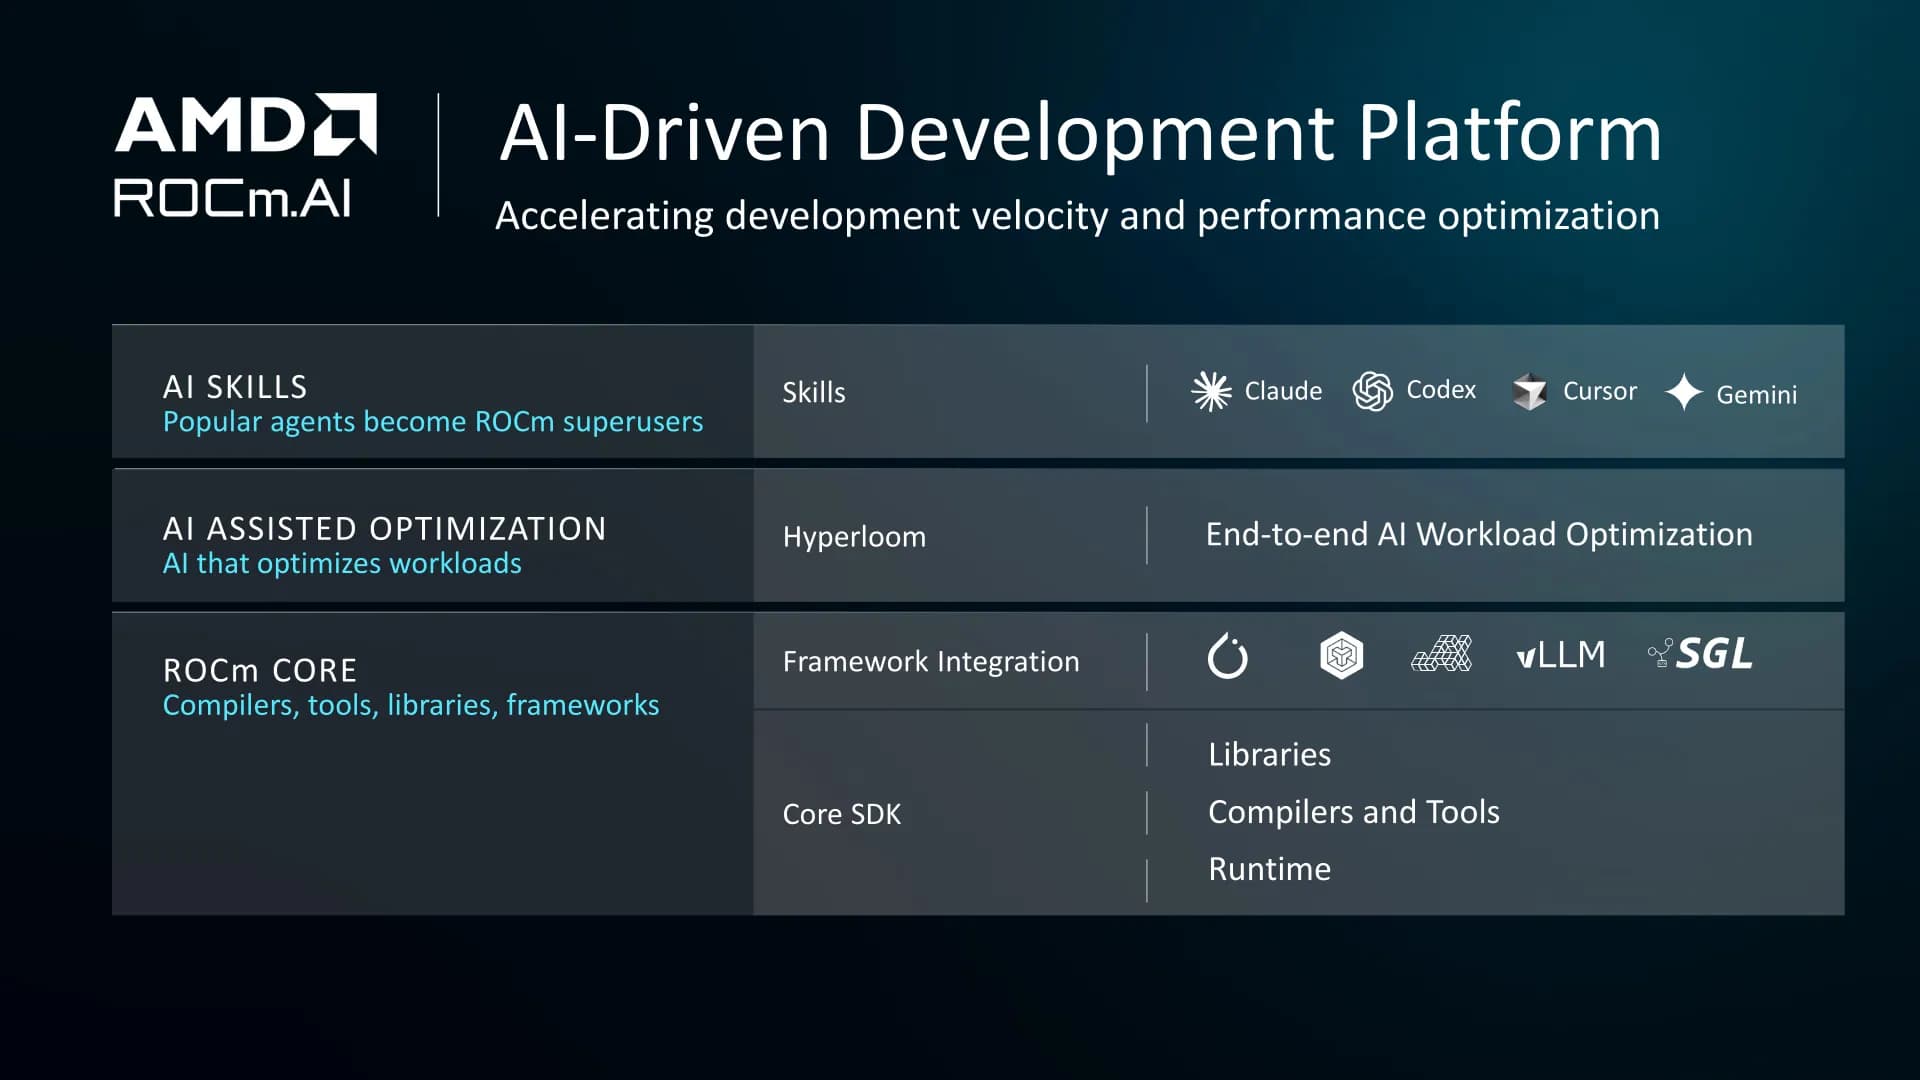
La vista previa técnica del stack de cómputo GPU de código abierto de AMD llega antes del evento Advancing AI, con mejoras de hasta 16% en cargas de IA como ComfyUI y más soporte para Windows.

La plataforma de red de acceso radio acelerada por GPU logra hasta 1,62x más rendimiento en beamforming y 1,3x en adaptación de enlace frente a los métodos tradicionales basados en CPU.

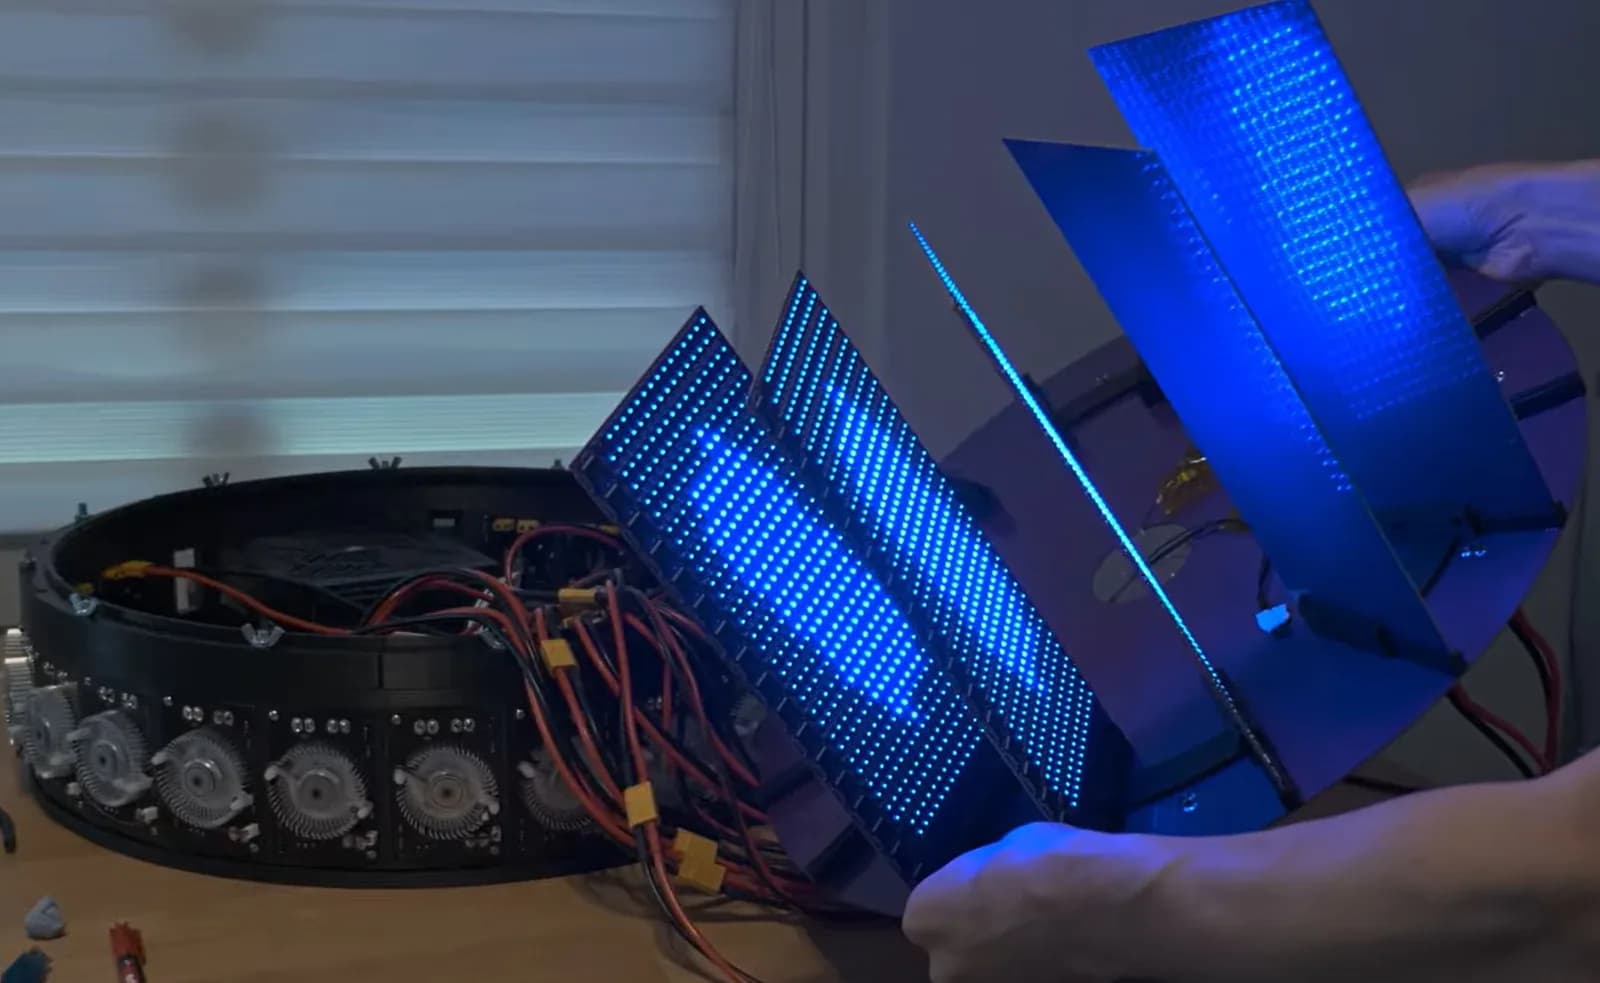
El proyecto reparte cada píxel entre 8.192 chips CH570 a 100 MHz para construir una matriz LED RGB de 320x200, con un consumo de 2 kW alimentado por una fuente Corsair ATX de 3 kW.

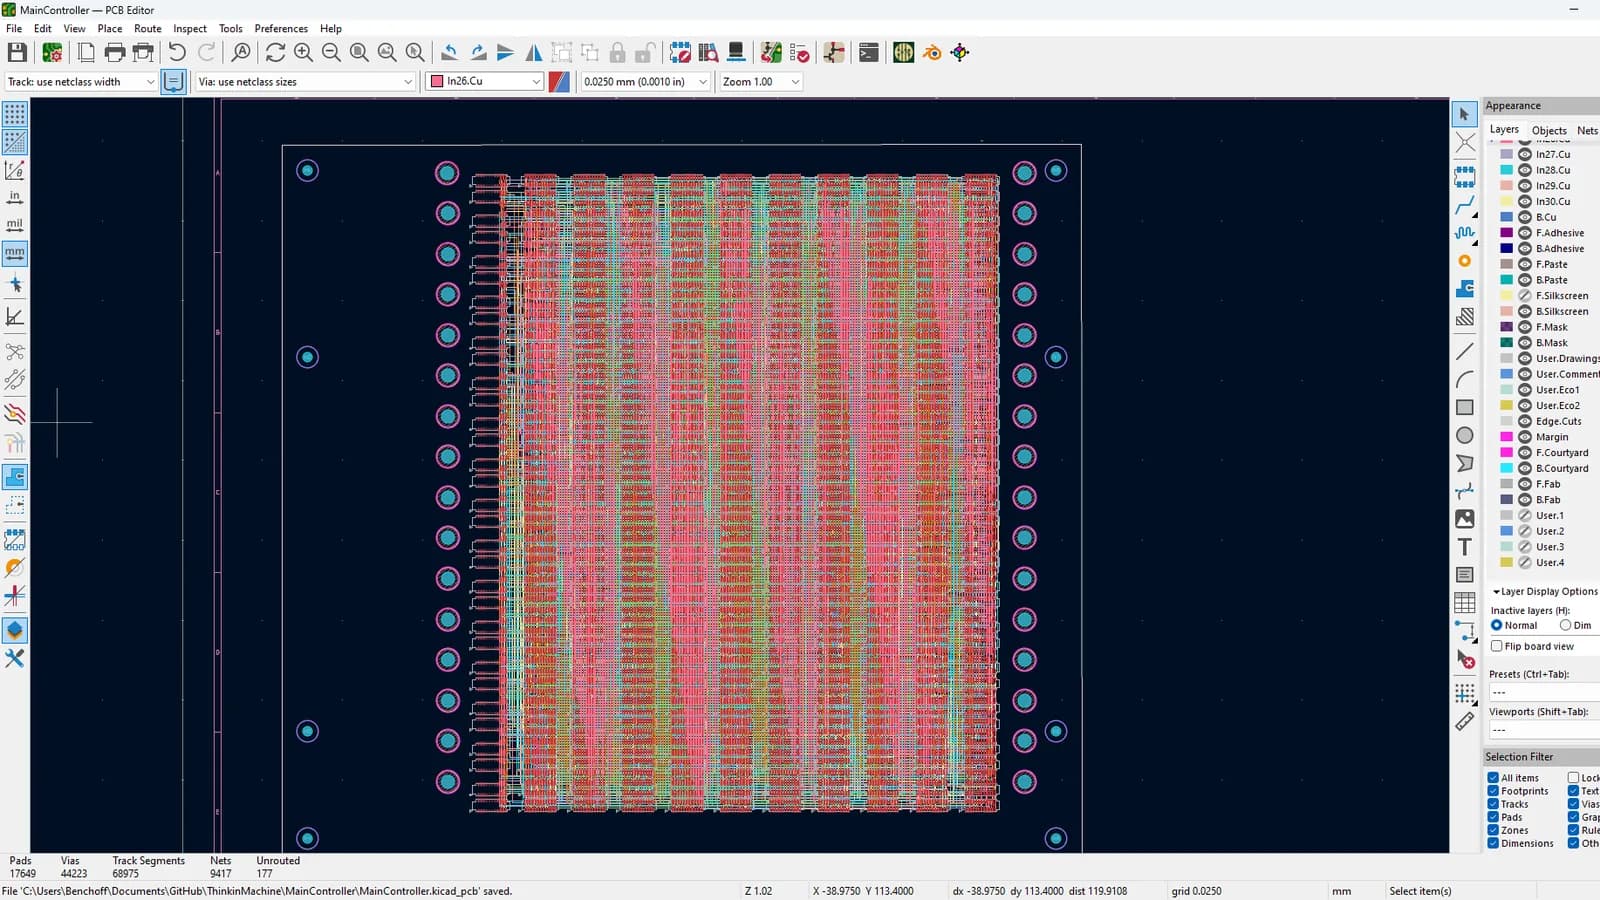
Brian Benchoff adaptó el algoritmo PathFinder de FPGAs para trazar miles de nets en malla Manhattan con vías blind/buried, empaquetado como plugin abierto de KiCad.

El nuevo soporte multi-device del runtime habilita paralelismo de tensor y de contexto, y los benchmarks colocan a DeepSpeed Ulysses como la mejor estrategia para diffusion con secuencias largas.

Un usuario de Reddit logra que el sistema operativo de Valve corra sobre la GPU discreta de Intel, pero el camino exige una Radeon como puente, un instalador parchado y Resizable BAR activado.

Khronos publicó el spec update tras tres semanas con extensiones para ampliar el espacio de flags, sumar feedback en encode de Vulkan Video y mejorar eficiencia en GPUs tiling con MSAA.

NVIDIA lanza CUDA Tile sobre Hopper, libera CUDA Python 1.0 con green contexts y process checkpointing, y debuta CompileIQ con hasta 15% de speedup en GEMM y attention.

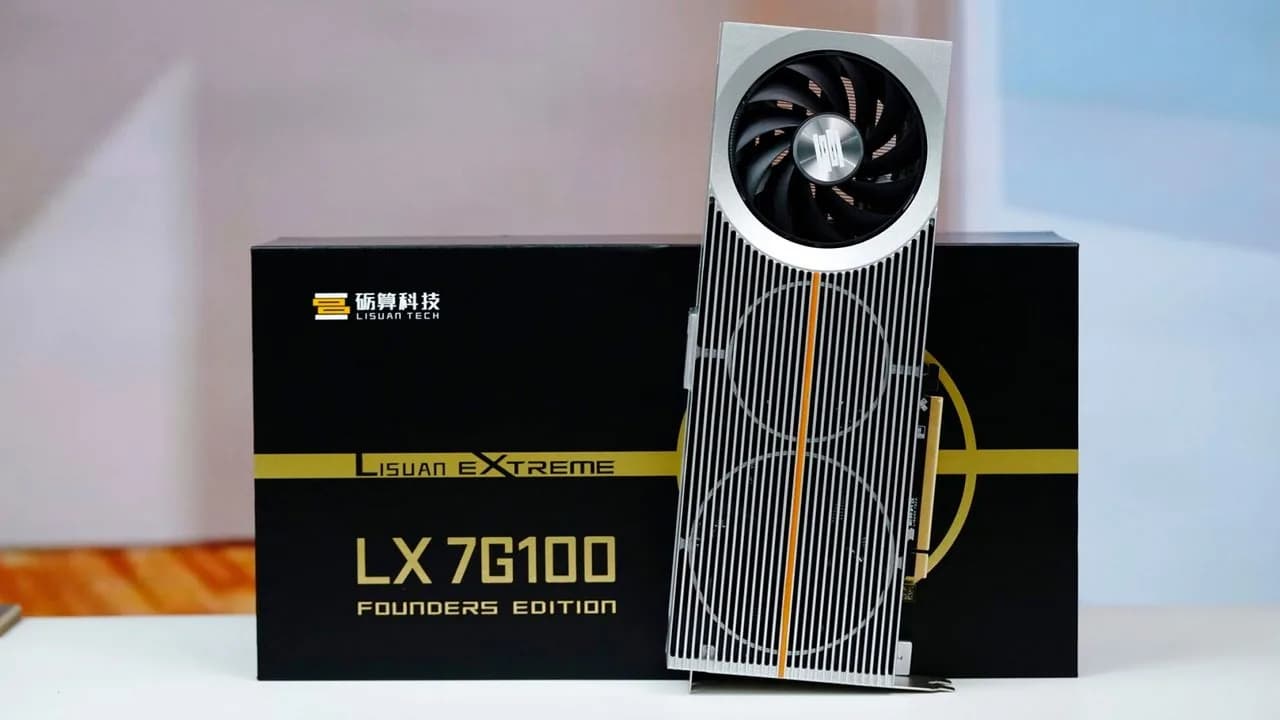
Pese a un rendimiento más cercano a una RTX 3060 que a la RTX 4060 con la que la comparan, Lisuan Tech recaudó más de 14 millones de dólares en preventa con su tarjeta debut.

La startup de Darwesh Singh apuesta a que el énfasis de Nvidia en baja precisión y tensor units para IA deja un nicho abierto en cálculos científicos, GIS y renderizado profesional.

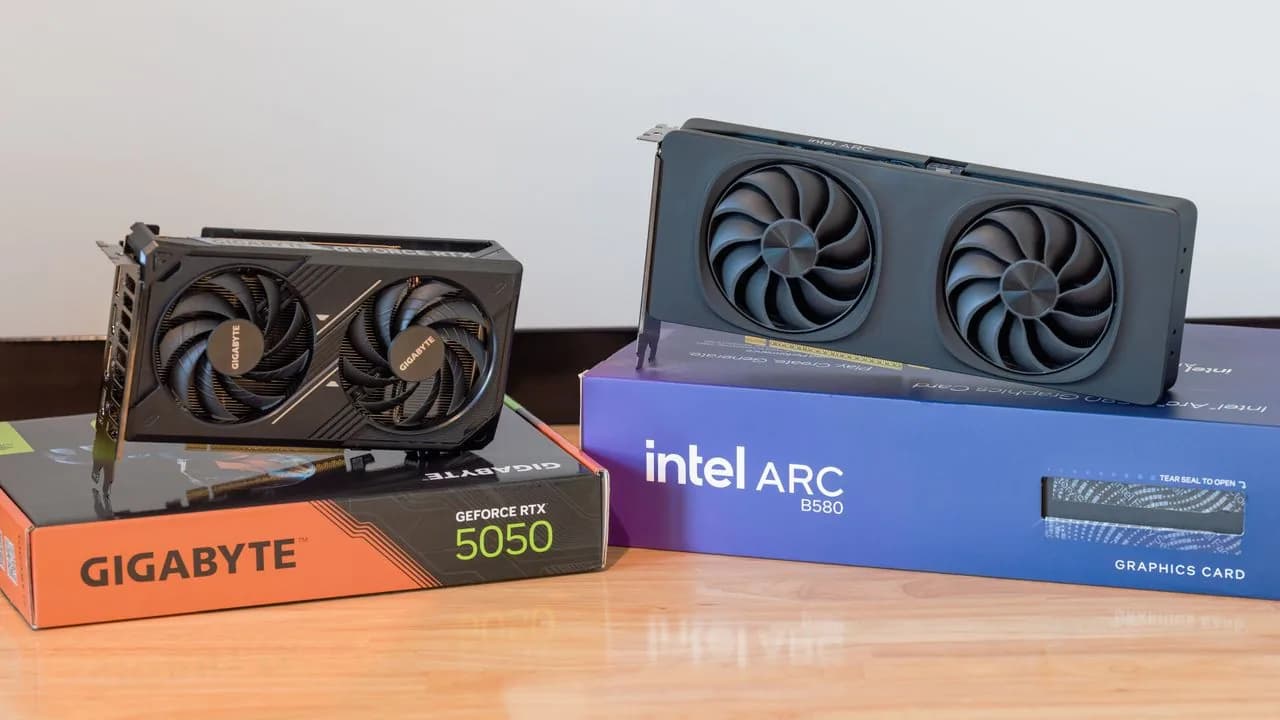
El nuevo SKU basado en Navi 44 XT igualaría en cores a la RX 9060 XT pero con clocks 24% menores, según un reporte de Videocardz, apuntando a competir con la RTX 5050.

Hardware Haven adaptó una Tesla V100 SMX a PCIe con un ducto impreso en 3D y obtuvo 130 tokens/s en gpt-oss-20b, contra 90 de una RX 7800 XT y 76 de una RTX 3060 de 12 GB.
Otros temas que aparecen junto a #gpu en nuestra cobertura editorial.