
IA
Cómo leer datos directo a la GPU desde Python con GPUDirect Storage
NVIDIA publicó una guía paso a paso con KvikIO para cargar archivos en la memoria de la GPU sin pasar por la CPU y comprobar qué ruta tomó cada lectura.
NVIDIA Developer
15 notas publicadas
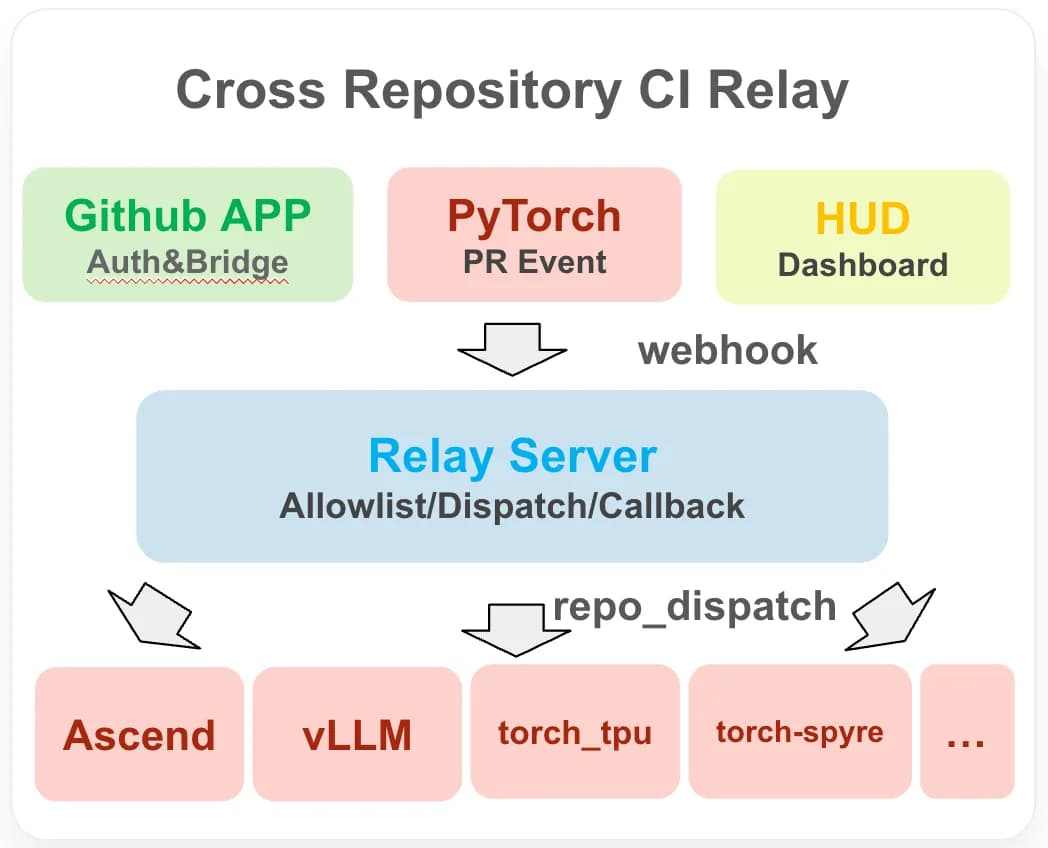
El grupo de integración de aceleradores de PyTorch resumió su primer semestre de 2026, con un relé de CI entre repositorios, pruebas independientes del hardware y perfilado para backends externos.
El lenguaje, creado en la Universidad de Pekín, promete un modelo de programación más simple que CUDA y ya es la herramienta principal de DeepSeek.
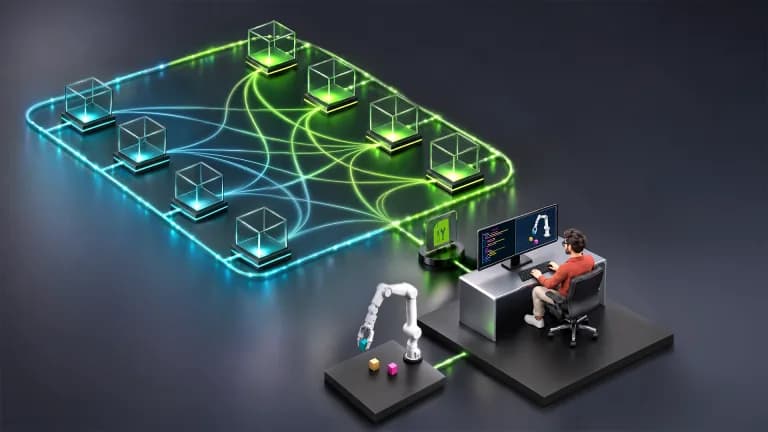
NVIDIA aportó a ROS un backend de memoria que deja los datos en la GPU entre nodos, y publicó el paso a paso para migrar un nodo de inferencia ya existente.
La nueva versión del kit de NVIDIA extiende CUDA a Windows sobre Arm, estrena soporte preliminar para la arquitectura Rubin y renueva el control de GPU compartidas con MPS V3.
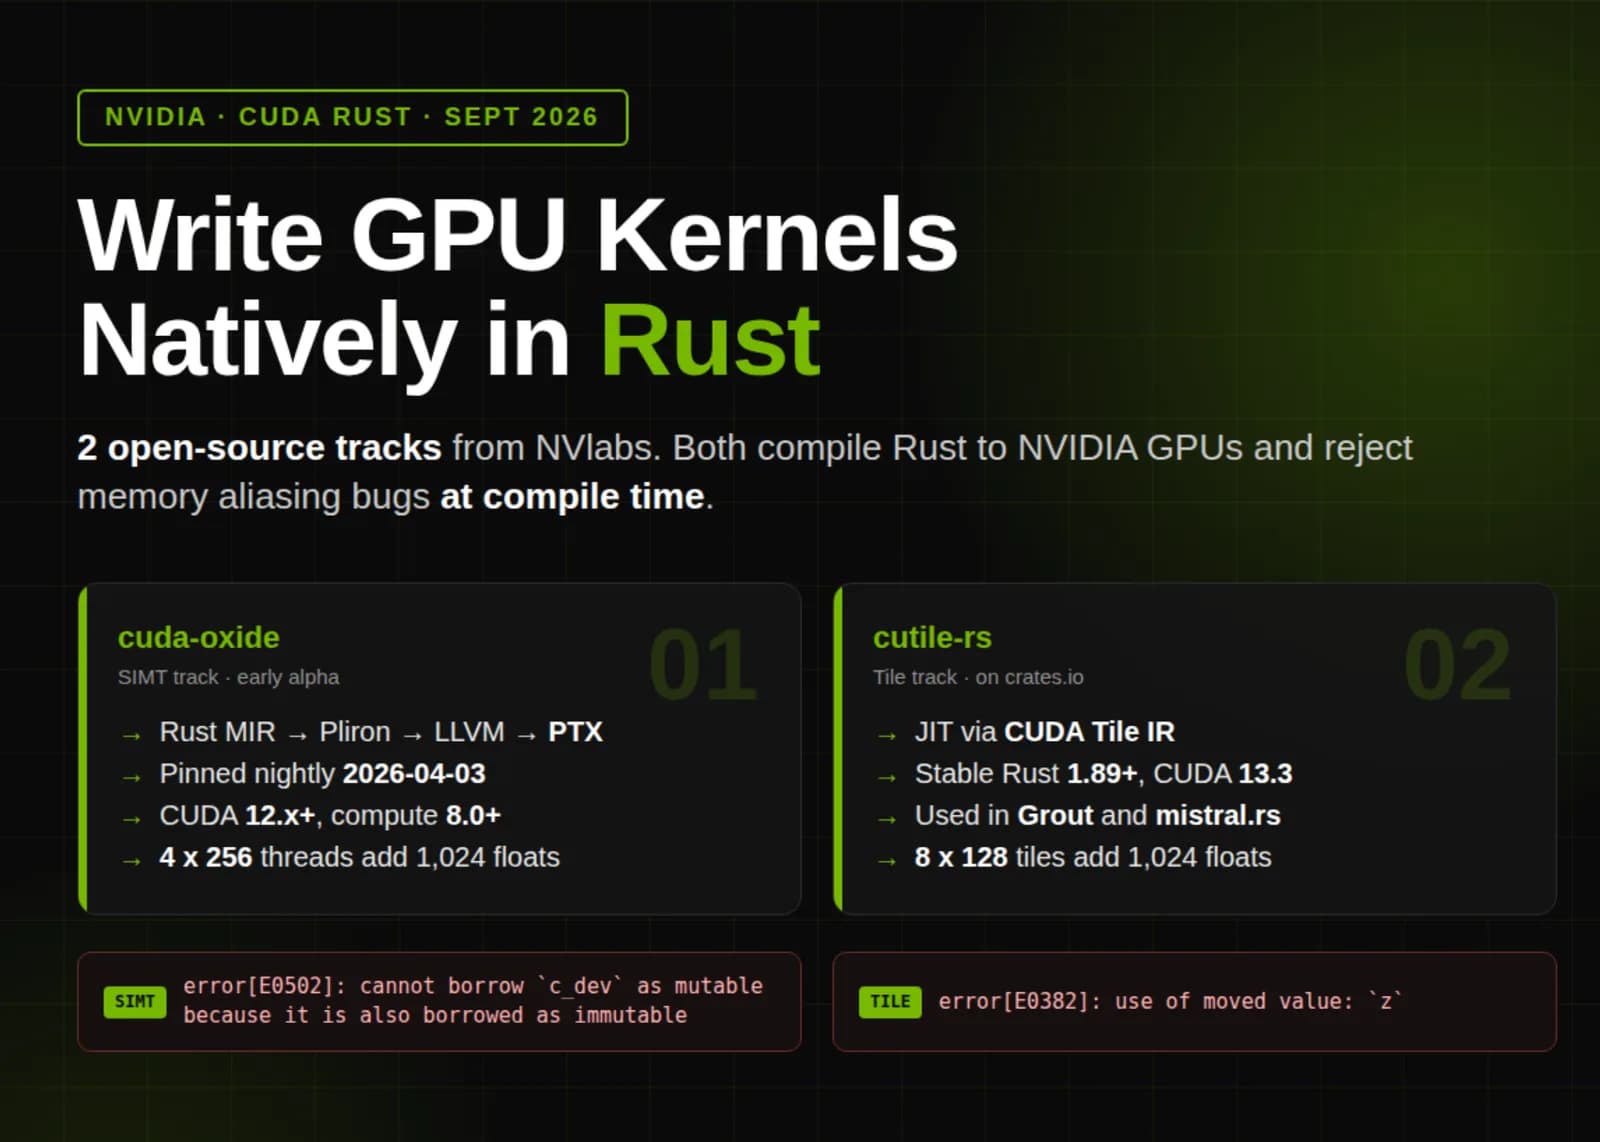
cuda-oxide compila el modelo SIMT y cutile-rs el modelo Tile, ambos apoyados en el sistema de propiedad de Rust para rechazar errores de aliasing en tiempo de compilación.
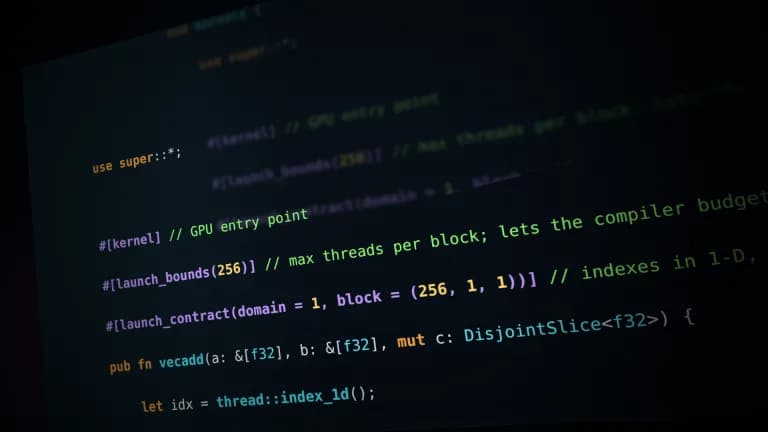
NVIDIA expande su ecosistema con dos nuevas vías para escribir kernels de GPU utilizando Rust, facilitando la seguridad y el rendimiento en el desarrollo.
Un recorrido práctico sobre una tubería de procesamiento de imágenes que, con cambios de pocas líneas, pasa de arrastrar un error de memoria compartida a correr con flujos asincrónicos.
NVIDIA libera junto a CUDA 13.3 un conjunto oficial de bibliotecas con versionado semántico, y declara a Python un ciudadano de primera clase de su plataforma, a la par de C++.
Aprende a integrar herramientas de verificación de errores y depuración en tiempo real para optimizar el rendimiento de tus aplicaciones de trazado de rayos en la GPU.
El único desarrollador del proyecto vuelve a modo weekend project tras el nuevo corte de financiamiento y suma soporte de texturas y Windows en la versión 6.
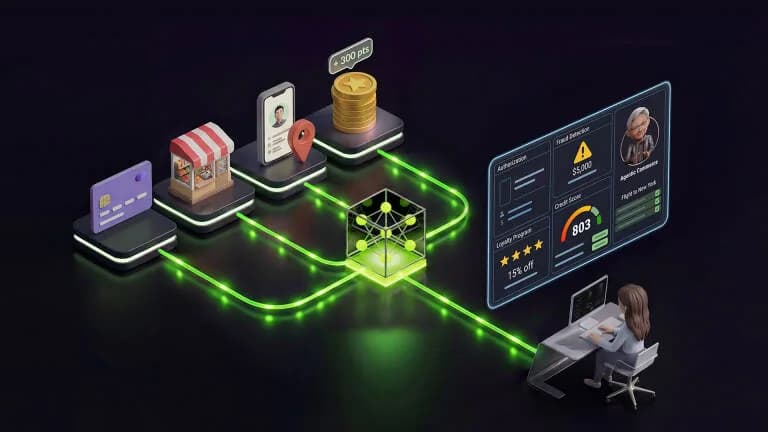
El workflow Build Your Own Transaction Model combina cuDF, cuML y NeMo AutoModel para llegar a un Llama de 29M parámetros que mejora 50% la precisión sobre XGBoost en detección de fraude.
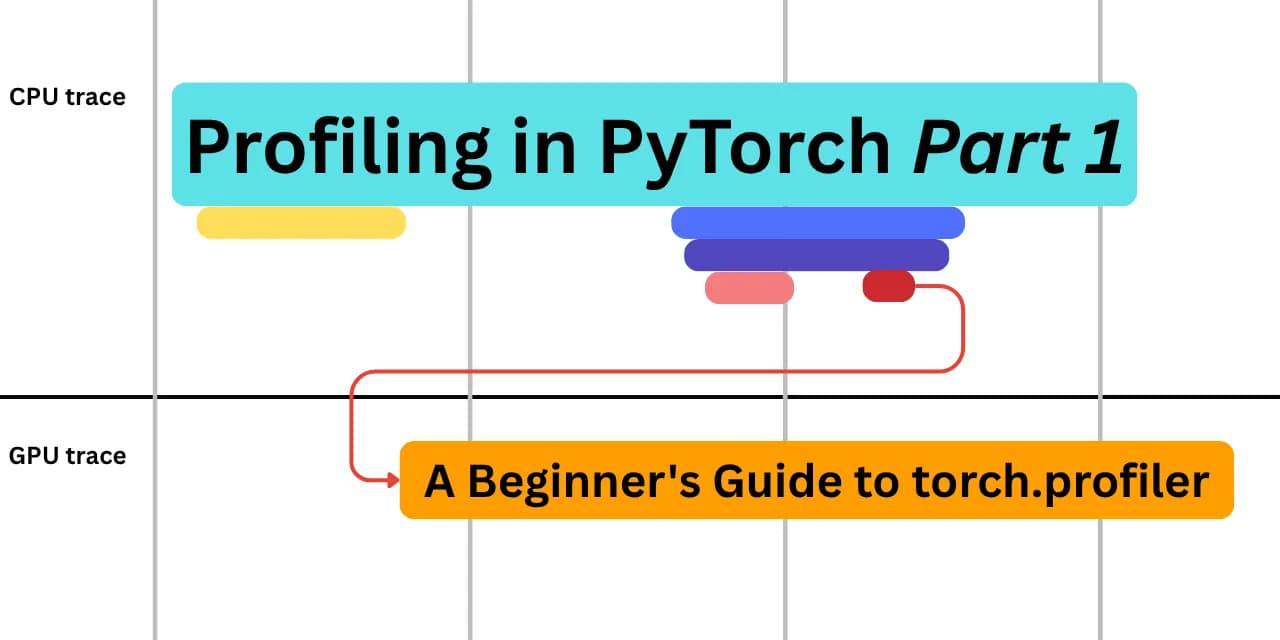
Hugging Face abre una serie de tres partes sobre profiling con PyTorch, empezando por matmul más bias en bf16 sobre una NVIDIA A100 80GB.
NVIDIA lanza CUDA Tile sobre Hopper, libera CUDA Python 1.0 con green contexts y process checkpointing, y debuta CompileIQ con hasta 15% de speedup en GEMM y attention.
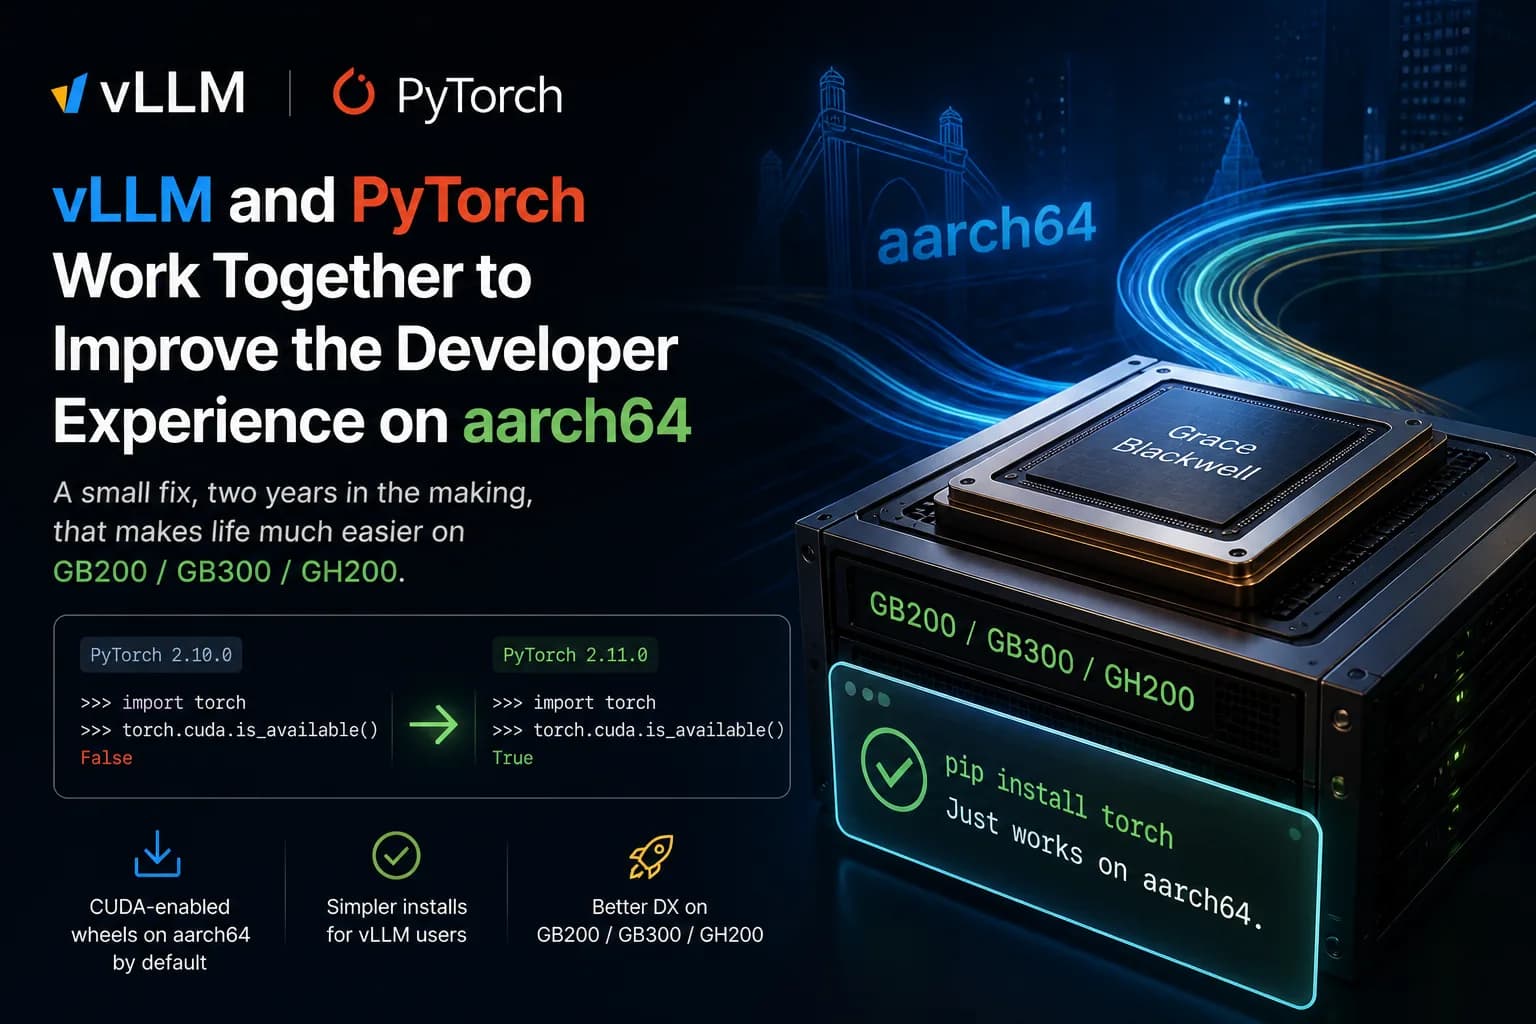
El nuevo wheel CUDA para aarch64 ya viaja en el índice por defecto de PyPI, cerrando dos años de --index-url y reinstalaciones silenciosas que rompían vLLM en Grace Hopper.
Otros temas que aparecen junto a #cuda en nuestra cobertura editorial.