Saltar al contenido
Etiqueta

#inferencia local

9 notas publicadas

Arrendar cuatro H200 para correr DeepSeek salió más caro que Claude
Electrónica

Arrendar cuatro H200 para correr DeepSeek salió más caro que Claude

Una consultora de call centers probó DeepSeek V4.1 Flash en su propio servidor para reemplazar a Opus 5.5 y terminó volviendo a Claude por costo y por seguridad.

Tom's Hardware
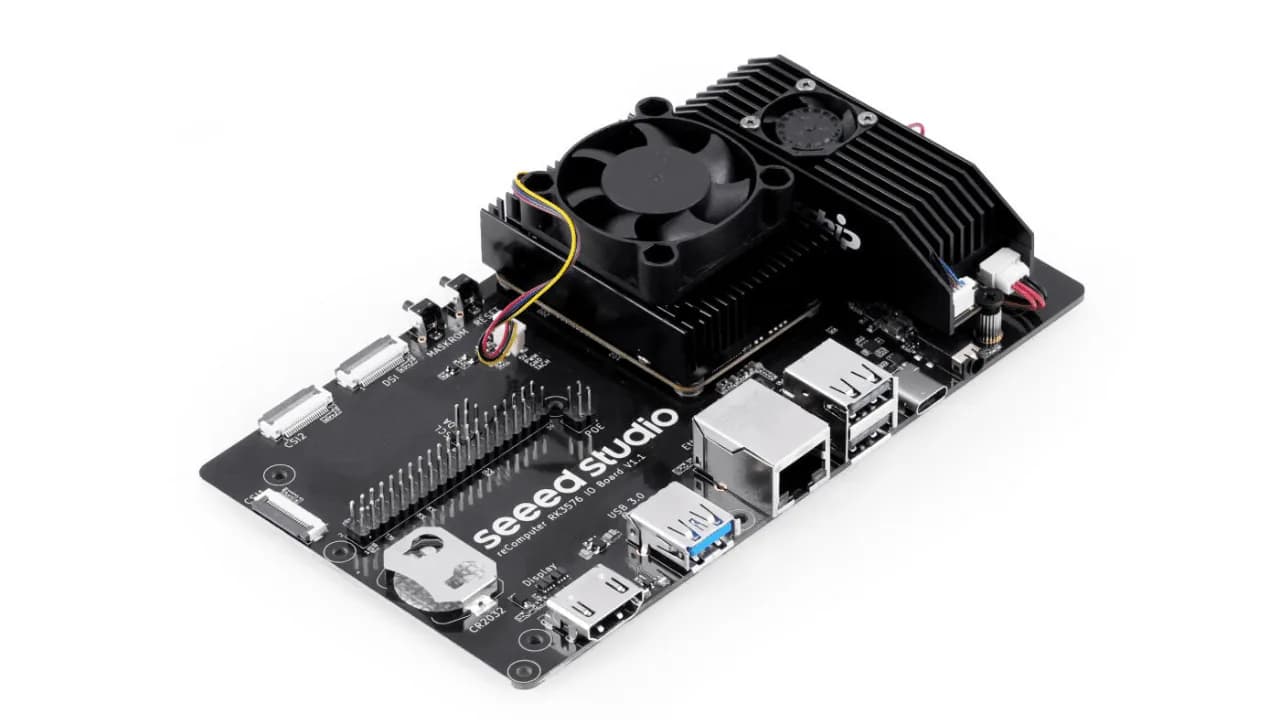
Seeed corre un LLM de 7B local con 26 TOPS por 379 dólares
Electrónica

Seeed corre un LLM de 7B local con 26 TOPS por 379 dólares

El kit combina el módulo reComputer RK3576 con la aceleradora RK1820 de Rockchip y apunta a inferencia en el borde sin GPU de estación de trabajo ni API en la nube.

Electronics For You
NVIDIA PAIR reparte la inferencia local entre varios PC
IA

NVIDIA PAIR reparte la inferencia local entre varios PC

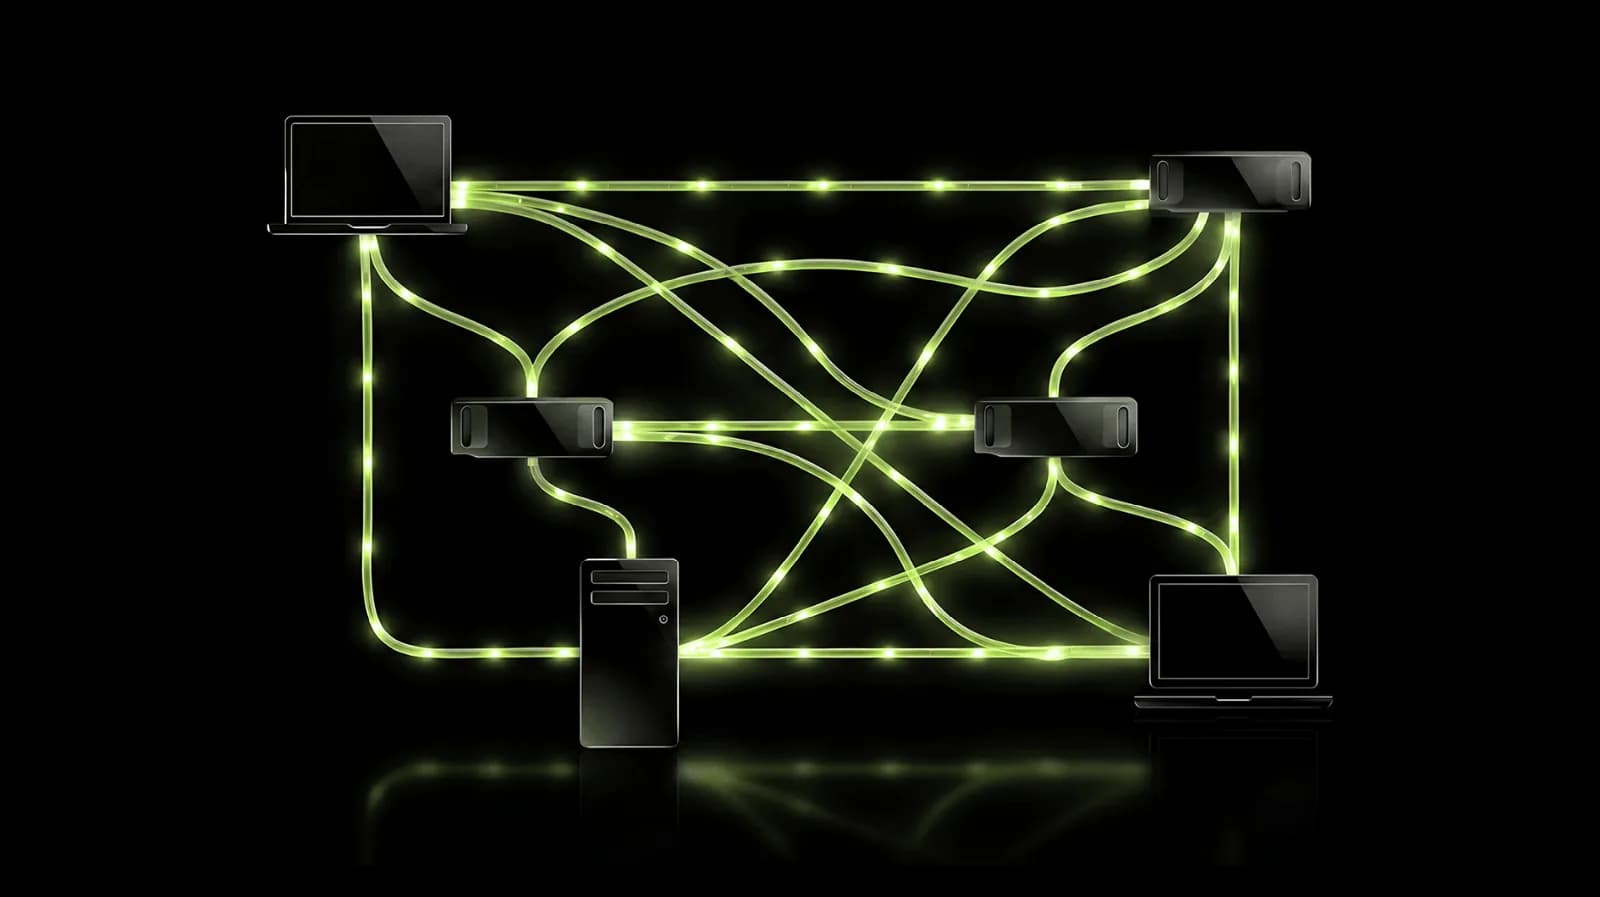
El router virtual descubre los computadores de la red doméstica y distribuye entre ellos las peticiones independientes de un sistema multiagente, sin tocar el código del agente.

NVIDIA Developer
NVIDIA PAIR une los PC ociosos de la casa en un clúster de IA
IA

NVIDIA PAIR une los PC ociosos de la casa en un clúster de IA

El Personal AI Router es software libre, funciona con GeForce RTX 20 en adelante y también con chips Apple M4, y aprovecha los equipos mientras nadie los usa.

The Verge
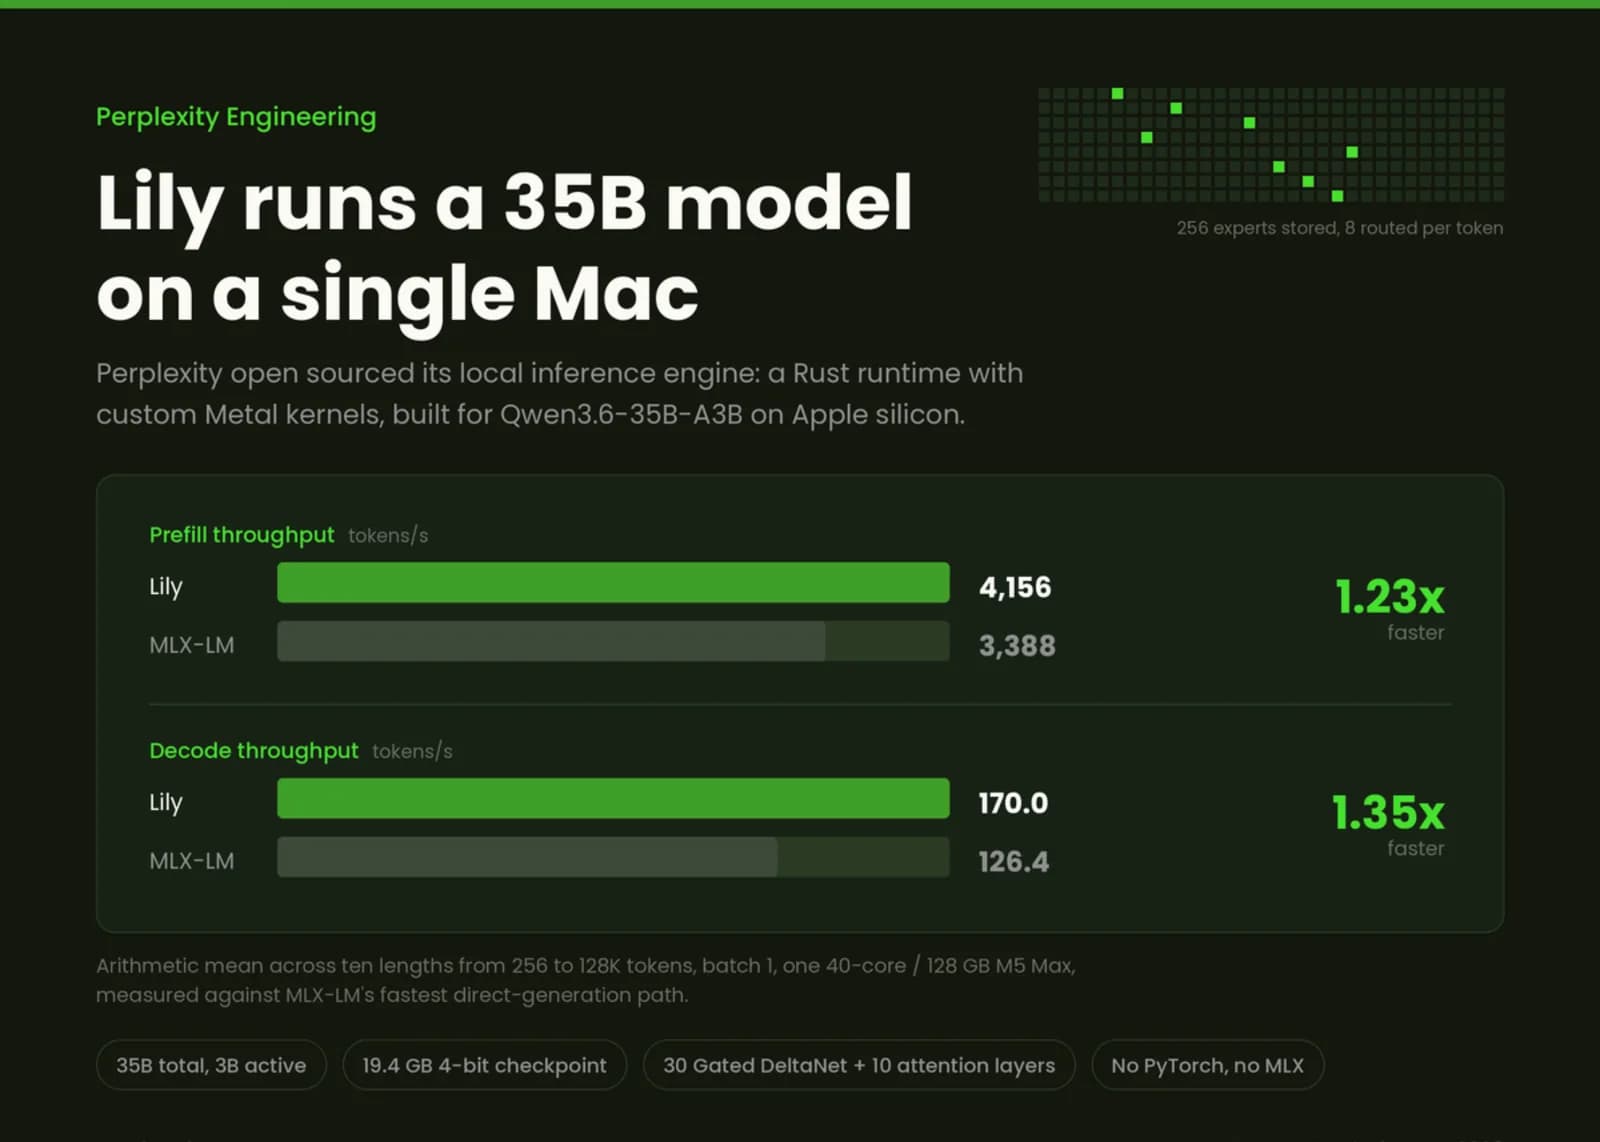
Perplexity libera Lily: inferencia en Rust y Metal para Mac
IA

Perplexity libera Lily: inferencia en Rust y Metal para Mac

El motor detrás de Hybrid Compute corre Qwen3.6-35B-A3B sin PyTorch ni MLX en el camino de ejecución, con kernels Metal escritos a mano.

MarkTechPost
Lemonade 11.9 estrena el backend ROCm HRX de AMD
Open Source

Lemonade 11.9 estrena el backend ROCm HRX de AMD

El servidor local de IA respaldado por AMD suma soporte experimental de HRX sobre llama.cpp, con mejoras de 30% a 50% en la fase de prellenado frente a los backends Vulkan y HIP existentes.

Phoronix Tests
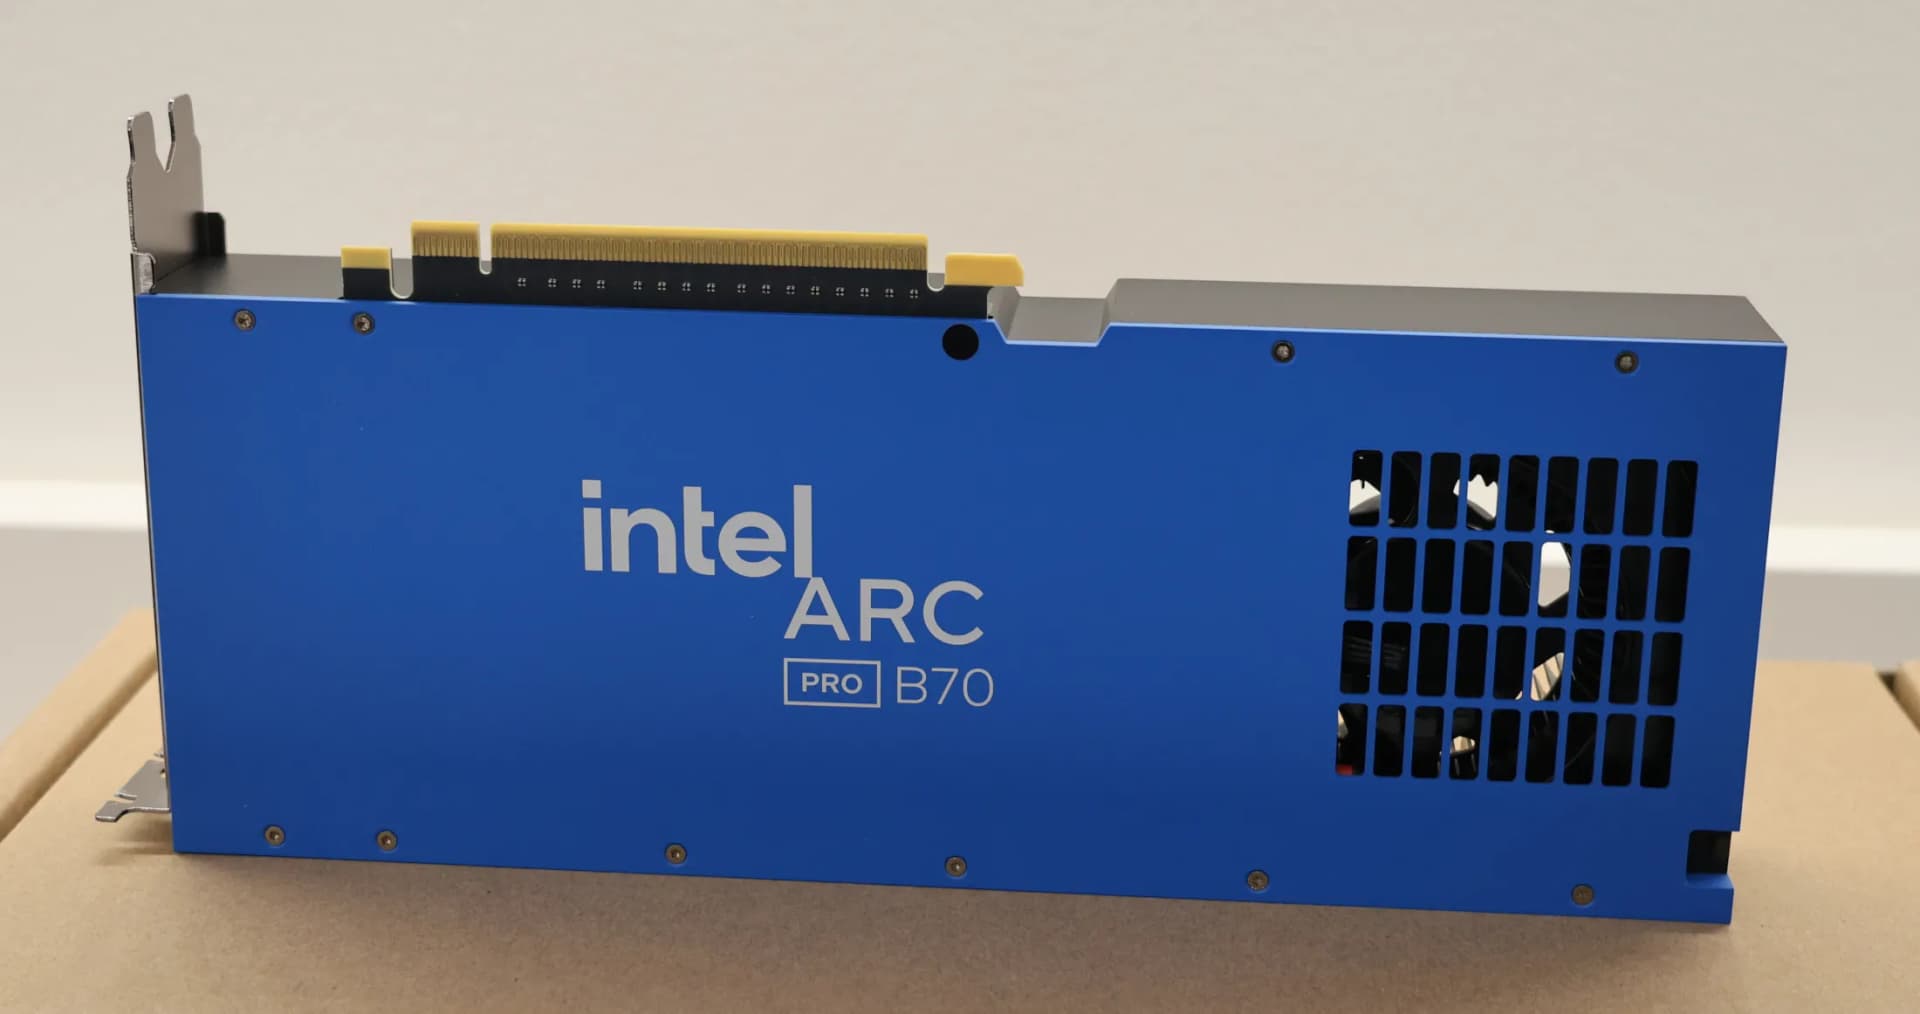
Intel LLM-Scaler ya corre Muse Glimmer 30B en las Arc Pro
Open Source

Intel LLM-Scaler ya corre Muse Glimmer 30B en las Arc Pro

Las nuevas versiones del stack en Docker de Intel suman soporte el mismo día del lanzamiento para el modelo de 30B de Meta, más generación de video local y mejoras de latencia en Gemma 4.

Phoronix Tests
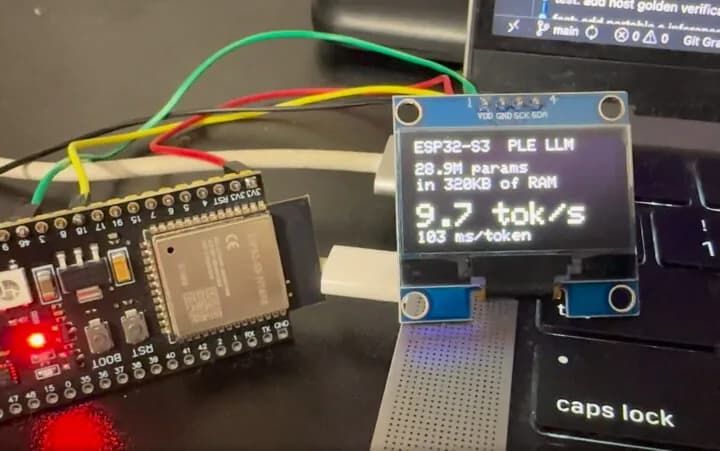
ESP32-S3: un LLM de 28,9M de parámetros corre a 9 tokens/s
Electrónica

ESP32-S3: un LLM de 28,9M de parámetros corre a 9 tokens/s

El desarrollador Slava S. logró que un modelo de lenguaje completo se ejecute sin conexión en una placa de unos 8 dólares, apoyándose en la técnica de embeddings por capa de Google.

CNX Software

Etiquetas relacionadas

Otros temas que aparecen junto a #inferencia local en nuestra cobertura editorial.