
Electrónica
Jev y los modelos de decisión, LLM que responden solo con números
No escriben ni una frase, pero clasifican y puntúan texto muy rápido y muy barato, y ya inspiraron variantes como Kev y Nimble, que corre local con Ollama.
Hackaday
9 notas publicadas
MarkTechPost ordenó 11 proyectos de código abierto según lo bien que documentan la inferencia local, con los datos de cada repositorio leídos en GitHub el 18 de septiembre de 2026.
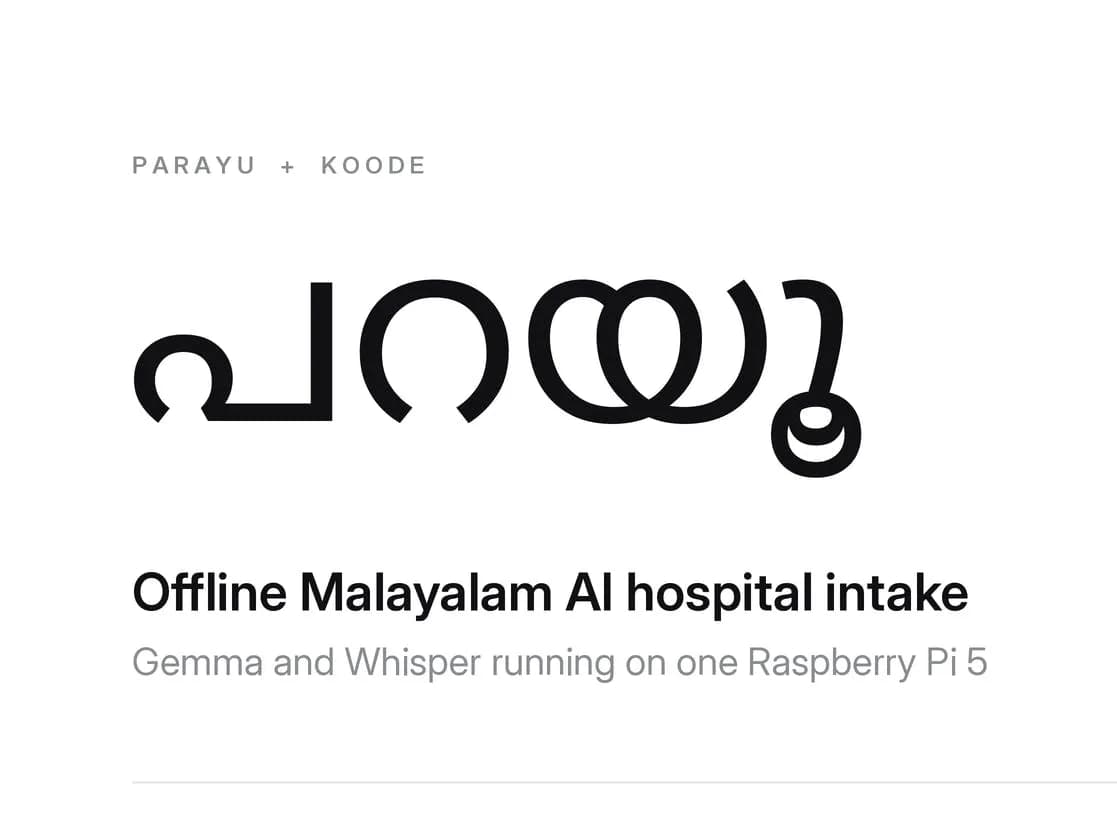
Un kiosco con Raspberry Pi 5 entrevista al paciente en su idioma, le asigna especialidad y manda un robot con ESP32 a acompañarlo hasta la puerta.
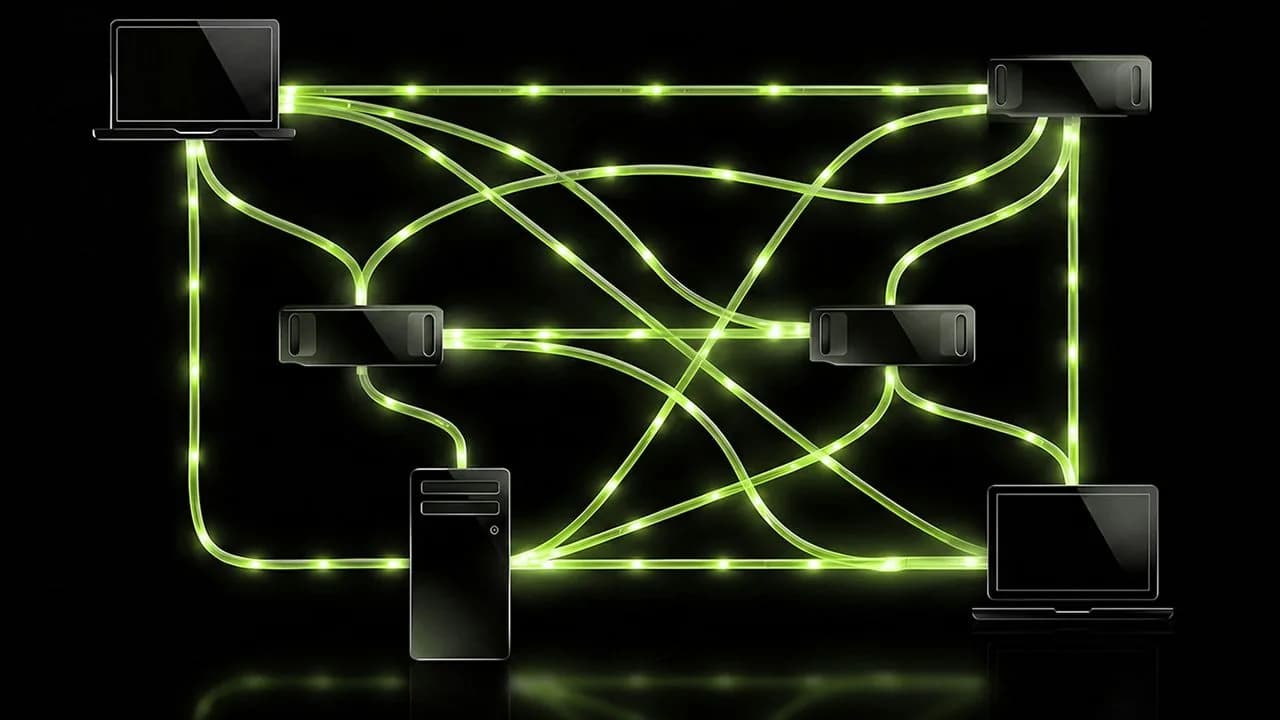
La herramienta, presentada en IFA 2026, manda subtareas de un agente local a los computadores de la red doméstica que tengan ciclos de GPU libres.
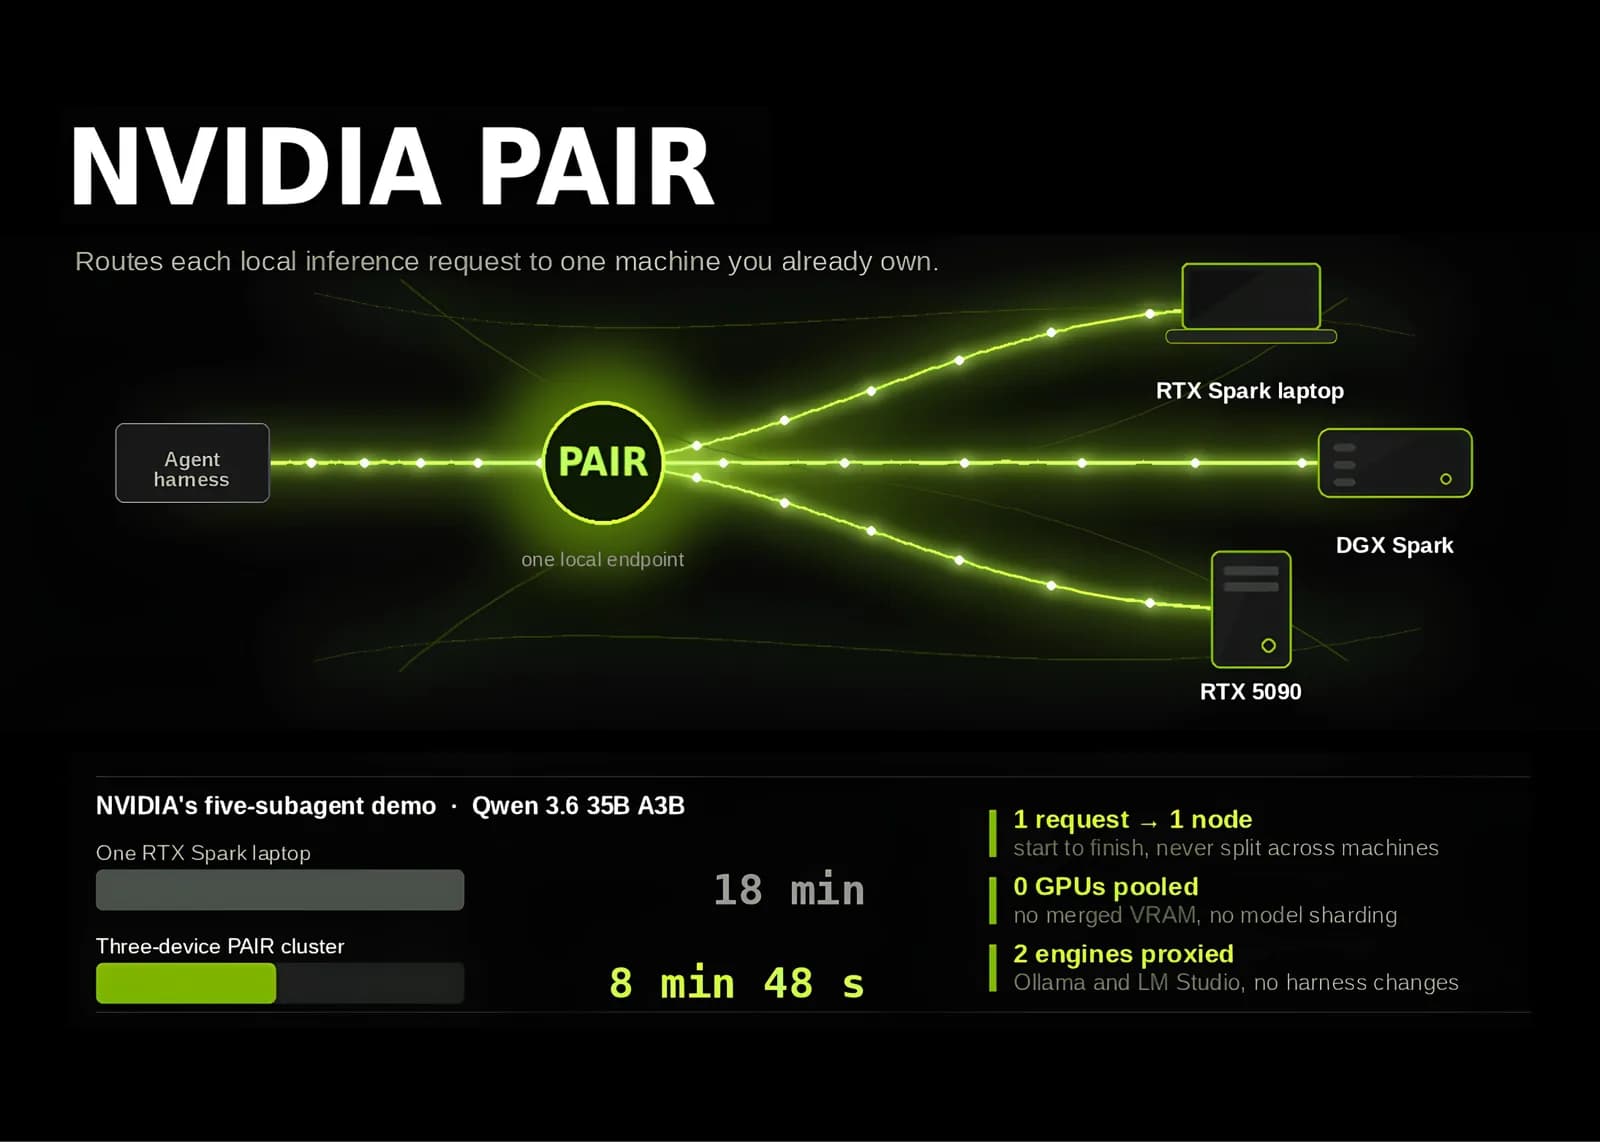
El nuevo router de inferencia virtual de código abierto de NVIDIA permite ejecutar flujos de trabajo multi-agente en una red local entre RTX, DGX y Mac.
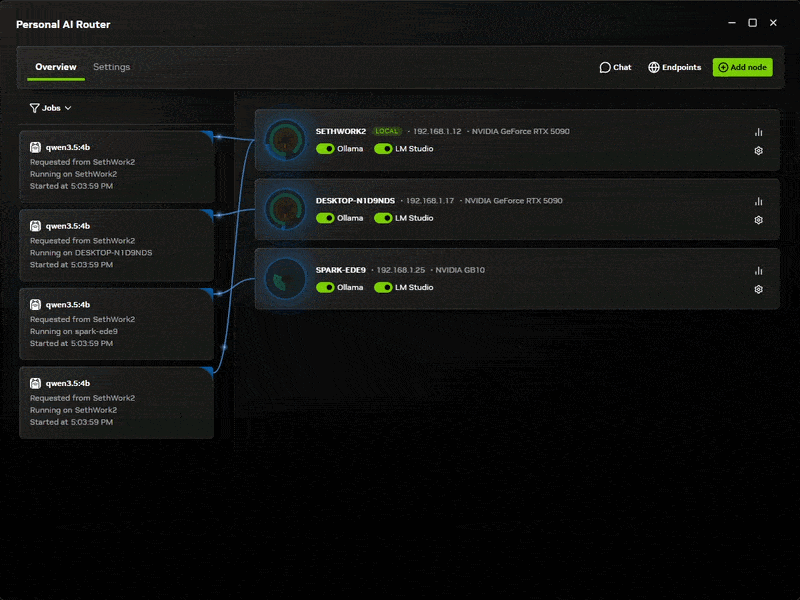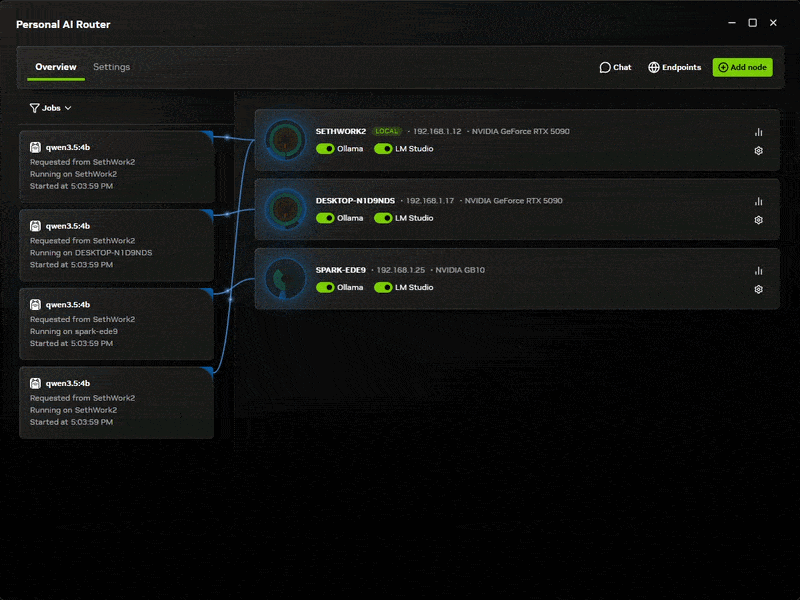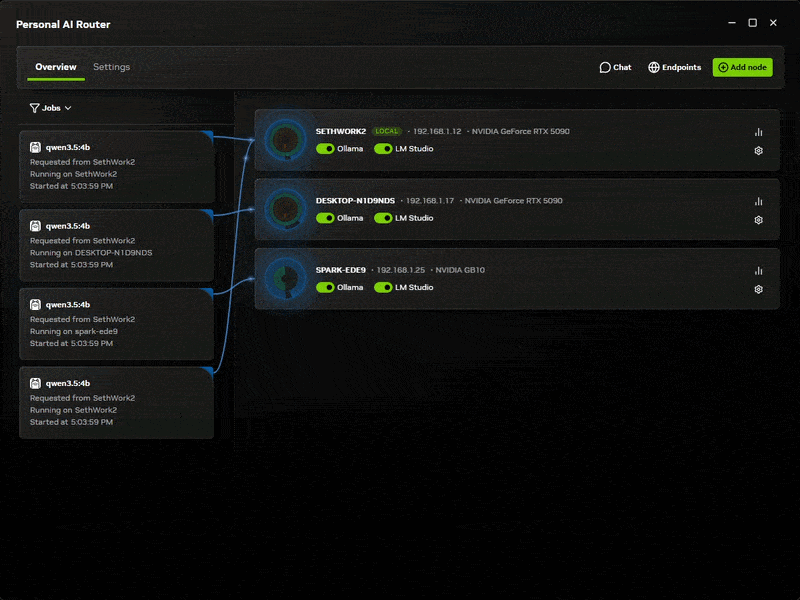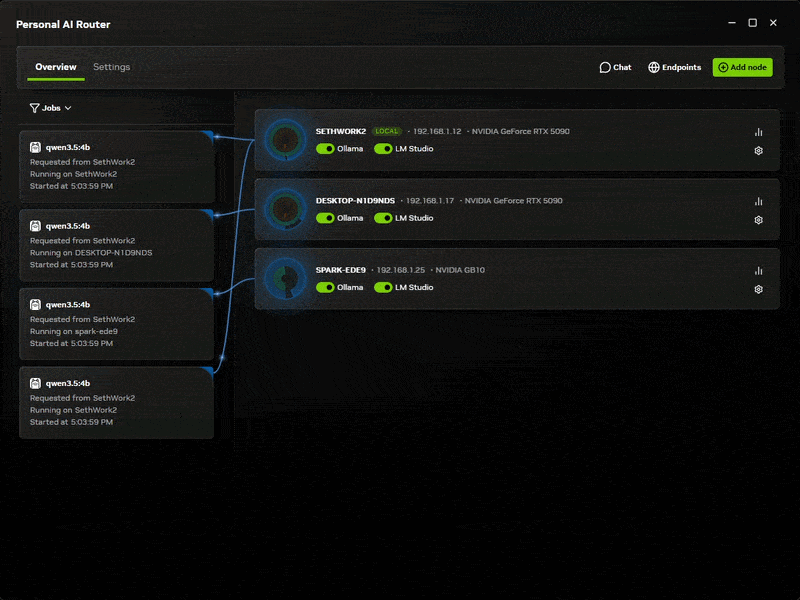
NVIDIA lanza PAIR, una herramienta que permite repartir cargas de trabajo entre múltiples equipos de tu red local sin cambiar el código de tus agentes de IA.
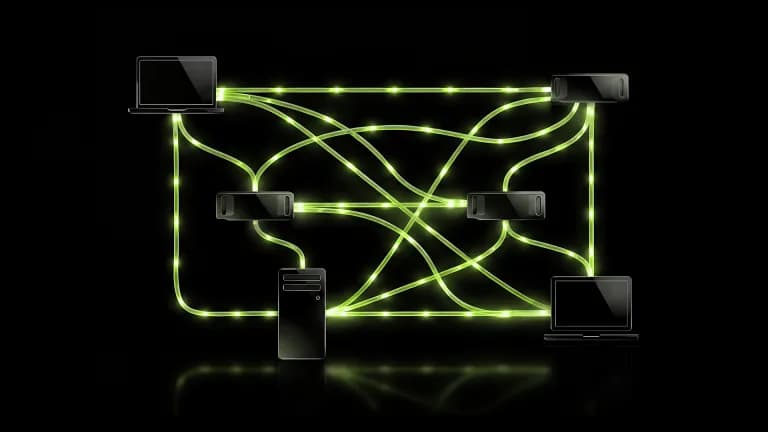
El router virtual descubre los computadores de la red doméstica y distribuye entre ellos las peticiones independientes de un sistema multiagente, sin tocar el código del agente.
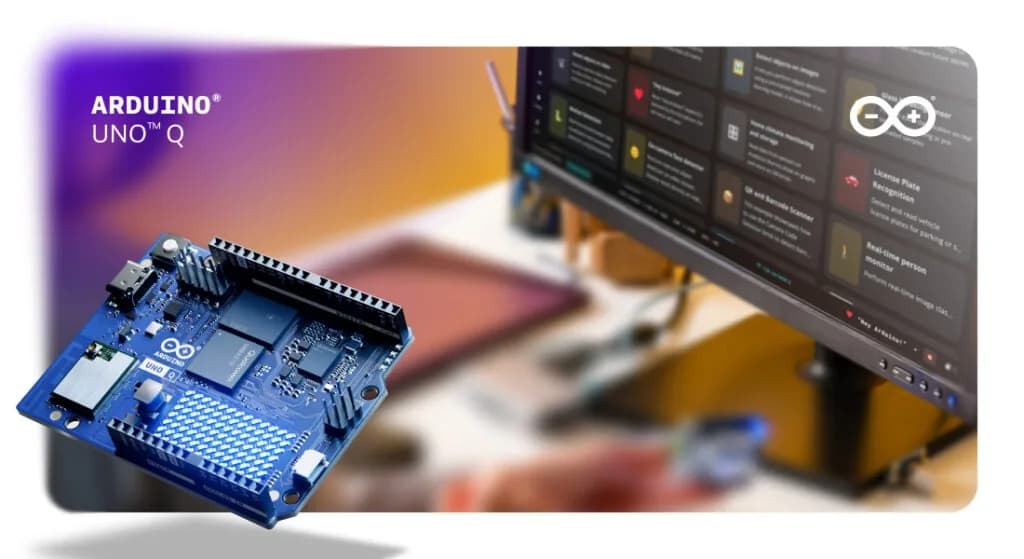
La placa combina Debian Linux con el ecosistema Arduino y ejecuta un Llama 3.2 1B cuantizado a 4 bits con unos 600 a 700 MB en disco y 1 GB de RAM al inferir.
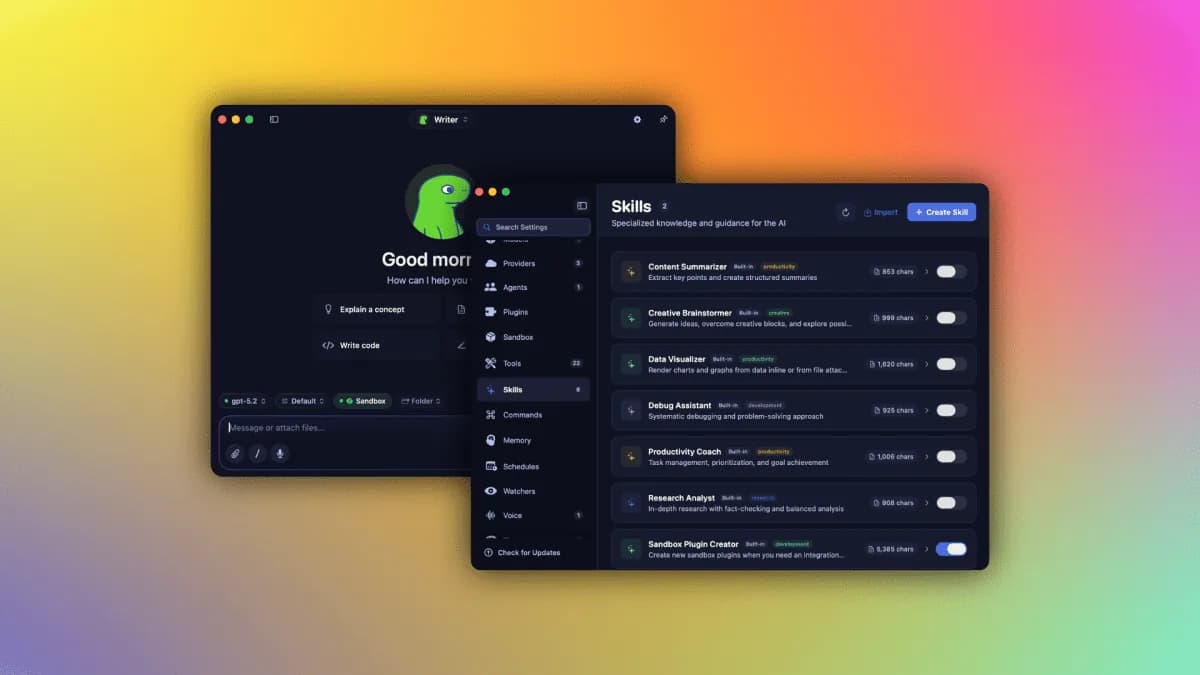
El proyecto corre MiniMax M2.5, Gemma 4, Qwen3.6, DeepSeek V4 y los modelos on-device de Apple, con sandbox por hardware y más de 20 plugins integrados.
Otros temas que aparecen junto a #ollama en nuestra cobertura editorial.