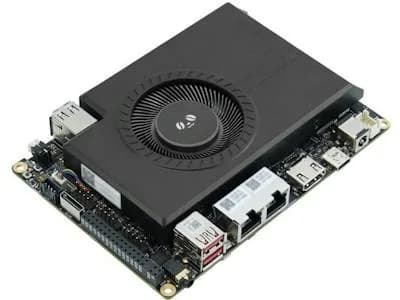
LattePanda Sigma 2 lleva un Intel Core Ultra X7 y 64 GB a una sola placa
La sucesora del servidor de placa única de LattePanda suma un chip Panther Lake, dos puertos de 10 GbE y un RP2350 para control en tiempo real. Preventa a 2.599 dólares.
60 notas publicadas

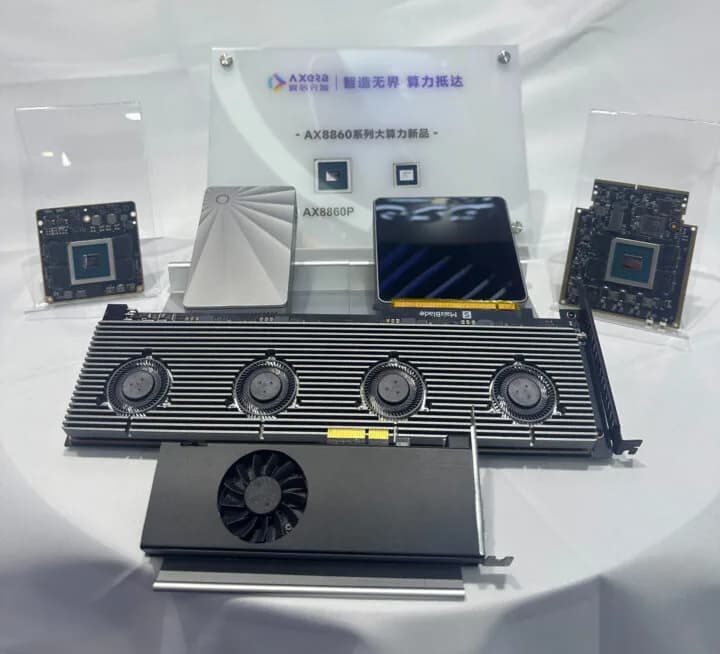
El chip suma 16 núcleos Cortex-A55, hasta 256 TOPS y 128 GB de LPDDR5x, y Sipeed promete un mini computador con él por menos de 4.000 dólares.

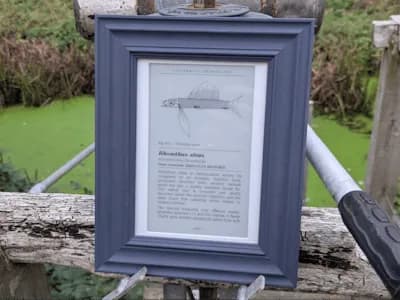
This Fish Does Not Exist, de Jim Bruges, genera cada pez con el algoritmo fishdraw y le escribe una ficha científica con Gemma 3 1B, sin conexión a internet.

Tiene 24.000 millones de parámetros, activa solo 2.000 millones por token y decodifica 184 tokens por segundo en un MacBook con M5 Max.

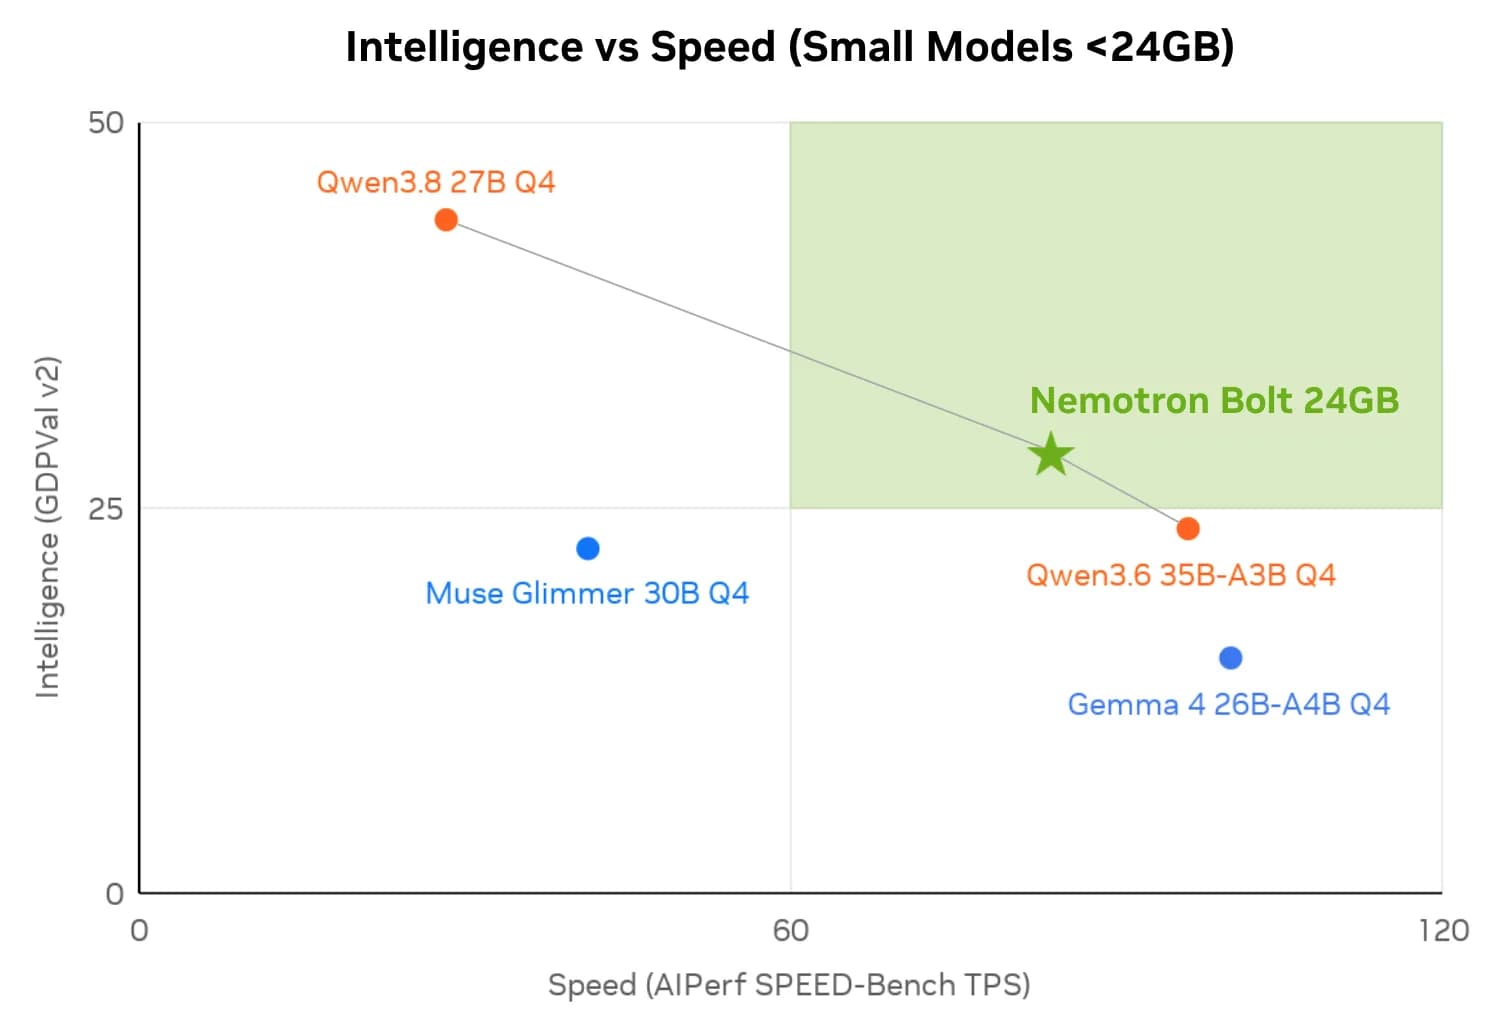
Super VL tiene 120.000 millones de parámetros y apunta a agentes empresariales. Los Bolt corren en 24 GB y 4 GB de memoria, en PC y Jetson.

Reemplaza al delegado GPU de TensorFlow Lite, funciona con OpenCL, OpenGL ES, Metal y WebGPU y se publica bajo licencia Apache 2.0.

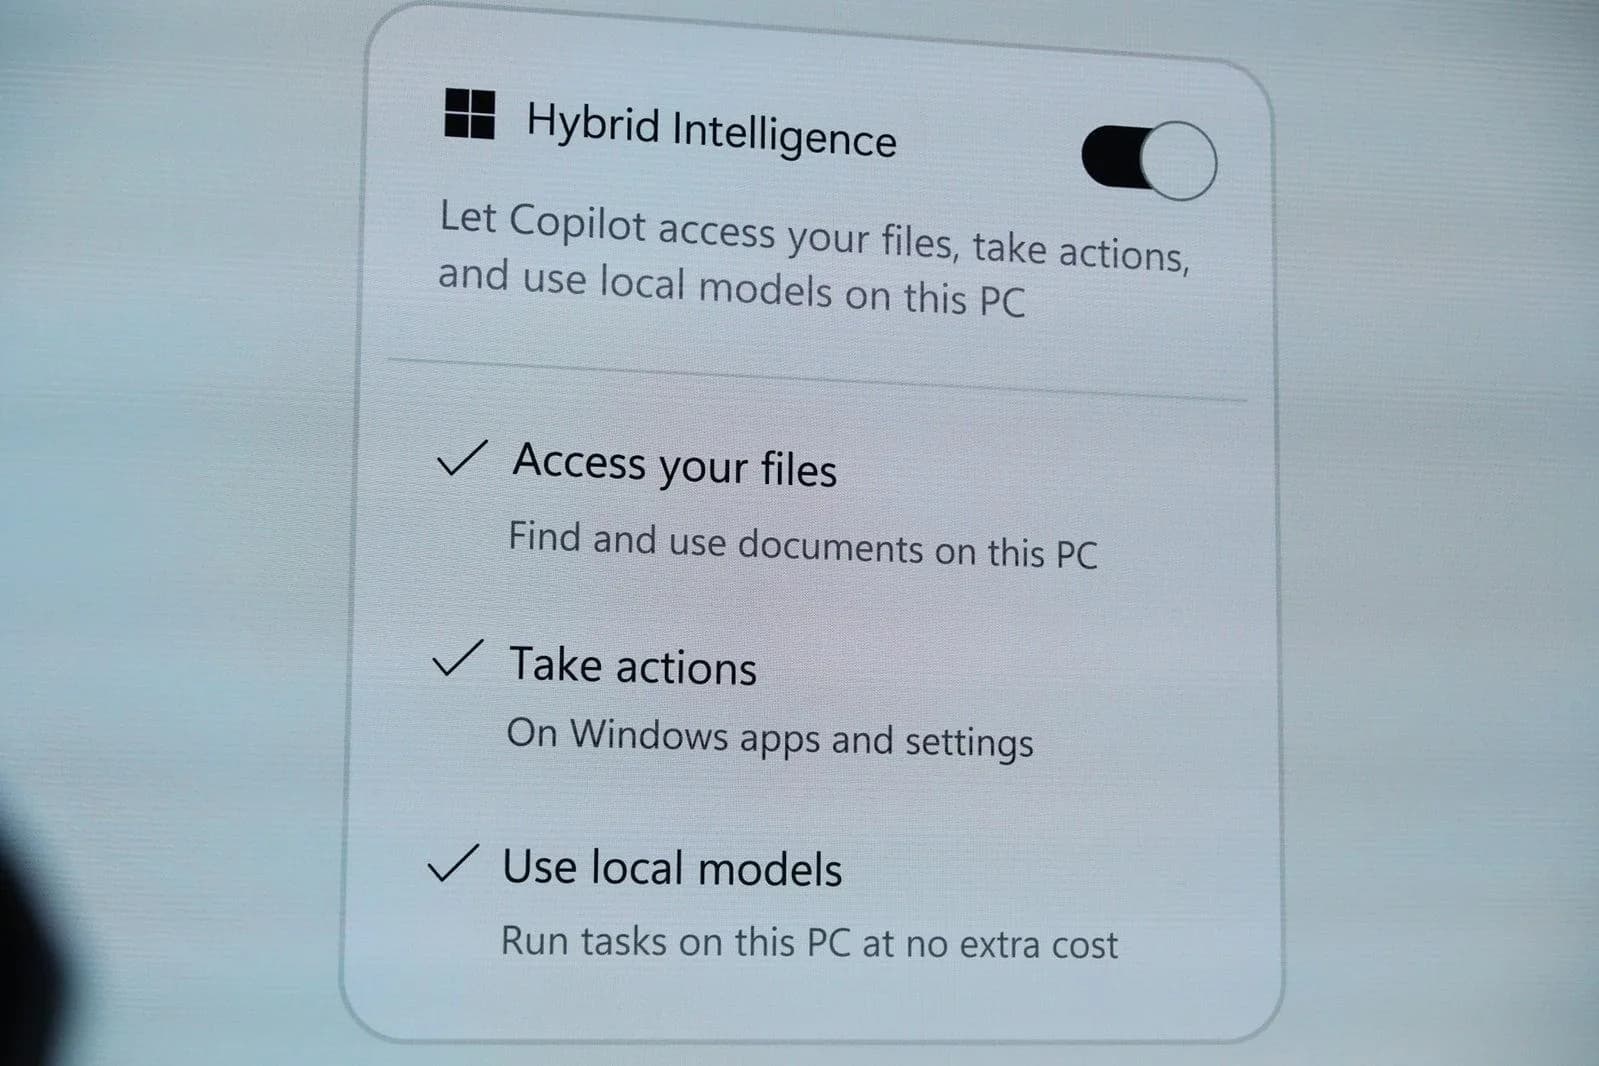
Microsoft llama Hybrid Intelligence a la mezcla de modelos locales y en la nube que le dará al agente acceso a los archivos del equipo y acciones en todo el sistema.

NVIDIA y Microsoft presentaron en San Francisco el chip para agentes locales, la Surface Laptop Ultra y una DGX Station que por primera vez corre Windows.

El modelo abierto de 740 millones de parámetros corre en el navegador con unos 191 MB de RAM y no necesita clave de API.

No escriben ni una frase, pero clasifican y puntúan texto muy rápido y muy barato, y ya inspiraron variantes como Kev y Nimble, que corre local con Ollama.

La compañía compara su Ryzen AI Max+ Pro 495 con un Core Ultra de Intel y dice haber despachado más de medio millón de PC agénticos.
Rubber Duck-ify usa una webcam Logitech C270 y una impresora térmica de boletas, y procesa las imágenes en la NPU de la placa sin depender de la nube.

Wired probó la versión de 11.000 dólares, con 256 GB de memoria unificada y 80 núcleos de GPU, y la usó como servidor de IA sobre el escritorio.
La versión recortada mantiene el GB10, los 273 GB/s de ancho de banda y la tarjeta ConnectX 7 para unir dos equipos.

Alibaba asegura que su modelo abierto supera a Nano Banana 2.0 en su propio benchmark, pero la nueva licencia prohíbe revender el modelo sin permiso.

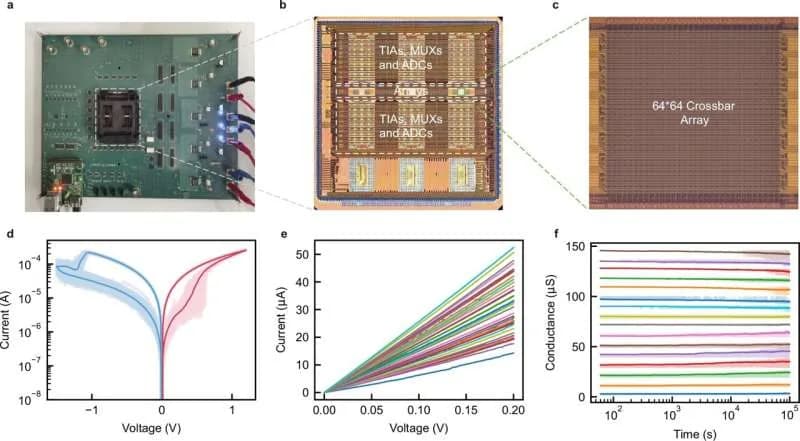
Investigadores de Hong Kong presentan un chip memristor que aumenta la capacidad de memoria asociativa, reduciendo drásticamente el uso de hardware y energía.

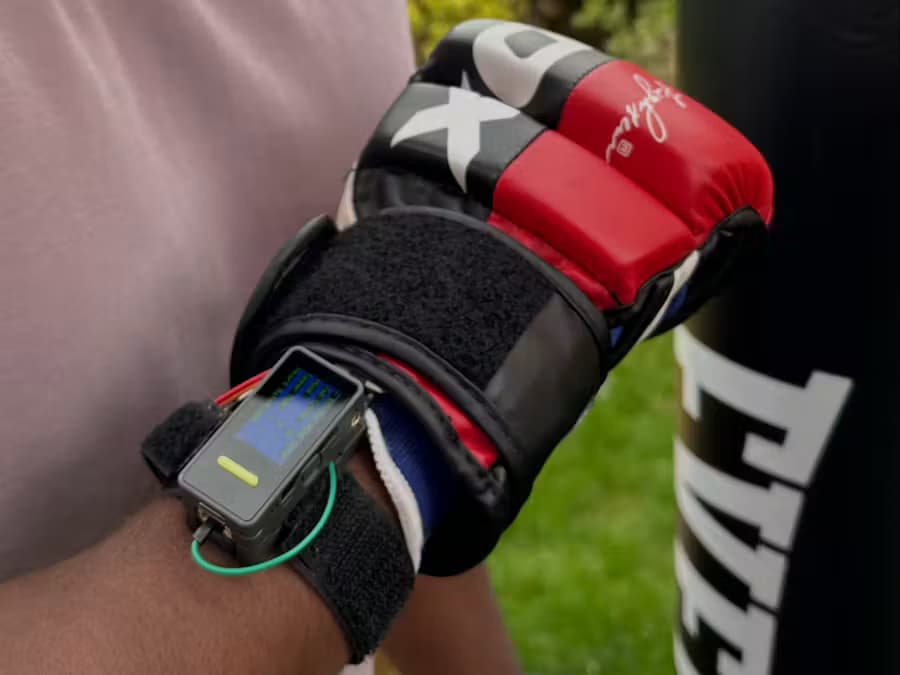
El nuevo desarrollo de Manivannan utiliza sensores biométricos y machine learning para trackear golpes y frecuencia cardíaca en tiempo real mediante el Nesso N1.

Un desarrollador creó un Tamagotchi que monitorea tu tiempo de pantalla y notificaciones mediante un ESP32 y un modelo de lenguaje local para motivarte a soltar el móvil.

Una nueva arquitectura diseñada por Meta y Panmnesia utiliza CXL para que miles de aceleradores de IA operen como un sistema único y coordinado.

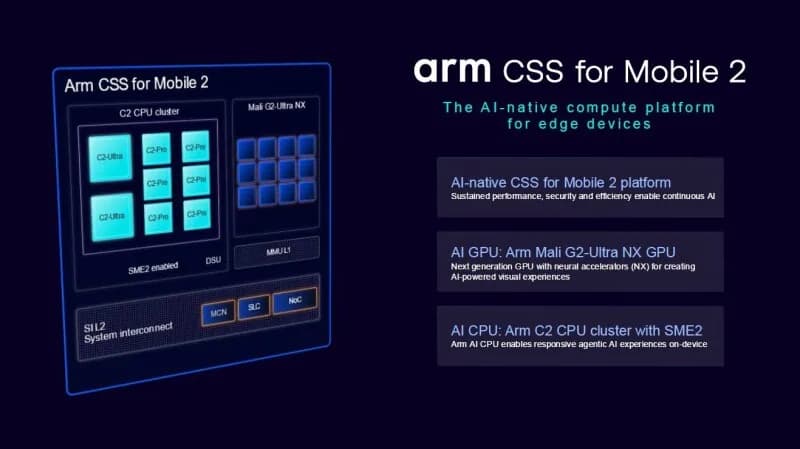
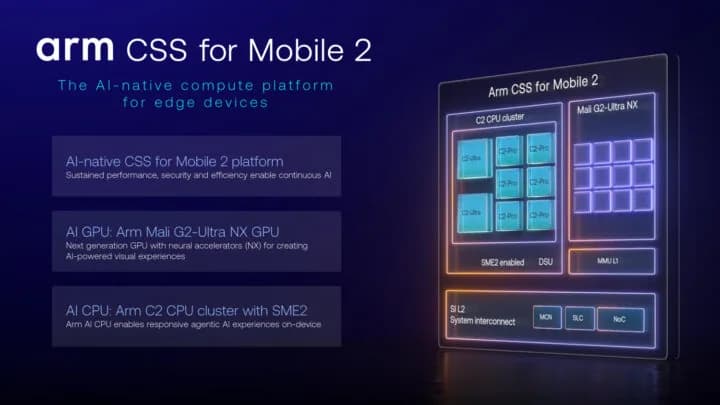
La nueva plataforma CSS para Mobile 2 busca optimizar la IA agentica y el rendimiento gráfico con un consumo energético limitado a solo 1 vatio.

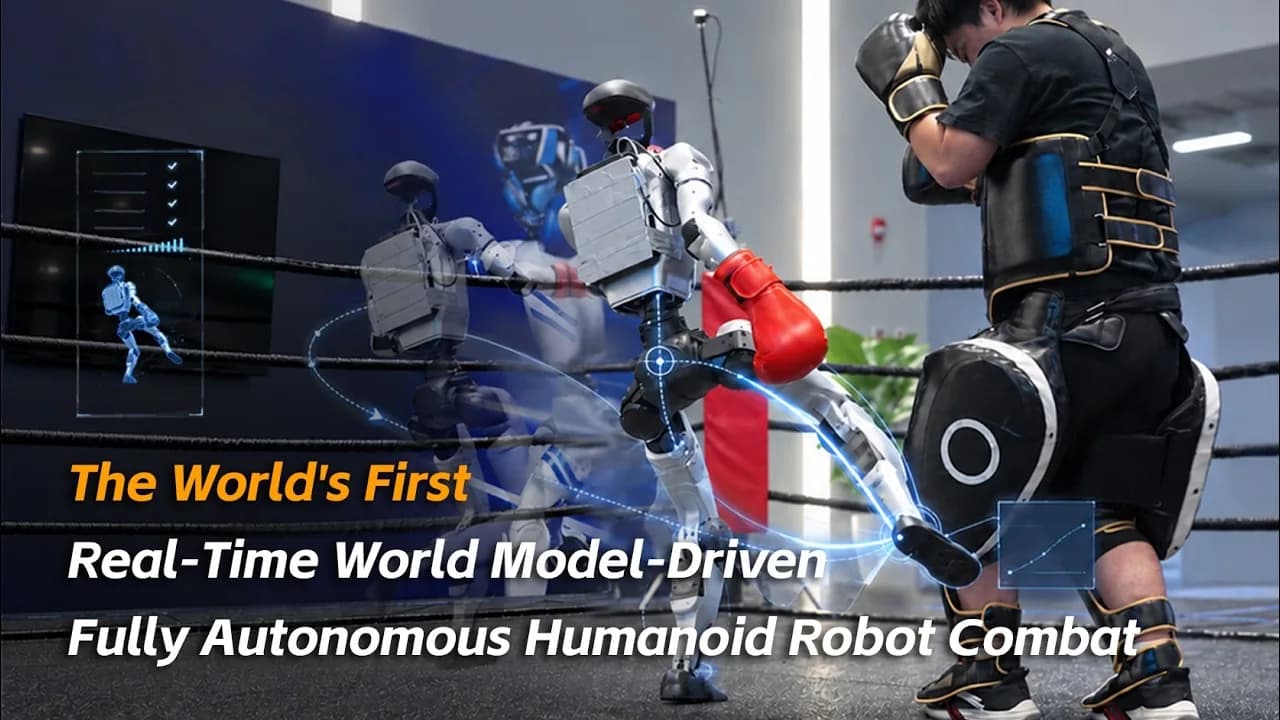
El modelo UnifoLM-X2-1.0 permite al G1 de Unitree esquivar golpes y ejecutar ataques sin intervención humana, marcando un hito en la robótica autónoma.

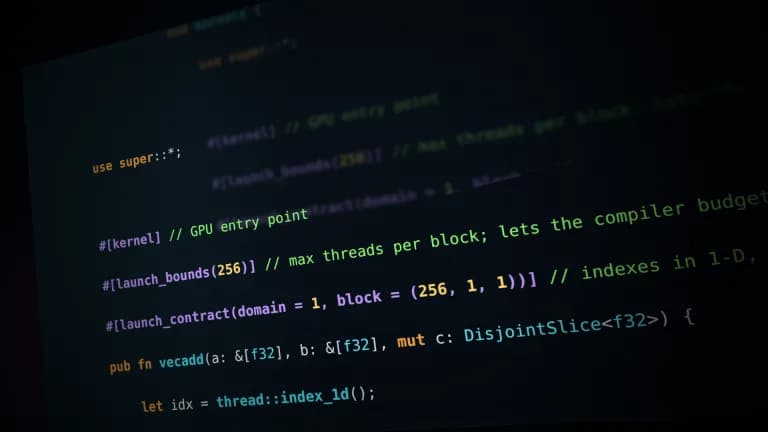
NVIDIA expande su ecosistema con dos nuevas vías para escribir kernels de GPU utilizando Rust, facilitando la seguridad y el rendimiento en el desarrollo.

Arm introduce su plataforma CSS for Mobile 2, integrando los nuevos núcleos C2-Ultra, C2-Pro y la GPU Mali G2-Ultra NX con aceleración de IA nativa.

La startup de Silicon Valley presenta su arquitectura DigAn, diseñada para eliminar el gasto energético del movimiento de datos en aplicaciones de IA en el borde.

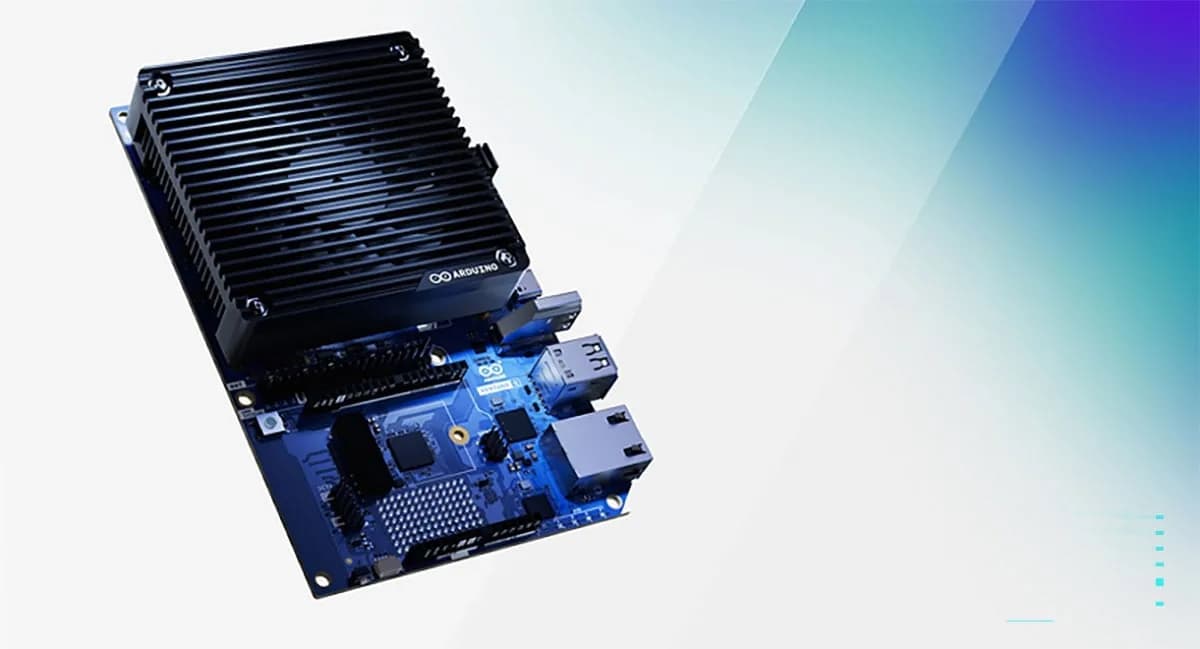
La nueva placa de Arduino, desarrollada junto a Qualcomm, combina un procesador de alto rendimiento con un microcontrolador de tiempo real para proyectos industriales.

Investigadores logran que un dron persiga a otro sin cámaras ni GPS, utilizando únicamente una matriz de micrófonos MEMS y redes neuronales para el seguimiento.

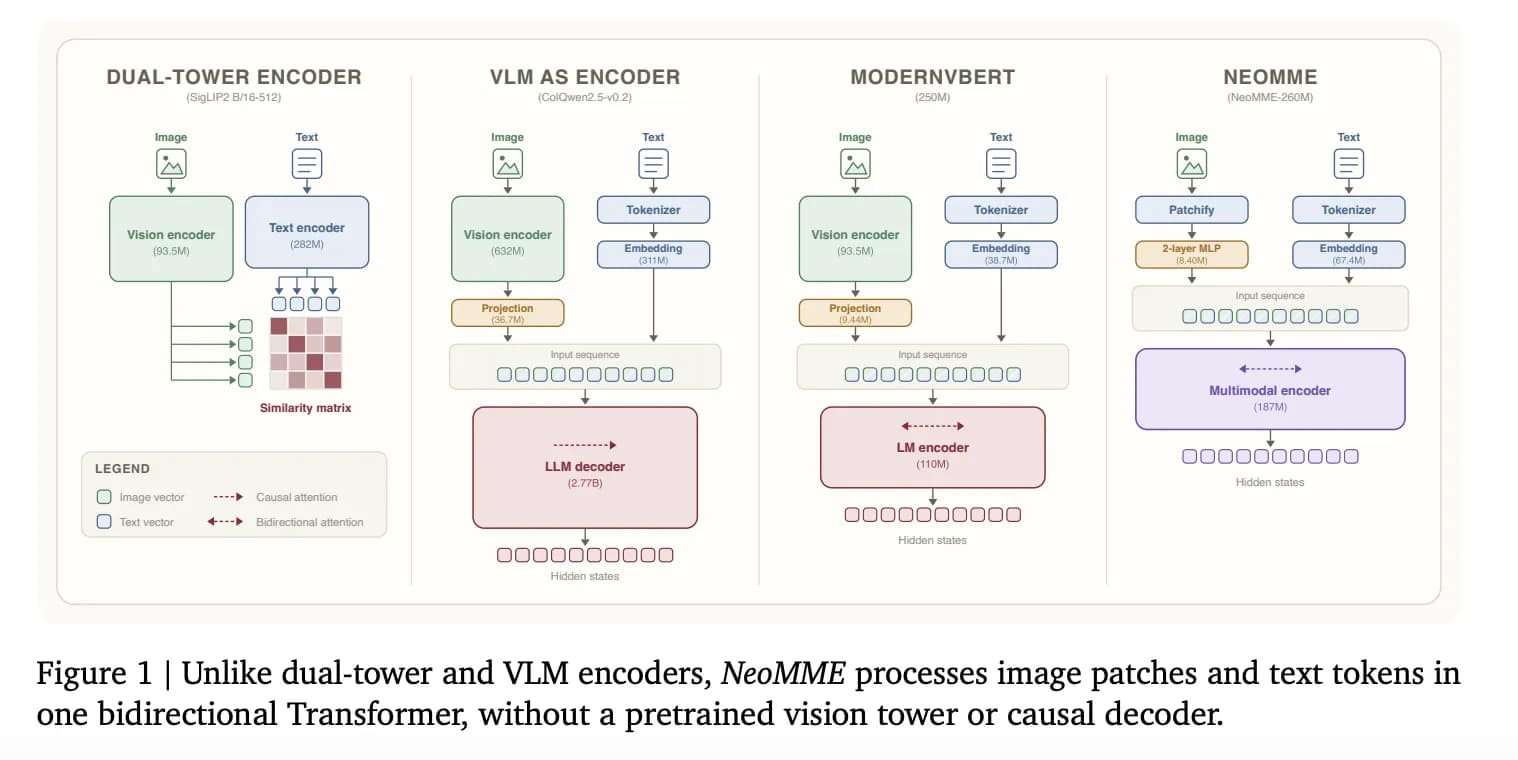
H Company presenta NeoMME, una familia de encoders multimodales que elimina la visión tower y el decoder causal para mejorar la eficiencia en tareas de recuperación.

La ingeniería detrás de Perplexity explica cómo Ivy, Tulip y ROSE gestionan la carga de trabajo para sus modelos de embedding a escala web.

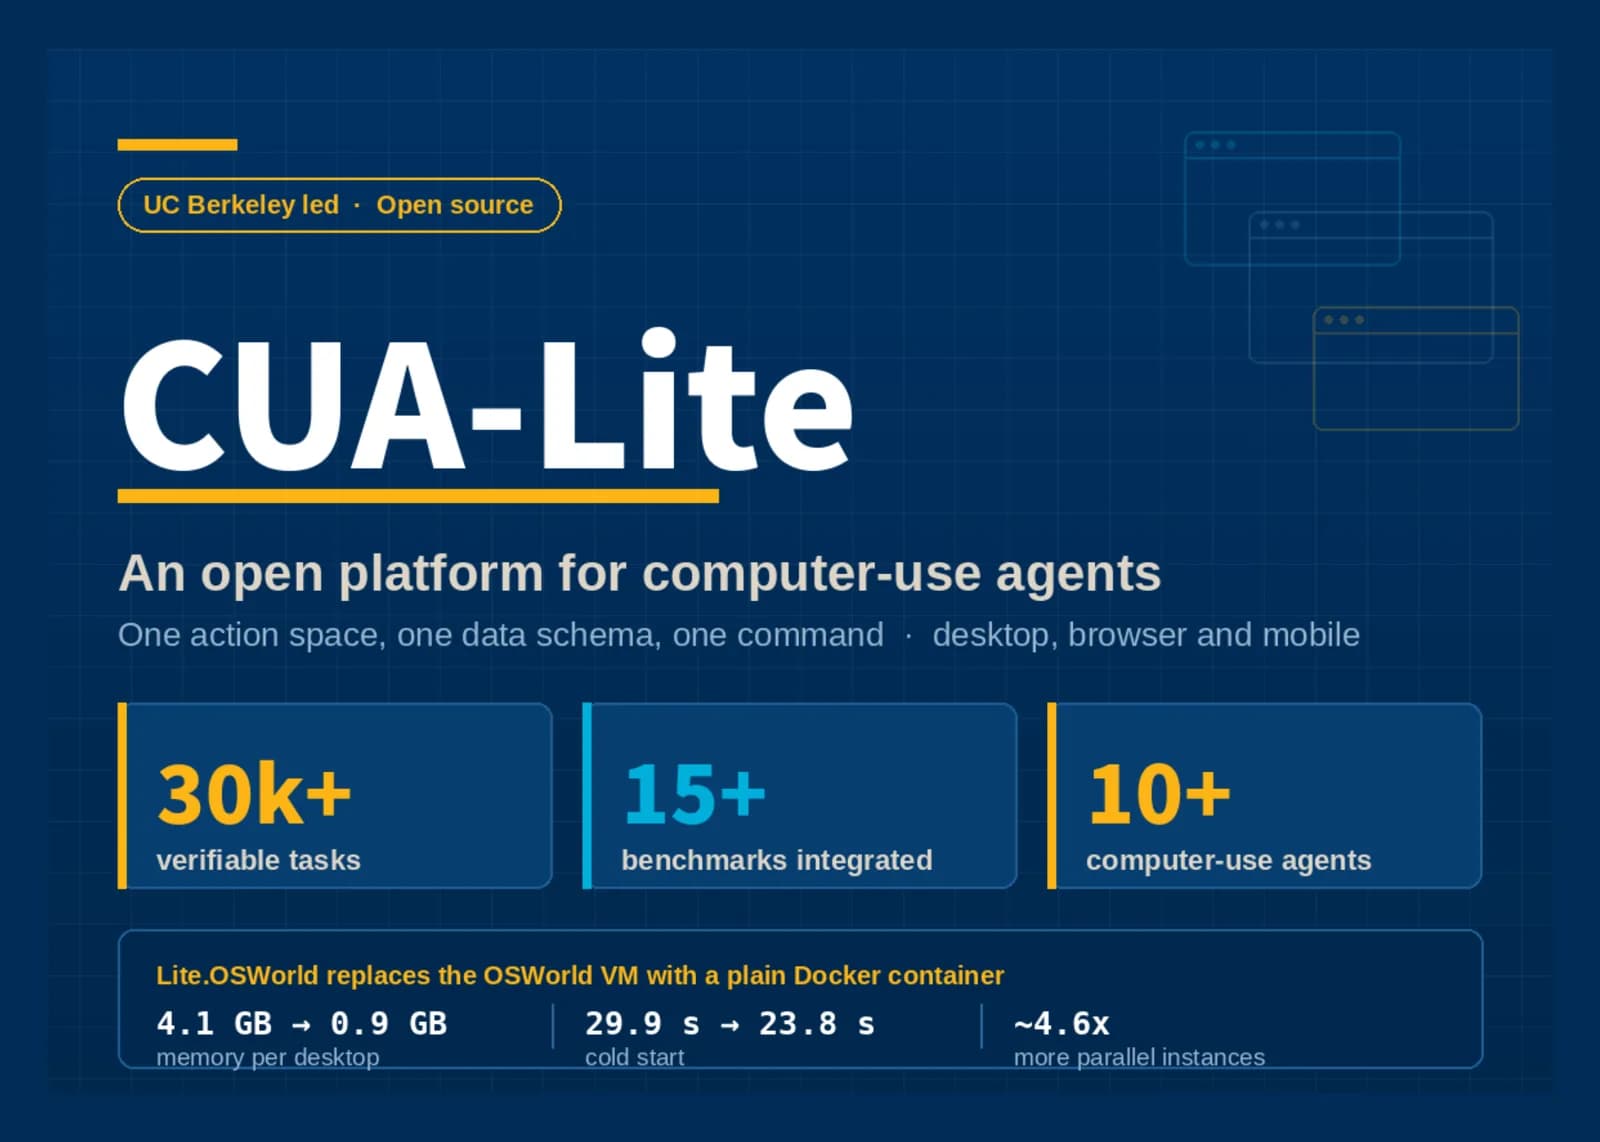
Investigadores de UC Berkeley presentan una plataforma unificada para entrenar, evaluar y ejecutar agentes de computadora (CUA) mediante contenedores ligeros.

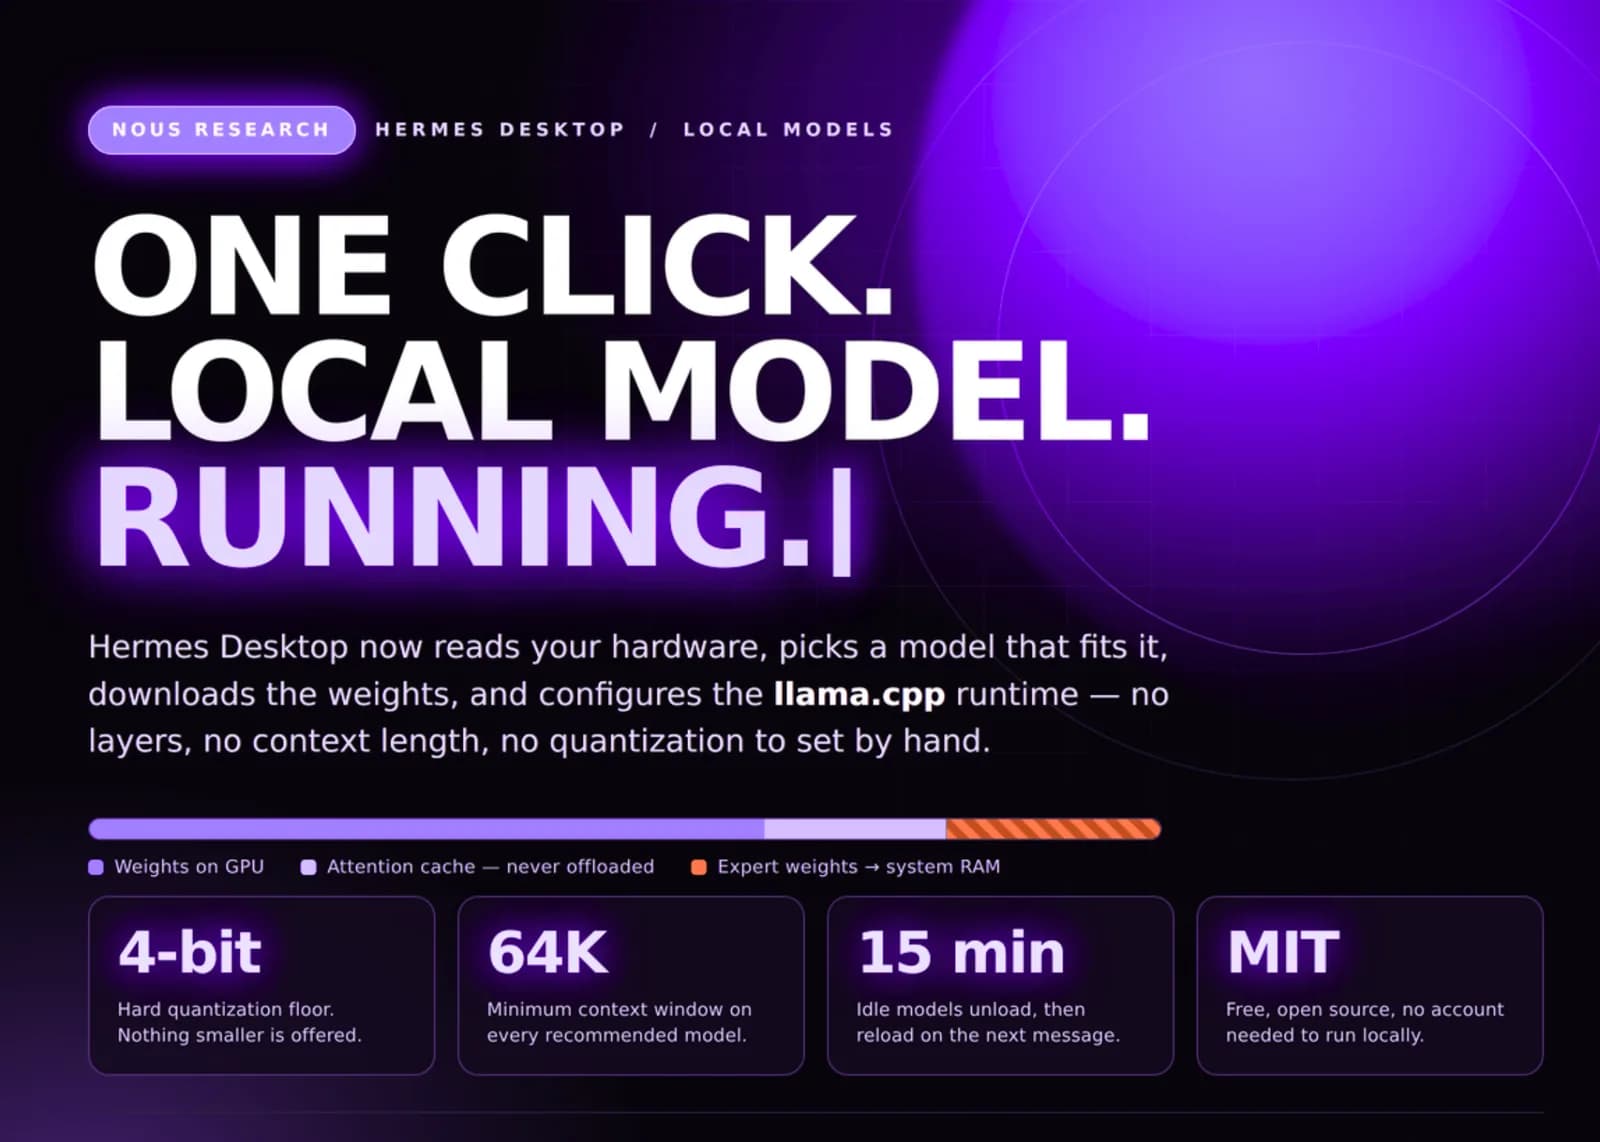
La nueva actualización de Nous Research automatiza la detección de hardware y el despliegue de modelos, eliminando la configuración manual de VRAM y cuantización.

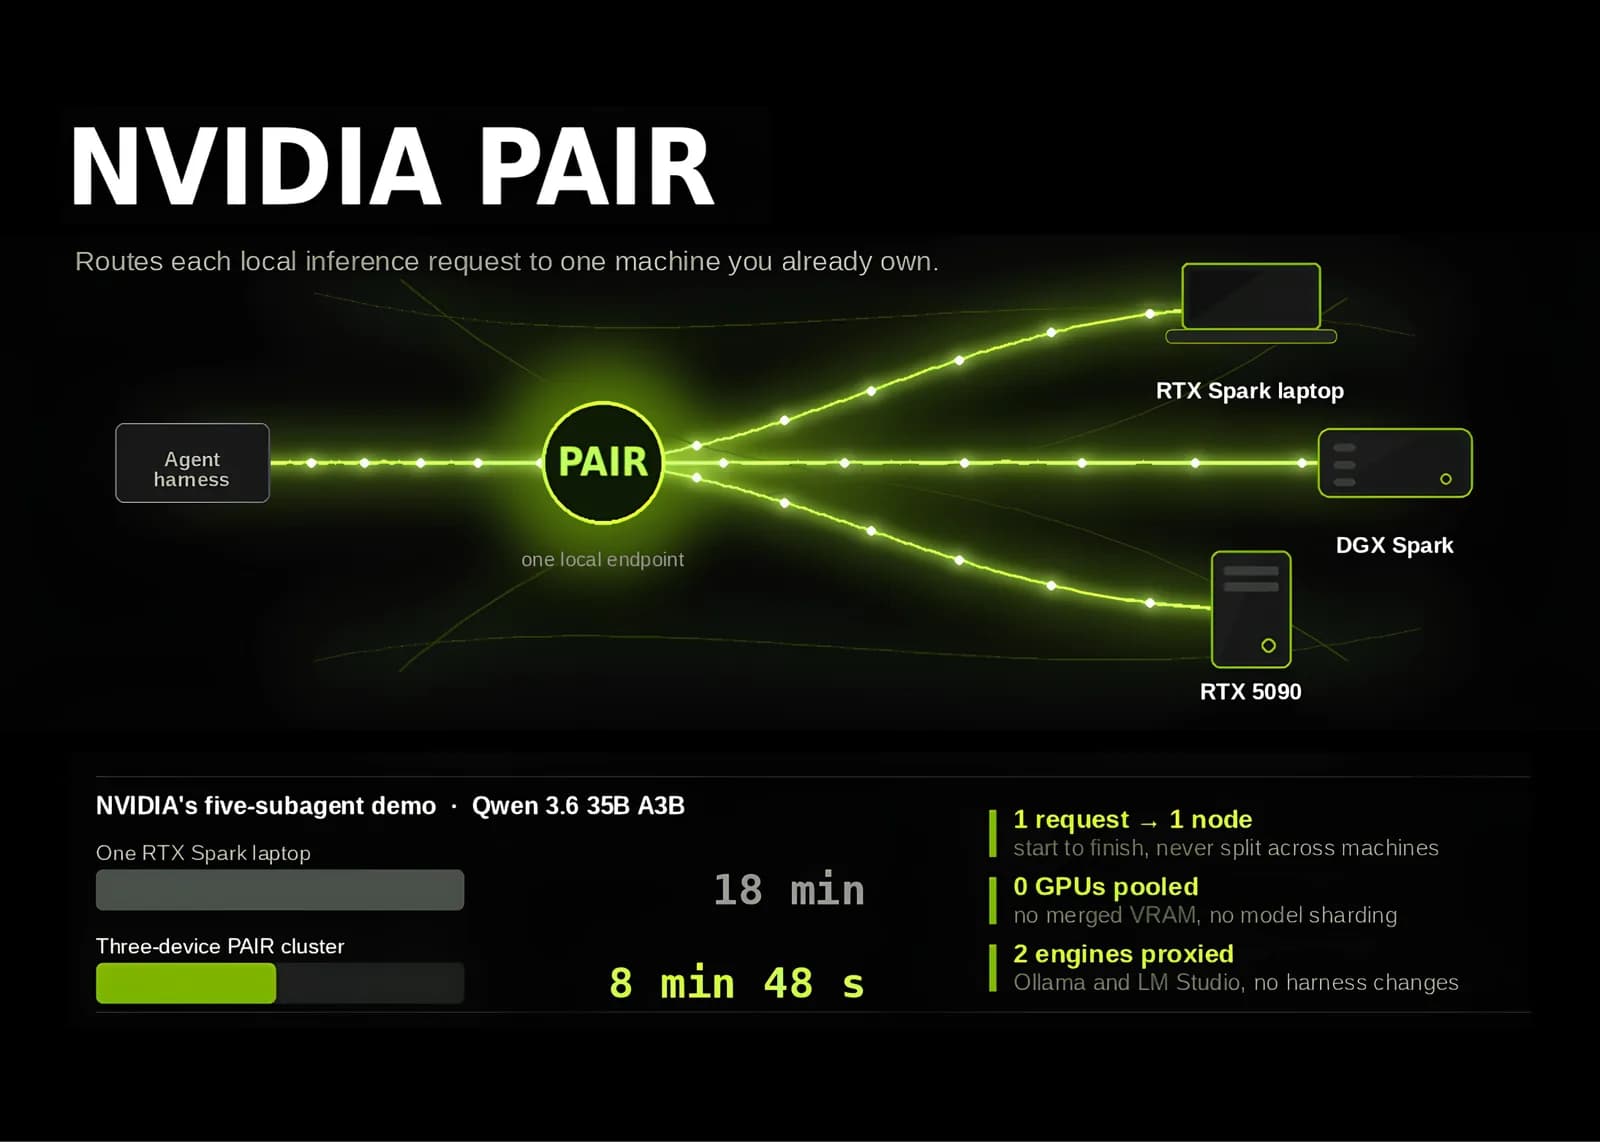
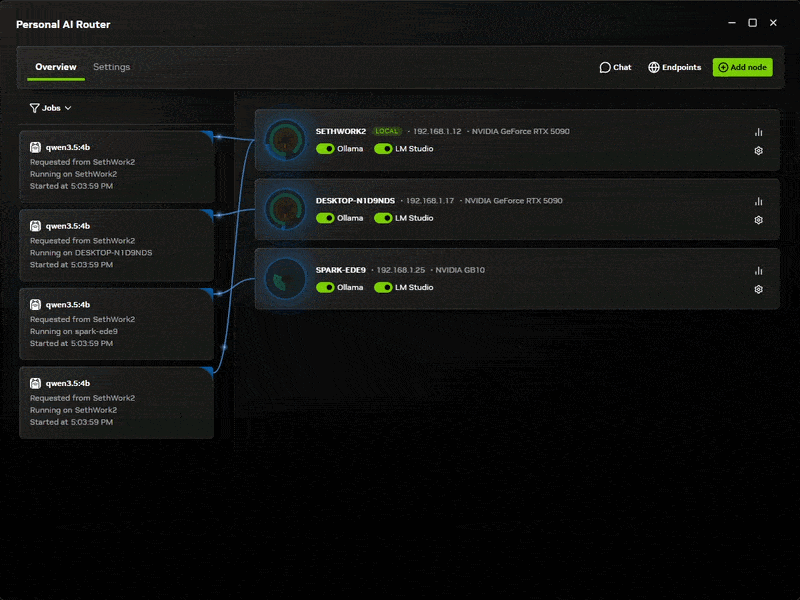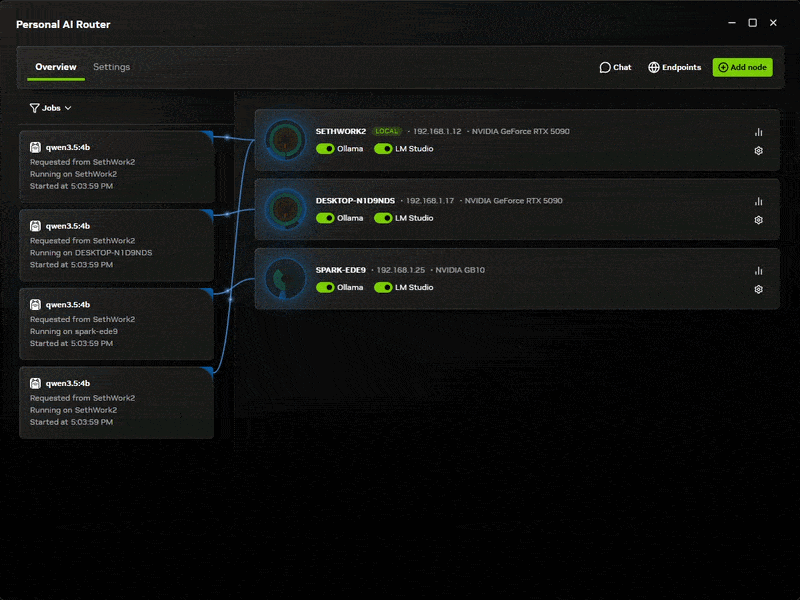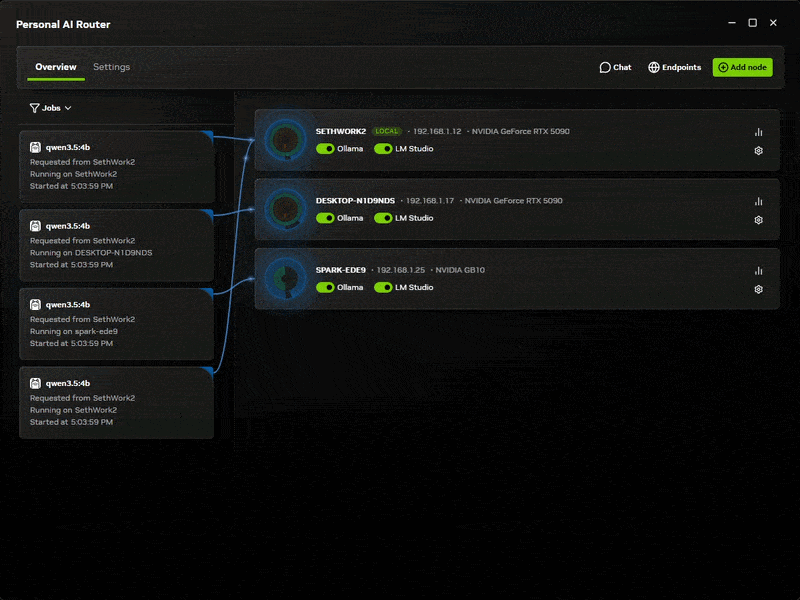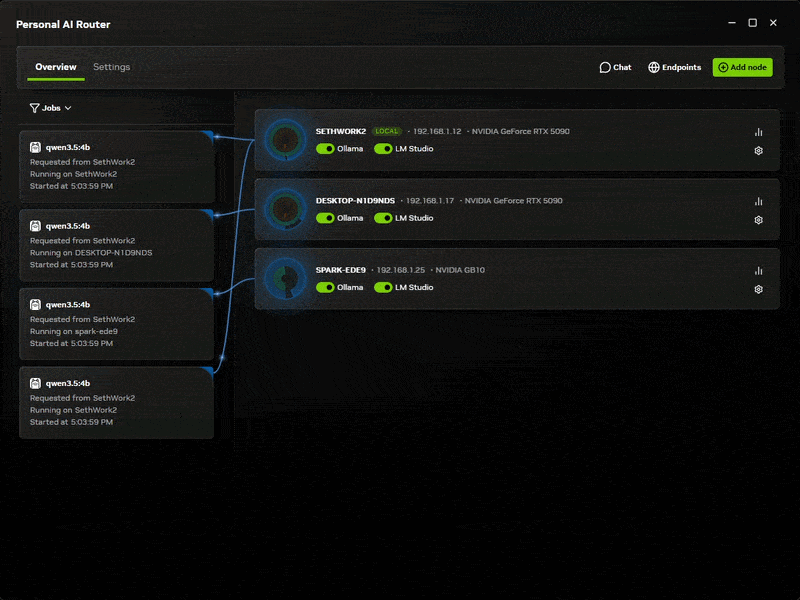
La herramienta, presentada en IFA 2026, manda subtareas de un agente local a los computadores de la red doméstica que tengan ciclos de GPU libres.

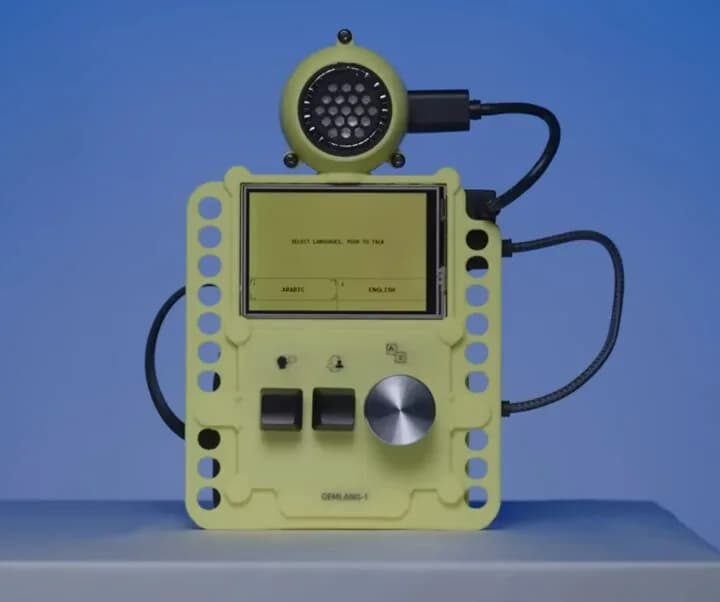
Un proyecto open-source basado en el modelo Gemma 4 y LiteRT que permite traducción de voz en tiempo real sin necesidad de conexión a la nube.

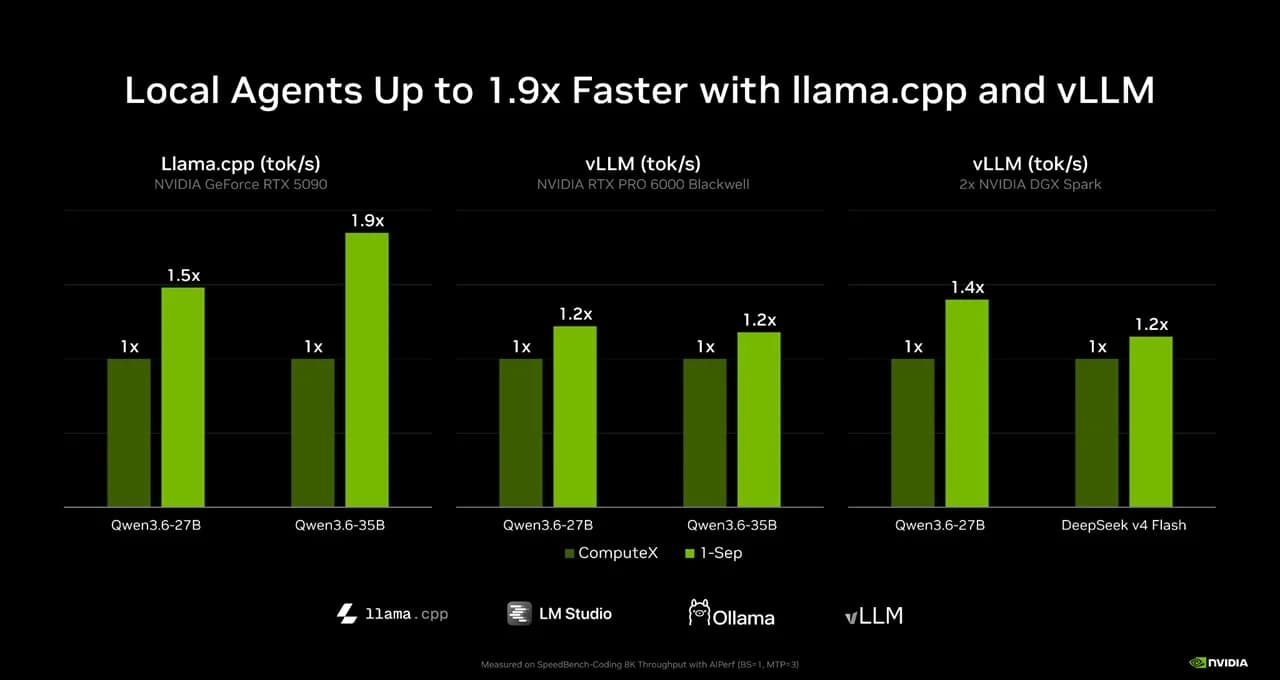
En IFA 2026 la empresa anunció configuración automática de modelos locales en Windows, inferencia hasta 1,9 veces más rápida con llama.cpp y la llegada de los equipos RTX Spark en octubre.

Presentada en IFA 2026, la estación combina un Threadripper PRO de 96 núcleos con hasta cuatro aceleradores Instinct y apunta directo a la DGX Station de Nvidia.

El nuevo router de inferencia virtual de código abierto de NVIDIA permite ejecutar flujos de trabajo multi-agente en una red local entre RTX, DGX y Mac.

La nueva herramienta de código abierto de Nvidia permite distribuir tareas de IA entre múltiples dispositivos de tu red, optimizando drásticamente los tiempos de procesamiento.

Un modelo de difusión cuantizado a 8 bits corre completo dentro de los 4 MB de memoria flash de una placa Waveshare y entrega la imagen por USB o por un adaptador VGA.

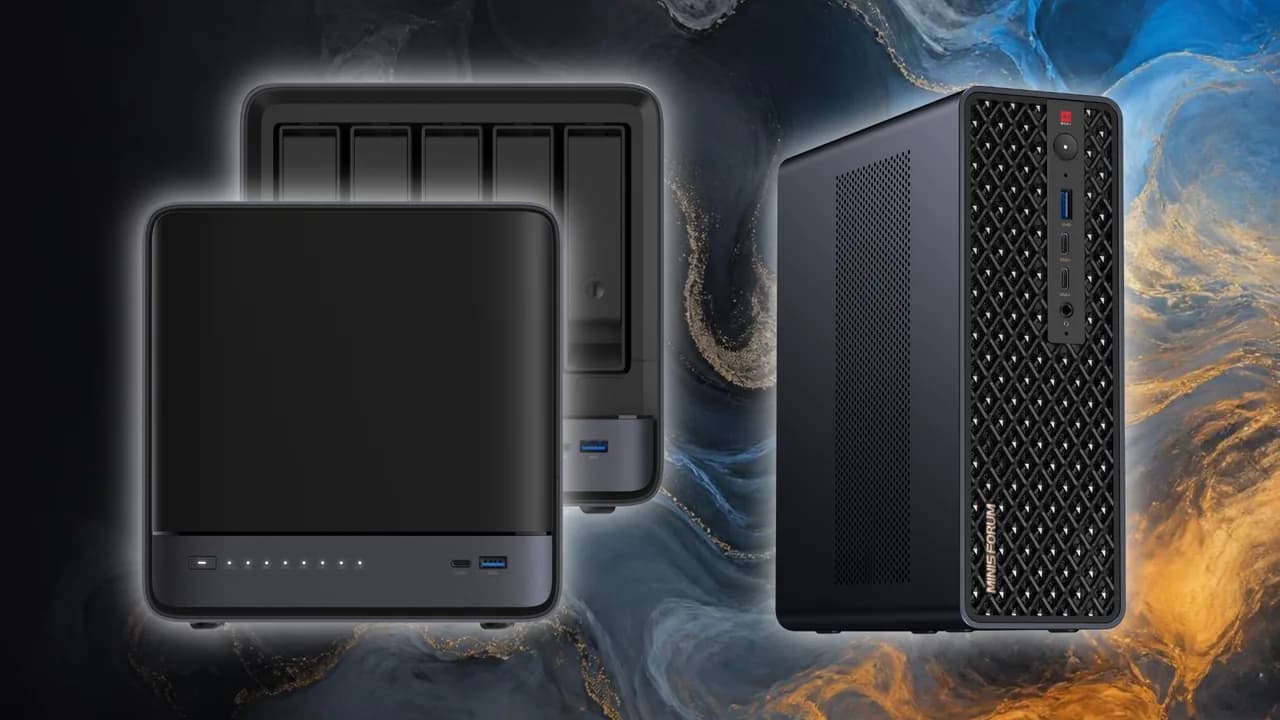
La marca presentó en IFA 2026 sus nuevas estaciones de trabajo y NAS equipadas con chips AMD Ryzen AI Max+ Pro 495, diseñadas para ejecutar modelos de IA de forma local.

NVIDIA lanza PAIR, una herramienta que permite repartir cargas de trabajo entre múltiples equipos de tu red local sin cambiar el código de tus agentes de IA.

Tres ingenieros de Google liberaron el código, el STL de la carcasa y las instrucciones de un traductor de voz que corre Gemma 4 E2B en local, sin enviar audio a ningún servidor.

El tutorial oficial de Raspberry Pi mide 433,17 tokens por segundo de prefill con Gemma 3 270M sobre la placa de 8 GB, sin enviar una sola consulta a la nube.

El costo promedio por millón de tokens ha bajado drásticamente en dos meses, impulsado por modelos abiertos de origen chino y una competencia feroz en el sector.

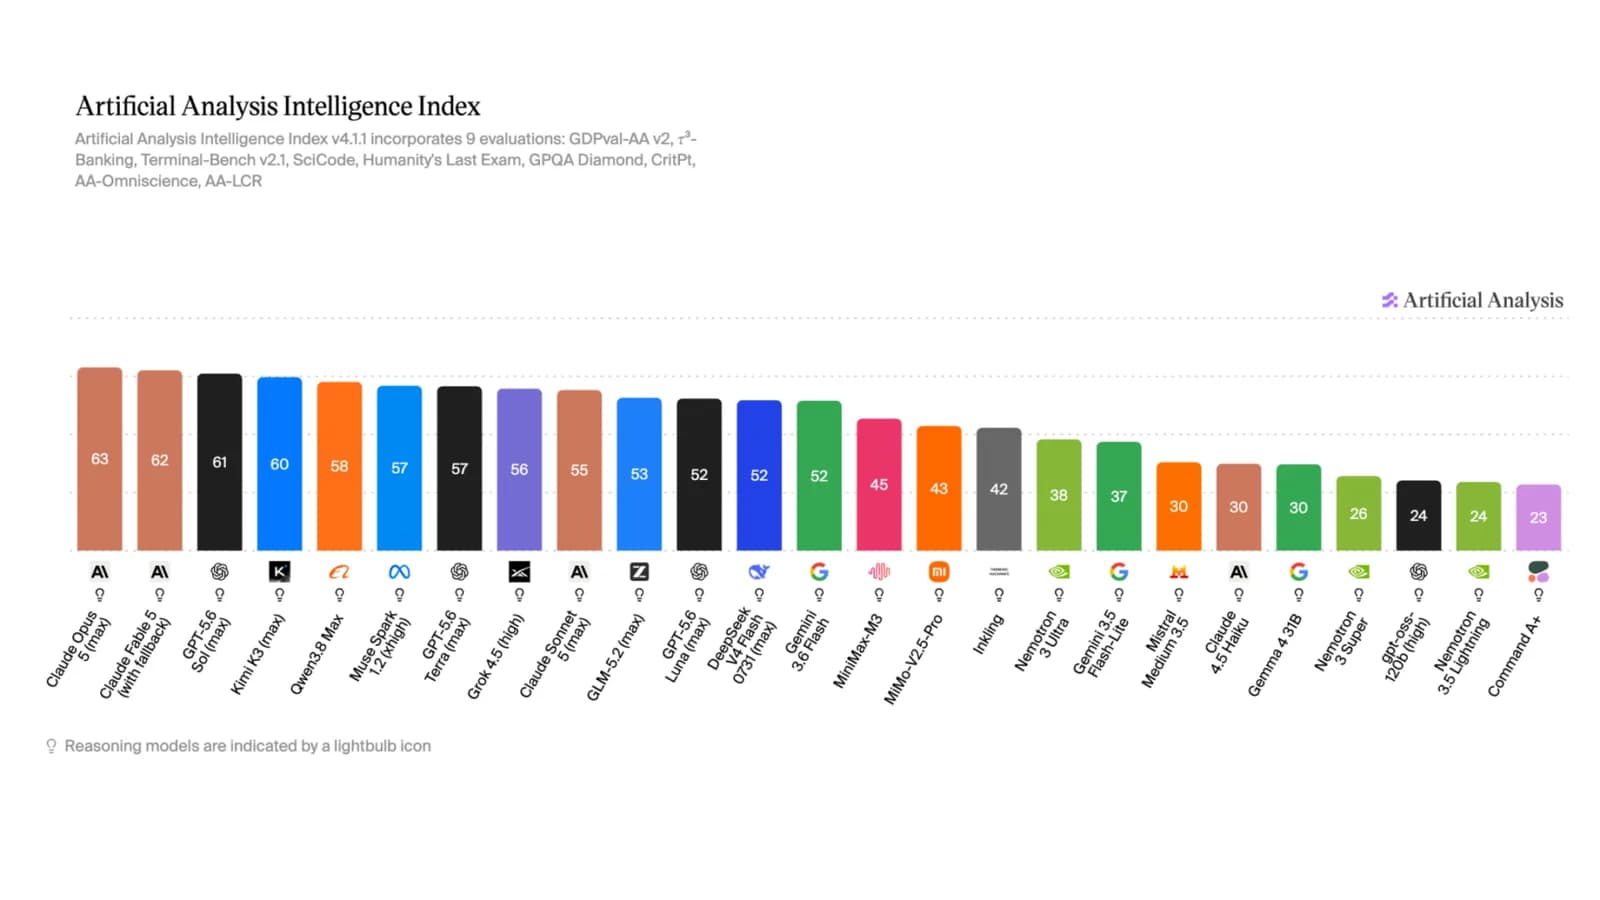
NVIDIA expande su familia Nemotron con un modelo de 30B parámetros diseñado para agentes inteligentes, optimizado para ejecución local y menores costos.

NVIDIA expande su ecosistema con el modelo Nemotron 3.5 Lightning y la biblioteca NeMo Switchyard para optimizar el despliegue de agentes IA autónomos.

Meta retoma el desarrollo de modelos de pesos abiertos con Muse Glimmer, un sistema de 30B optimizado para tareas complejas y uso de herramientas bajo licencia Apache 2.0.

La nueva actualización de la API Vulkan introduce la extensión VK_EXT_cooperative_matrix_maintenance1, optimizando el rendimiento en machine learning e inferencia.

El resumen semanal de robótica incluye drones de carga pesada en el desafío de DARPA, helicópteros marcianos de la NASA y avances en manos humanoides.

Ante el alza de precios en discos duros y SSD, un entusiasta recurre a la tecnología BDXL para gestionar su biblioteca musical de forma económica y segura.

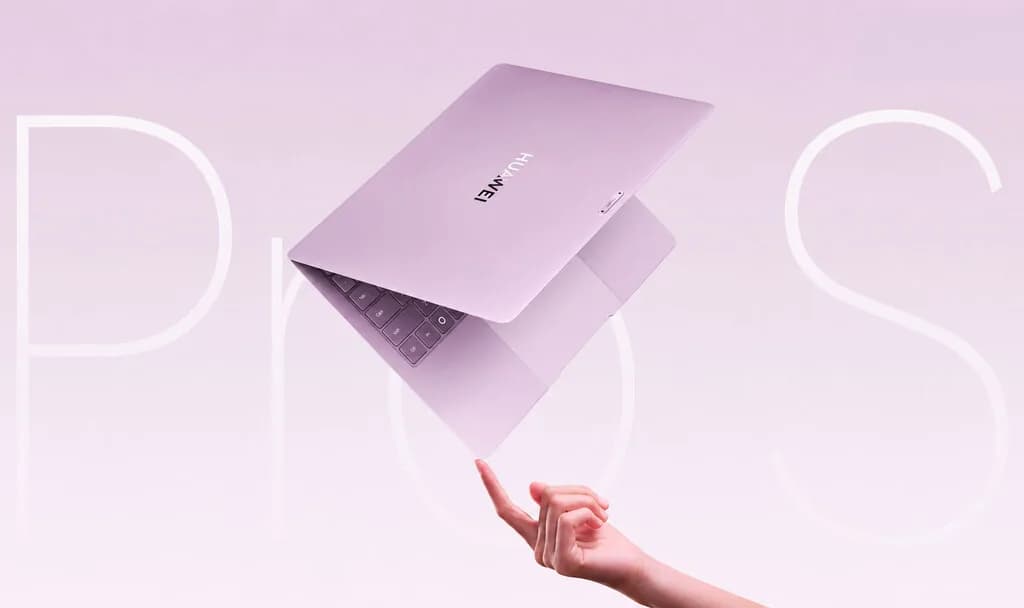
Huawei presenta el MateBook Pro S, un portátil de 798 gramos con procesador Kirin XE90 y HarmonyOS, marcando un hito en su independencia tecnológica frente al veto de EE. UU.

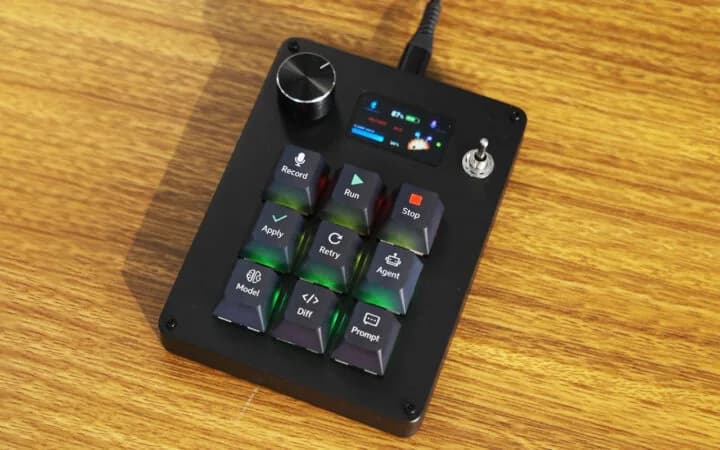
Un teclado macro programable con pantalla LCD, encoder rotativo y 9 teclas mecánicas, diseñado para gestionar herramientas de IA y comandos de voz.

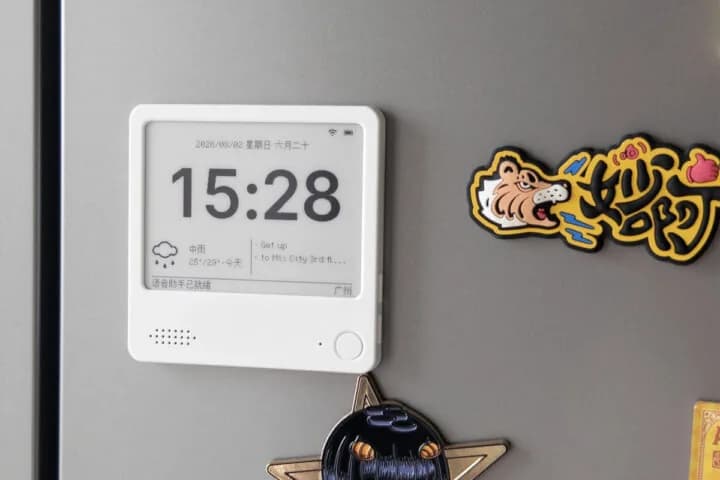
Un dispositivo de 4.2 pulgadas con ESP32-S3, soporte de voz y firmware abierto para proyectos de domótica, recordatorios y asistentes inteligentes.

El nuevo sistema generativo omnimodal MiniMax-H3 ya tiene soporte para Apple Silicon. Analizamos los requisitos de hardware y el proceso de instalación vía MLX.

El nuevo modelo VLA de 34 mil millones de parámetros combina razonamiento y acción para transformar el desarrollo y la validación de vehículos autónomos.

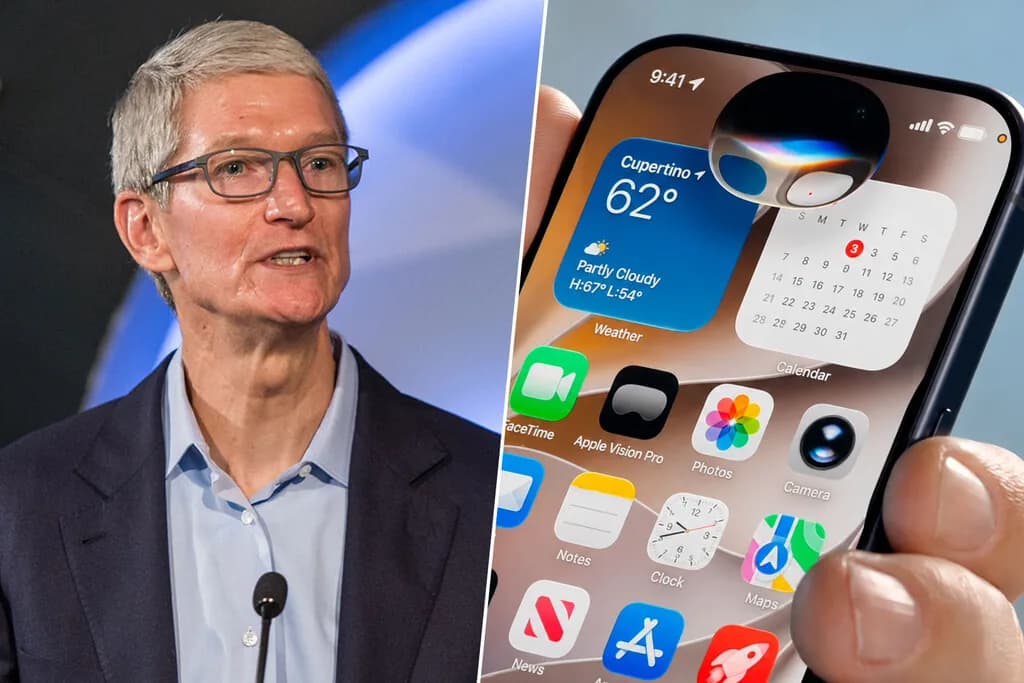
Tim Cook anticipa que la versión avanzada del asistente integrará un modelo de suscripción premium para usuarios con alta demanda de procesamiento.

DeepSeek lanza una actualización clave en su modelo V4-Flash, optimizando capacidades de agentes y eficiencia de costos sin alterar su arquitectura base.

La nueva actualización del SDK de video de NVIDIA introduce mejoras críticas en la transcodificación, eficiencia de bitrate y acceso preciso a frames para flujos de trabajo en IA.

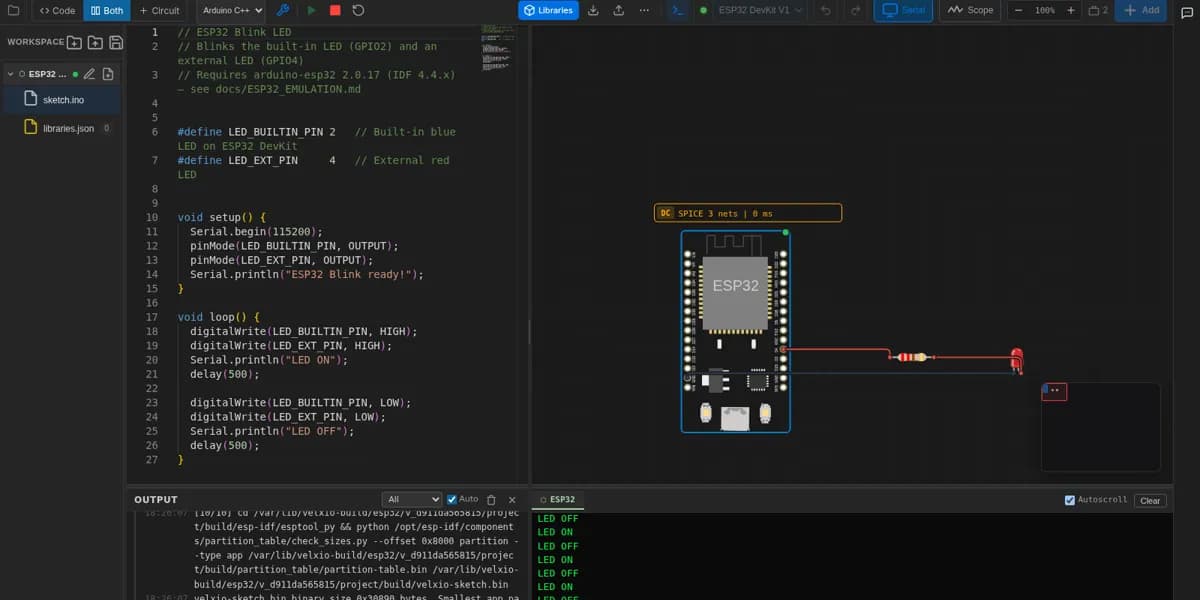
Velxio permite ejecutar firmware real de ESP32 en un navegador, integrando componentes analógicos, digitales y agentes de IA para un desarrollo eficiente.

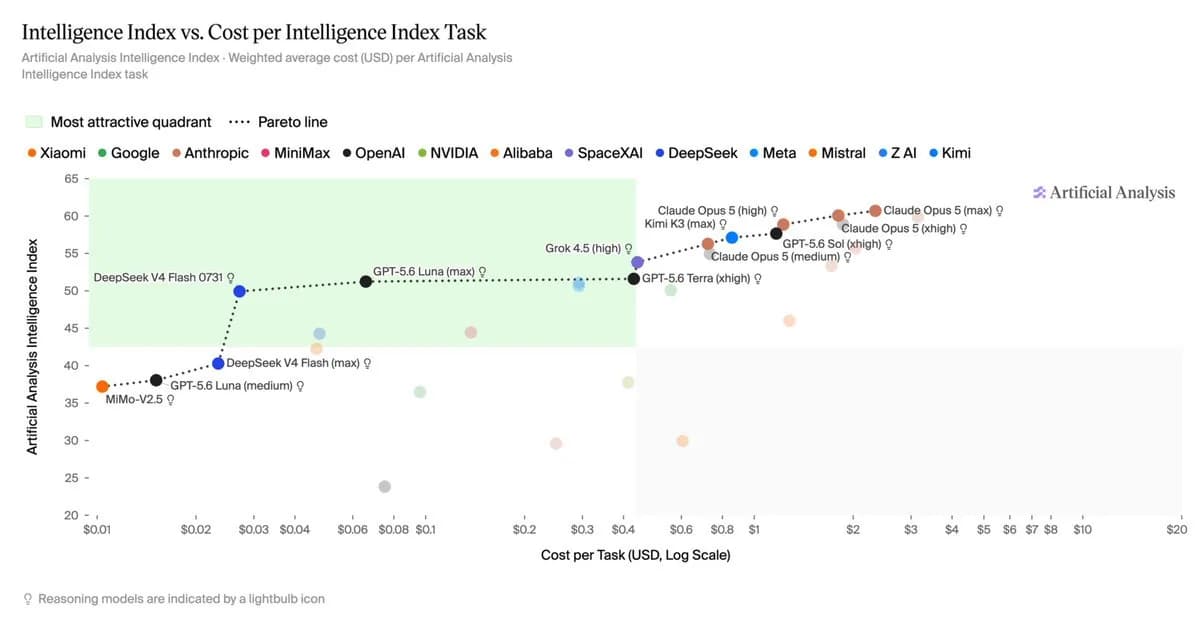
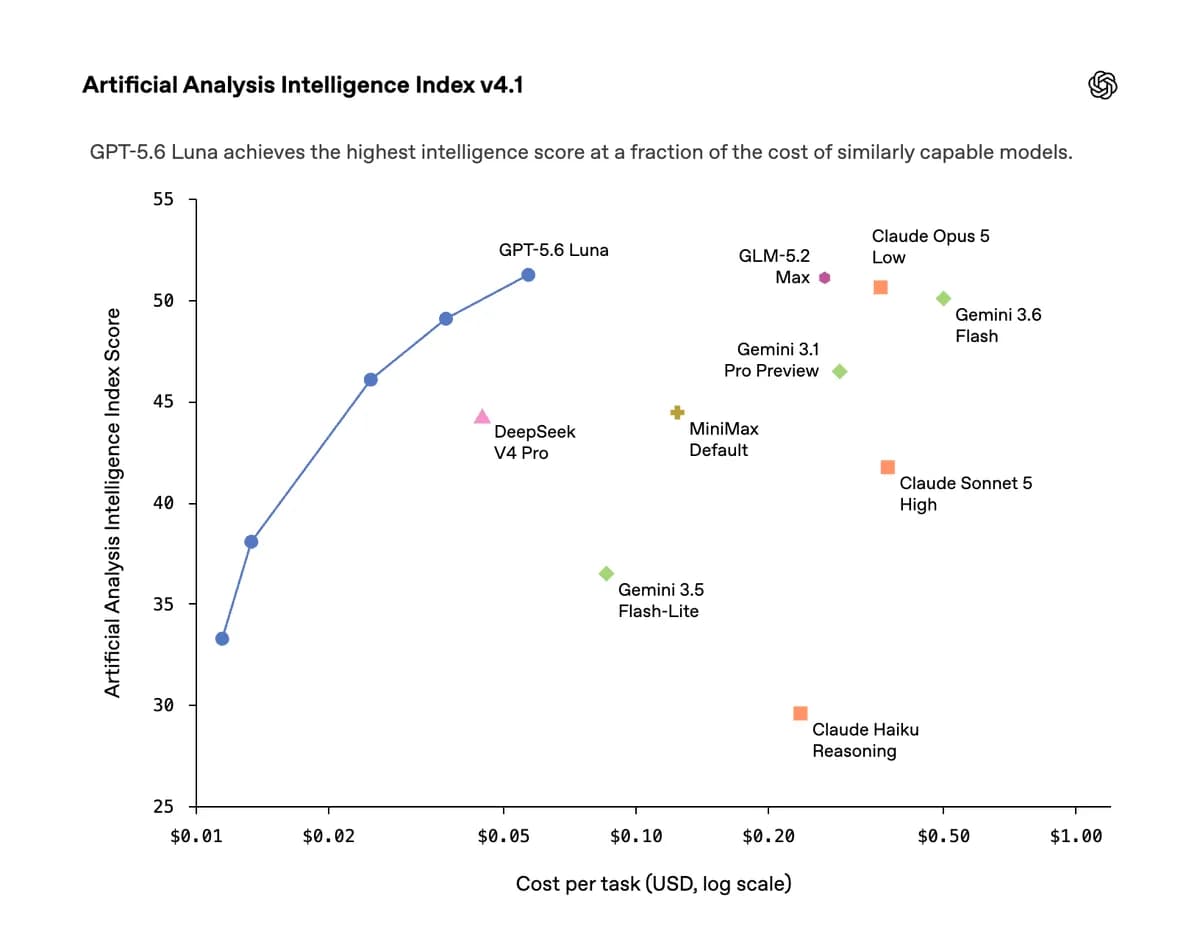
OpenAI implementa optimizaciones en su stack de inferencia y harness, logrando reducciones drásticas de costos y mayor eficiencia en modelos como Luna y Sol.

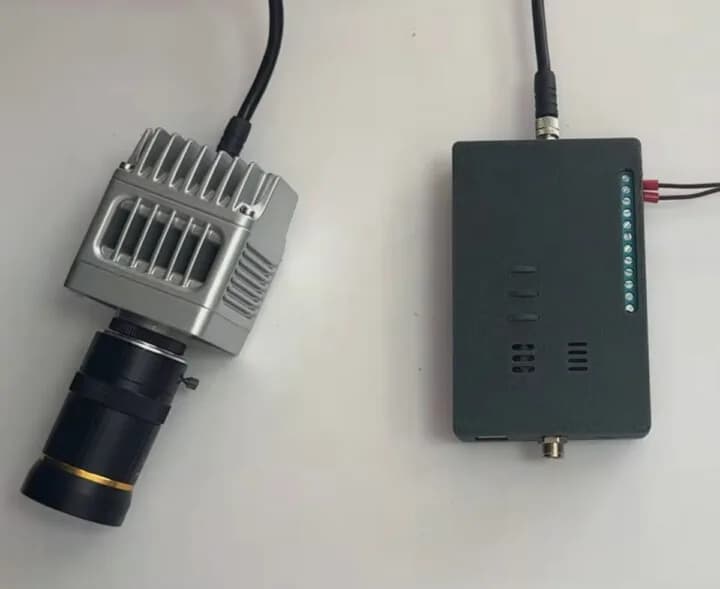
El nuevo módulo de expansión de Luxonis integra GPIO, relés y CAN Bus a las cámaras OAK4, permitiendo un control directo de maquinaria sin necesidad de un PLC externo.

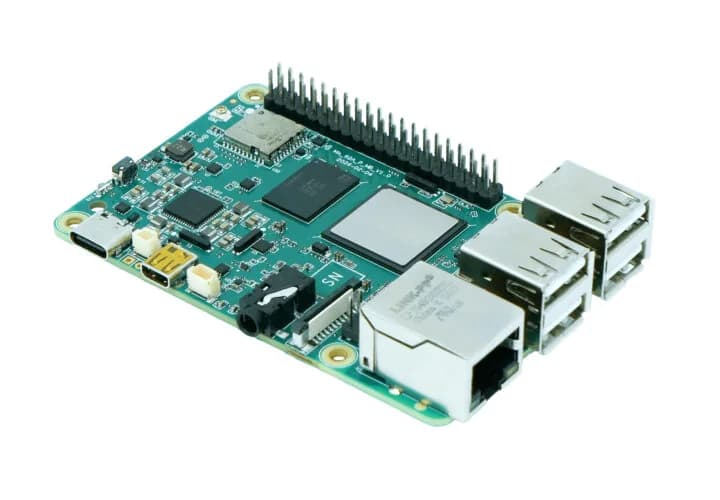
InHand Networks presenta sus nuevas computadoras de placa única (SBC) de tamaño compacto, diseñadas para visión artificial industrial y capacidades de IA local.
Otros temas que aparecen junto a #ia local en nuestra cobertura editorial.