
Electrónica
Meta ya sirve IA en producción sobre las TPU de Google
Lo hace con una versión de SGLang escrita para PyTorch nativo, y un vLLM equivalente marcó 700 tokens por segundo contra 452 de 16 GB200.
Tom's Hardware
14 notas publicadas
La biblioteca ZenDNN de AMD pasa a formar parte de oneDNN, el backend abierto que Intel impulsa desde la UXL Foundation.
El nuevo backend de código abierto ejecuta modelos de PyTorch en las TPU de Google cambiando cuda por tpu, y ya se validó con los 5.000 modelos más descargados de Hugging Face.
La herramienta de AWS promete llevar una app de PyTorch a Trainium cambiando una sola línea de configuración, sin reescribir código.
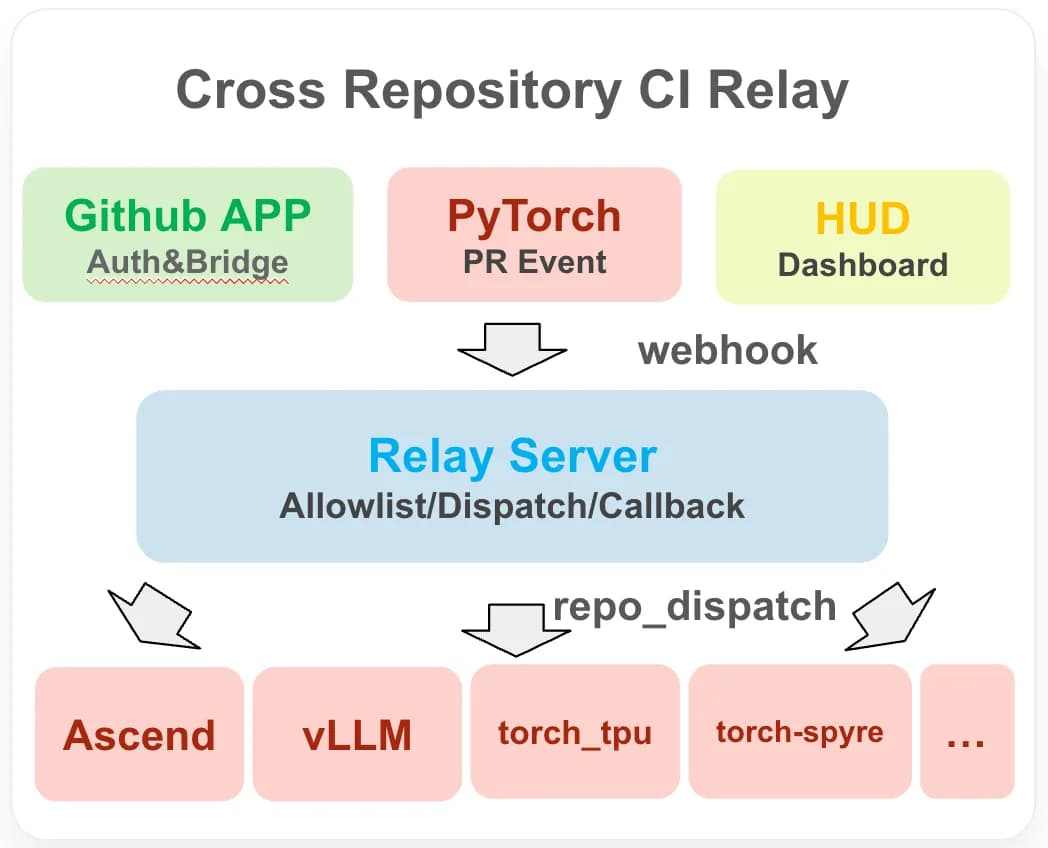
El grupo de integración de aceleradores de PyTorch resumió su primer semestre de 2026, con un relé de CI entre repositorios, pruebas independientes del hardware y perfilado para backends externos.
Un solo kernel GEMM escrito en Helion cubre las variantes estándar, Split-K y Swap-AB, y el autoajuste elige la mejor para cada forma de entrada.
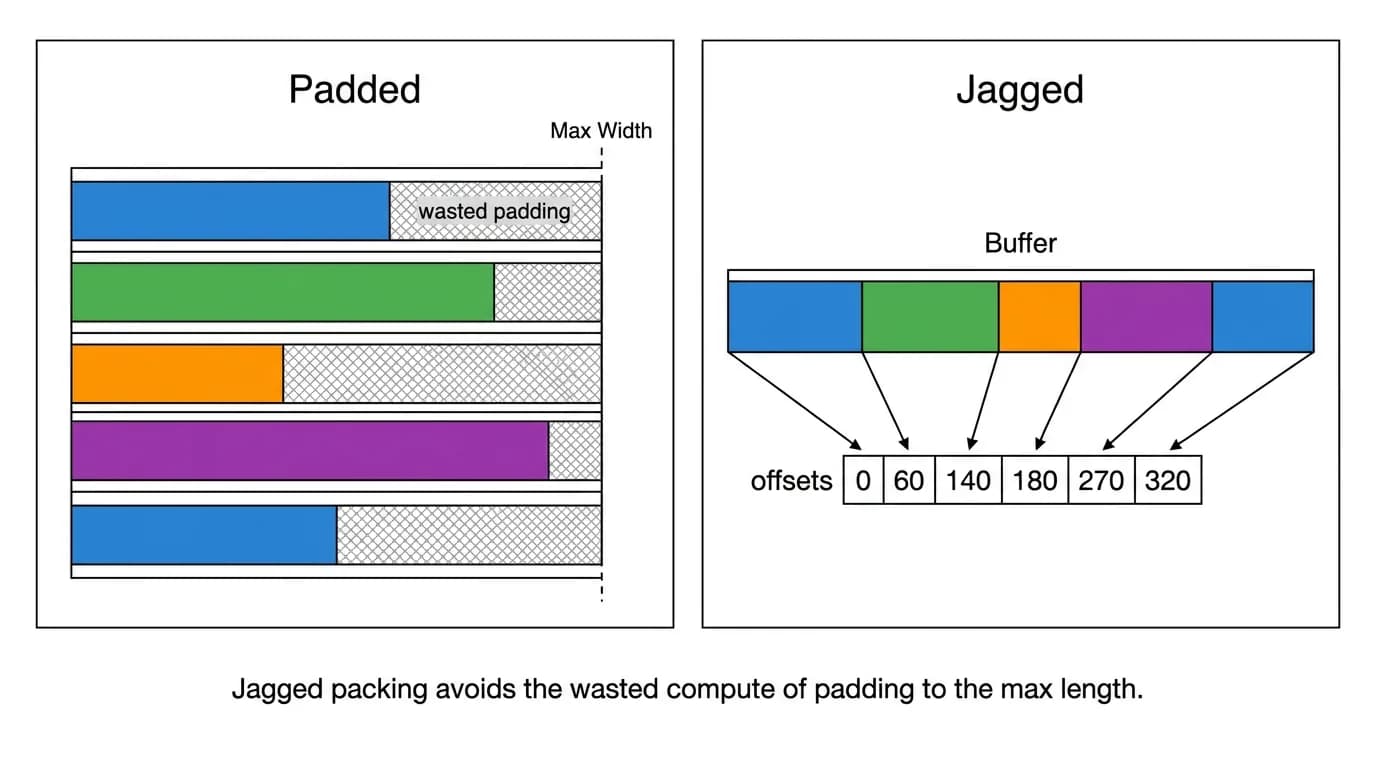
El kernel de atención irregular de su modelo de anuncios GEM, escrito con las extensiones TLX, mide 3.200 líneas y gana 13% en la pasada hacia adelante y 50% en la de retropropagación.
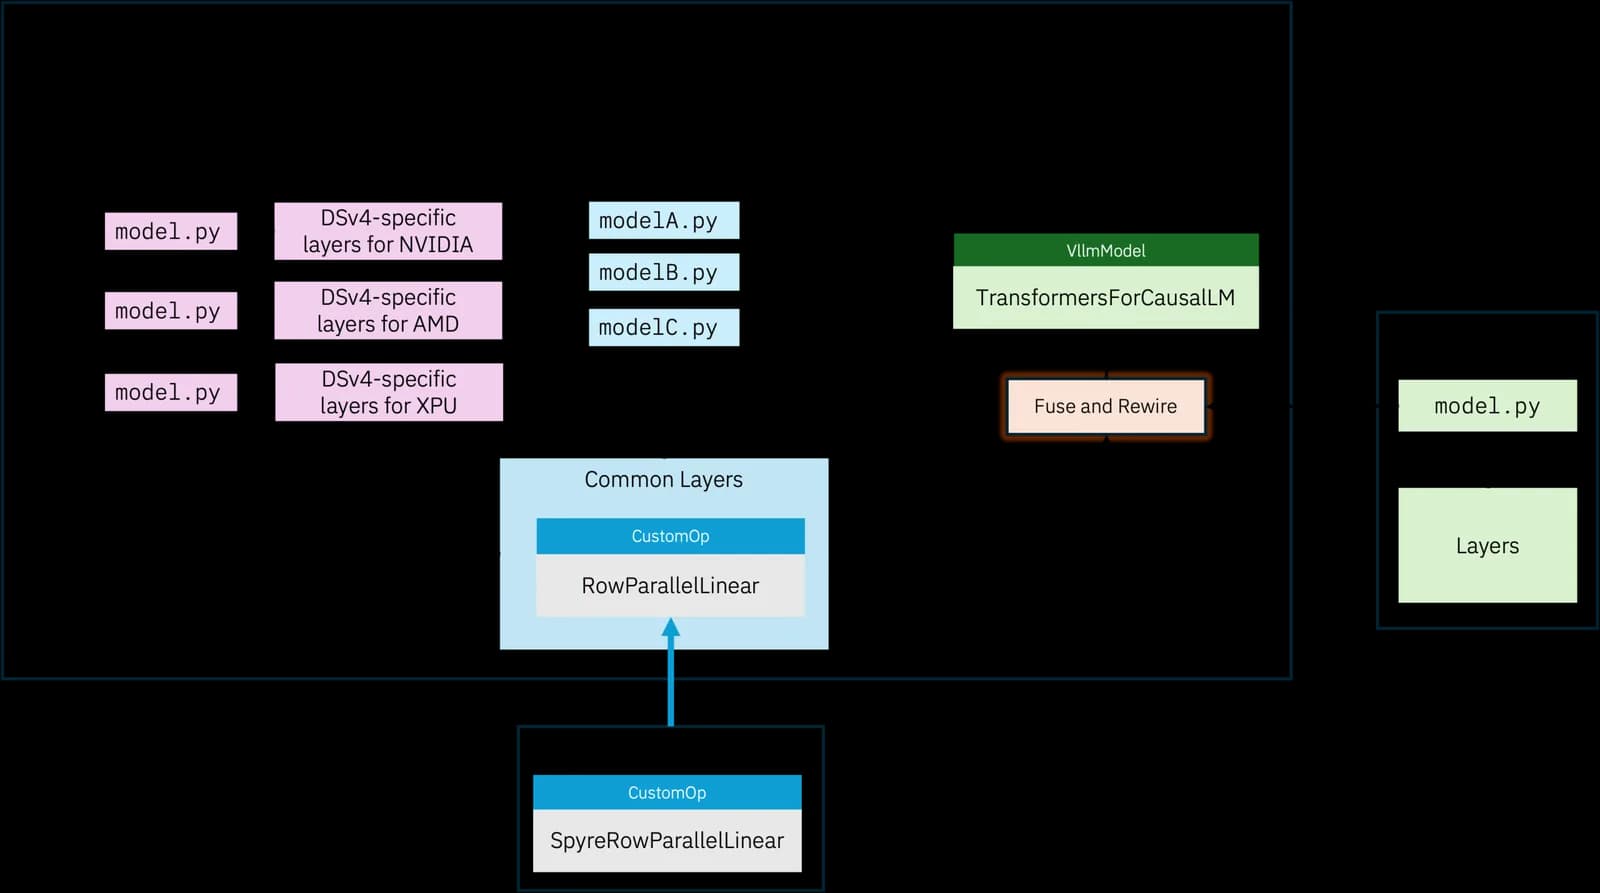
El motor de inferencia rompió la compatibilidad con torch.compile para correr más rápido en las GPU nuevas, y ahora construye un camino aparte para las viejas.
El circuito convierte a diario las conversaciones que fallan en producción en datos de entrenamiento, y el modelo especializado terminó superando al de frontera.
La integración reutiliza los kernels de ggml, parte por los Mac con Apple Silicon y arranca con la arquitectura Qwen3.5.
El lenguaje de dominio específico de PyTorch para escribir kernels de alto rendimiento ya se puede empaquetar, autoajustar y distribuir desde el Hub, con configuraciones preajustadas incluidas.
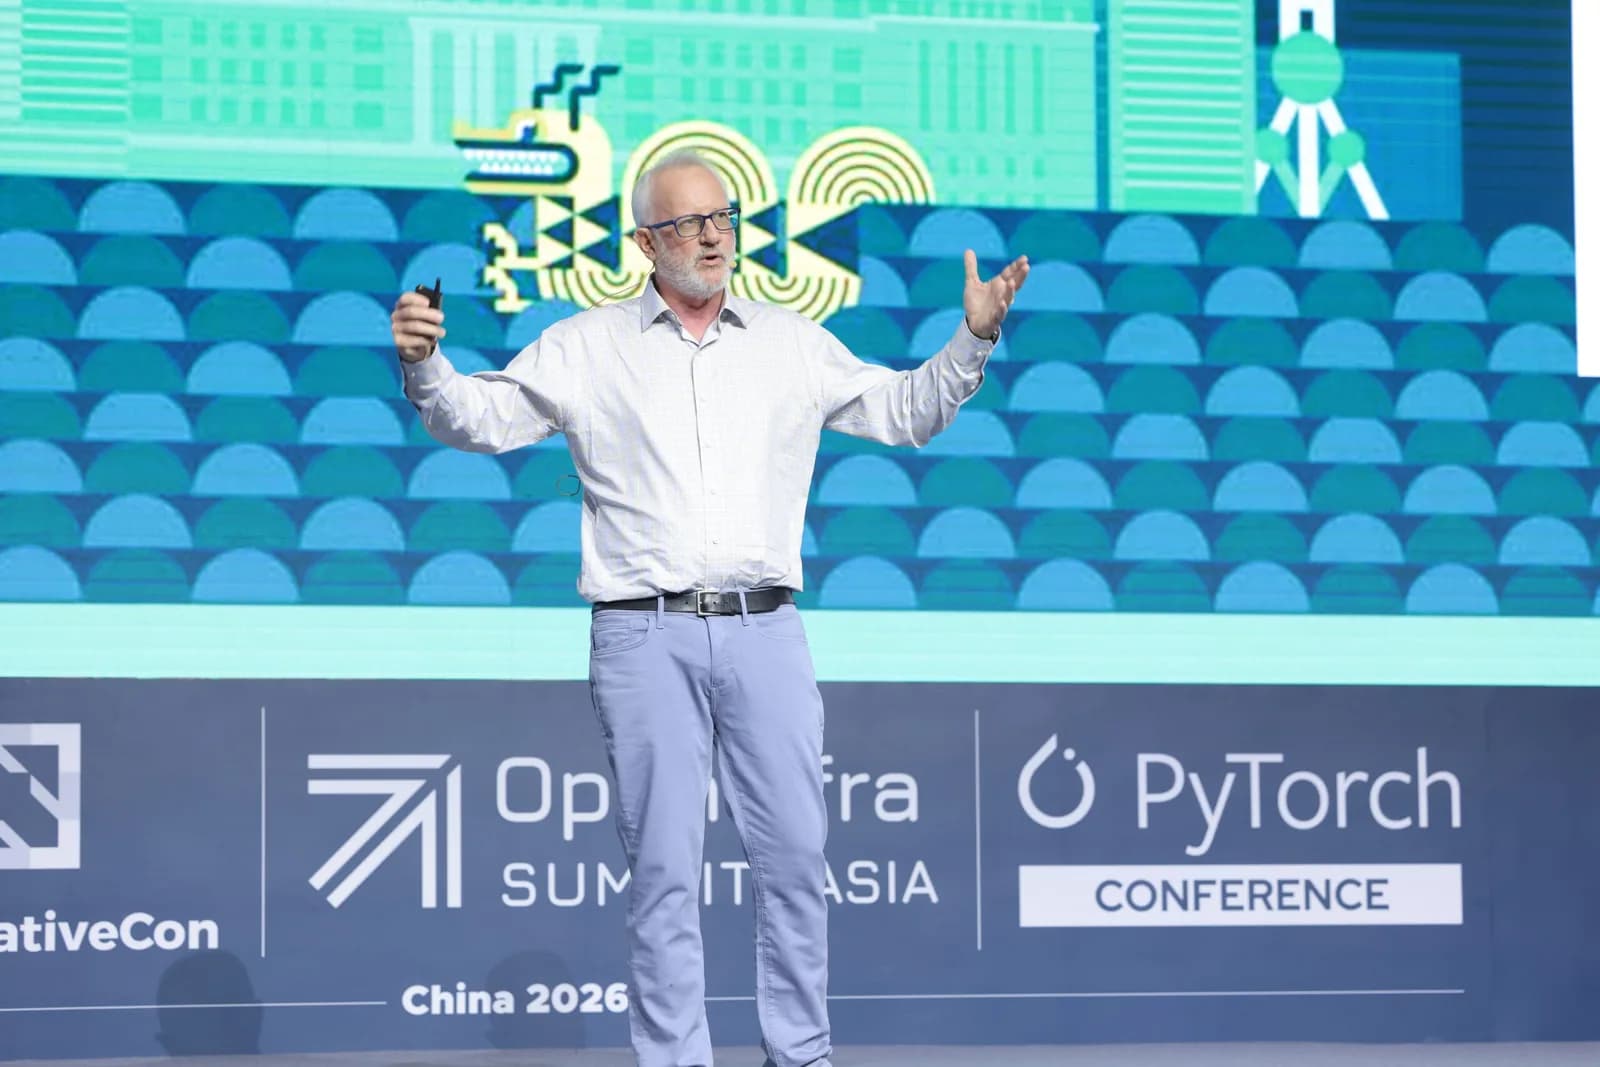
La conferencia en Shanghái sumó tres miembros a la fundación y dejó una cifra que ordena el panorama: los modelos de pesos abiertos chinos pasaron del 2 al 45 por ciento del tráfico en OpenRouter.
Hugging Face abre una serie de tres partes sobre profiling con PyTorch, empezando por matmul más bias en bf16 sobre una NVIDIA A100 80GB.
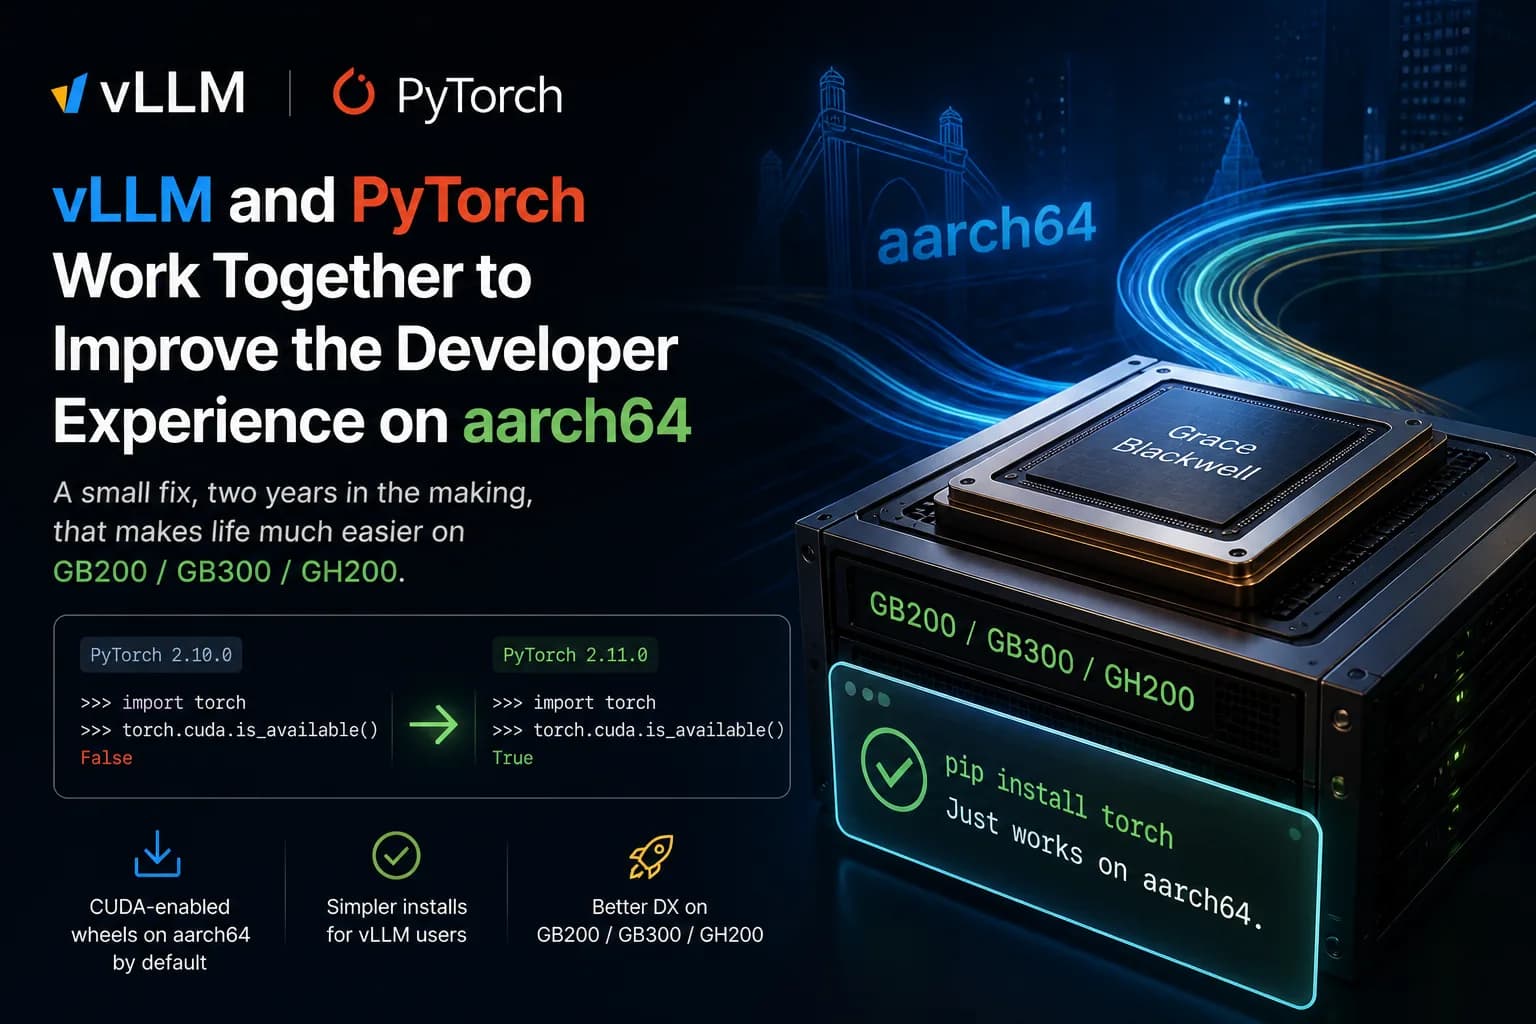
El nuevo wheel CUDA para aarch64 ya viaja en el índice por defecto de PyPI, cerrando dos años de --index-url y reinstalaciones silenciosas que rompían vLLM en Grace Hopper.
Otros temas que aparecen junto a #pytorch en nuestra cobertura editorial.