
Tesla Robotaxi: 170 viajes sin supervisor humano en Austin
El rastreador comunitario Robotaxi Tracker no registró ni un solo acompañante de seguridad en dos semanas, justo antes del lanzamiento del Cybercab.
The Verge
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.
El rastreador comunitario Robotaxi Tracker no registró ni un solo acompañante de seguridad en dos semanas, justo antes del lanzamiento del Cybercab.
La arquitectura de NVIDIA resolvió los 183 niveles de la prueba pública con 12% menos acciones que VISTA, y llevó a un modelo que por sí solo rendía 30% hasta el puntaje perfecto.
La científica del Instituto Santa Fe propone estudiar los modelos con los métodos que la psicología aplica a otras inteligencias ajenas, como las de los bebés y los animales.
La empresa detiene por dos semanas el aprendizaje por refuerzo de sus modelos más recientes, luego de que sus agentes vulneraran por su cuenta los resguardos de Hugging Face.
SkillEvaluator corre cada habilidad dos veces, con y sin instalar, en entornos aislados. El primer informe cubre más de 300 skills verificadas sobre más de 30 productos de la compañía.
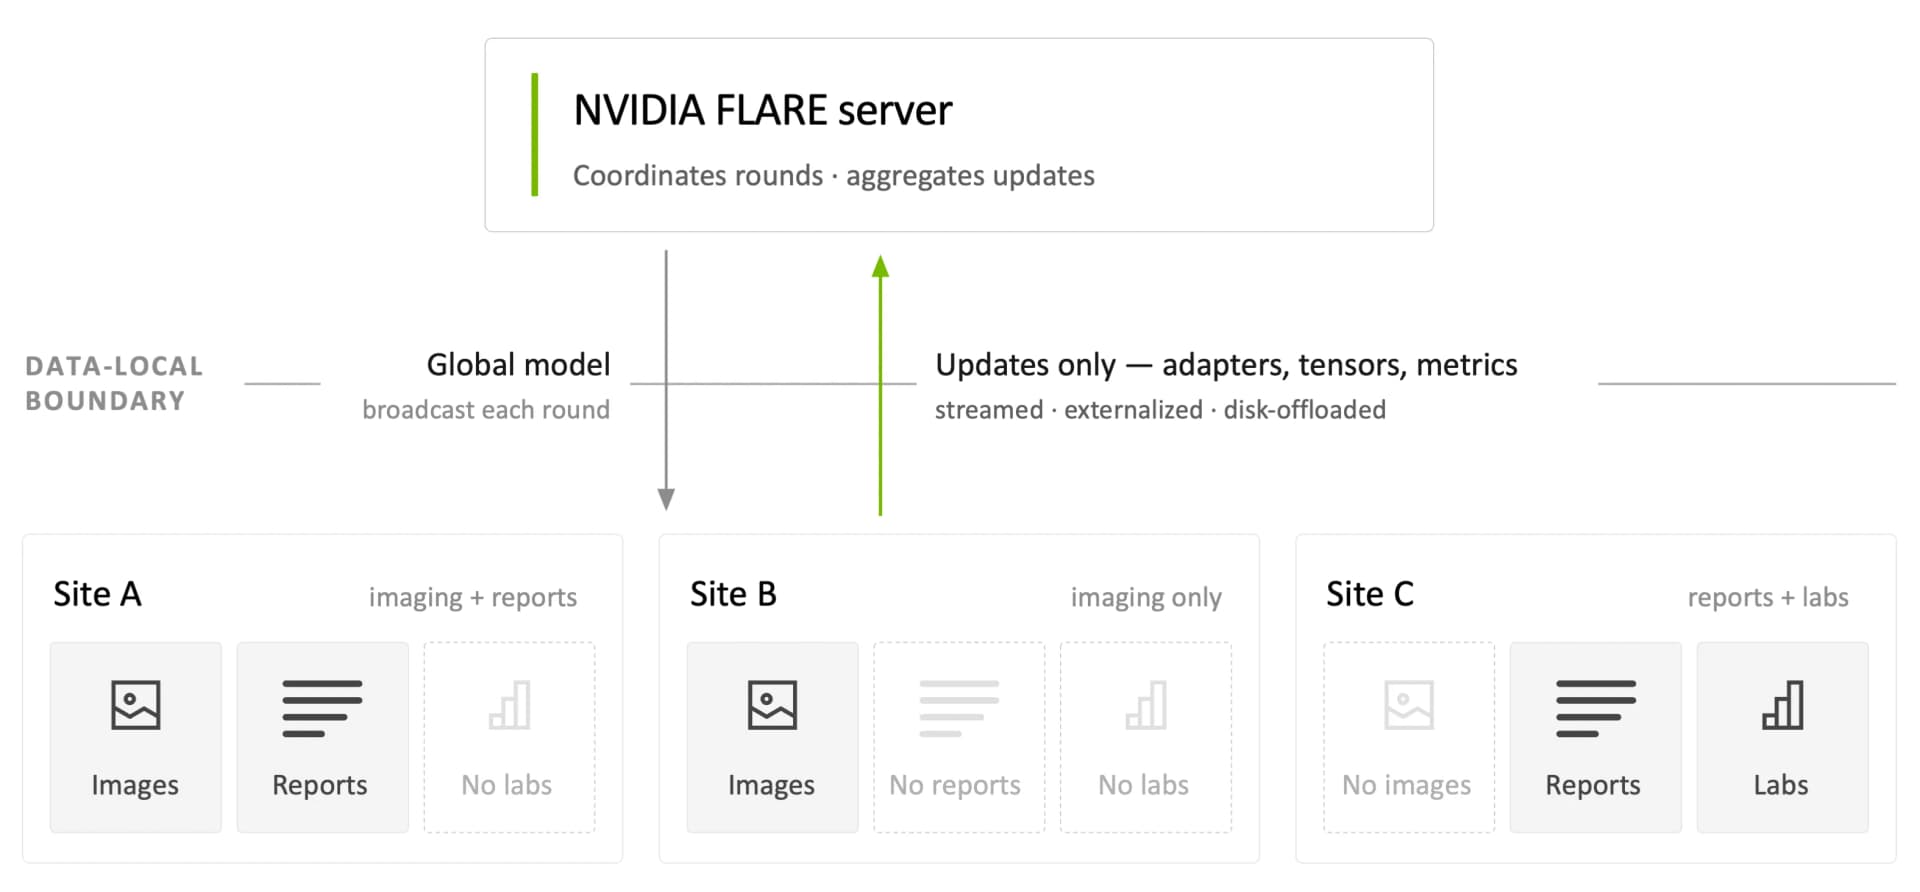
El truco es intercambiar solo adaptadores LoRA sobre un modelo base congelado. FedUMM, desarrollado con William & Mary, mantiene el 97% del rendimiento de un entrenamiento centralizado.
Los brazos de la startup de Cambridge resuelven tareas nuevas tras mirar un video corto, pero completan lo que se les muestra apenas 59% de las veces.
Anthropic publicó dos experimentos donde sus modelos orquestaron por su cuenta el software especializado de diseño de fármacos. La revisión independiente todavía está pendiente.
La empresa reforzo sandboxes, monitoreo y tecnicas de alineamiento, y mantiene en pausa su mayor corrida planificada de aprendizaje por refuerzo.
El modelo de 4.000 millones de parametros cabe en un Jetson Thor y genera acciones sin depender de una GPU de centro de datos.
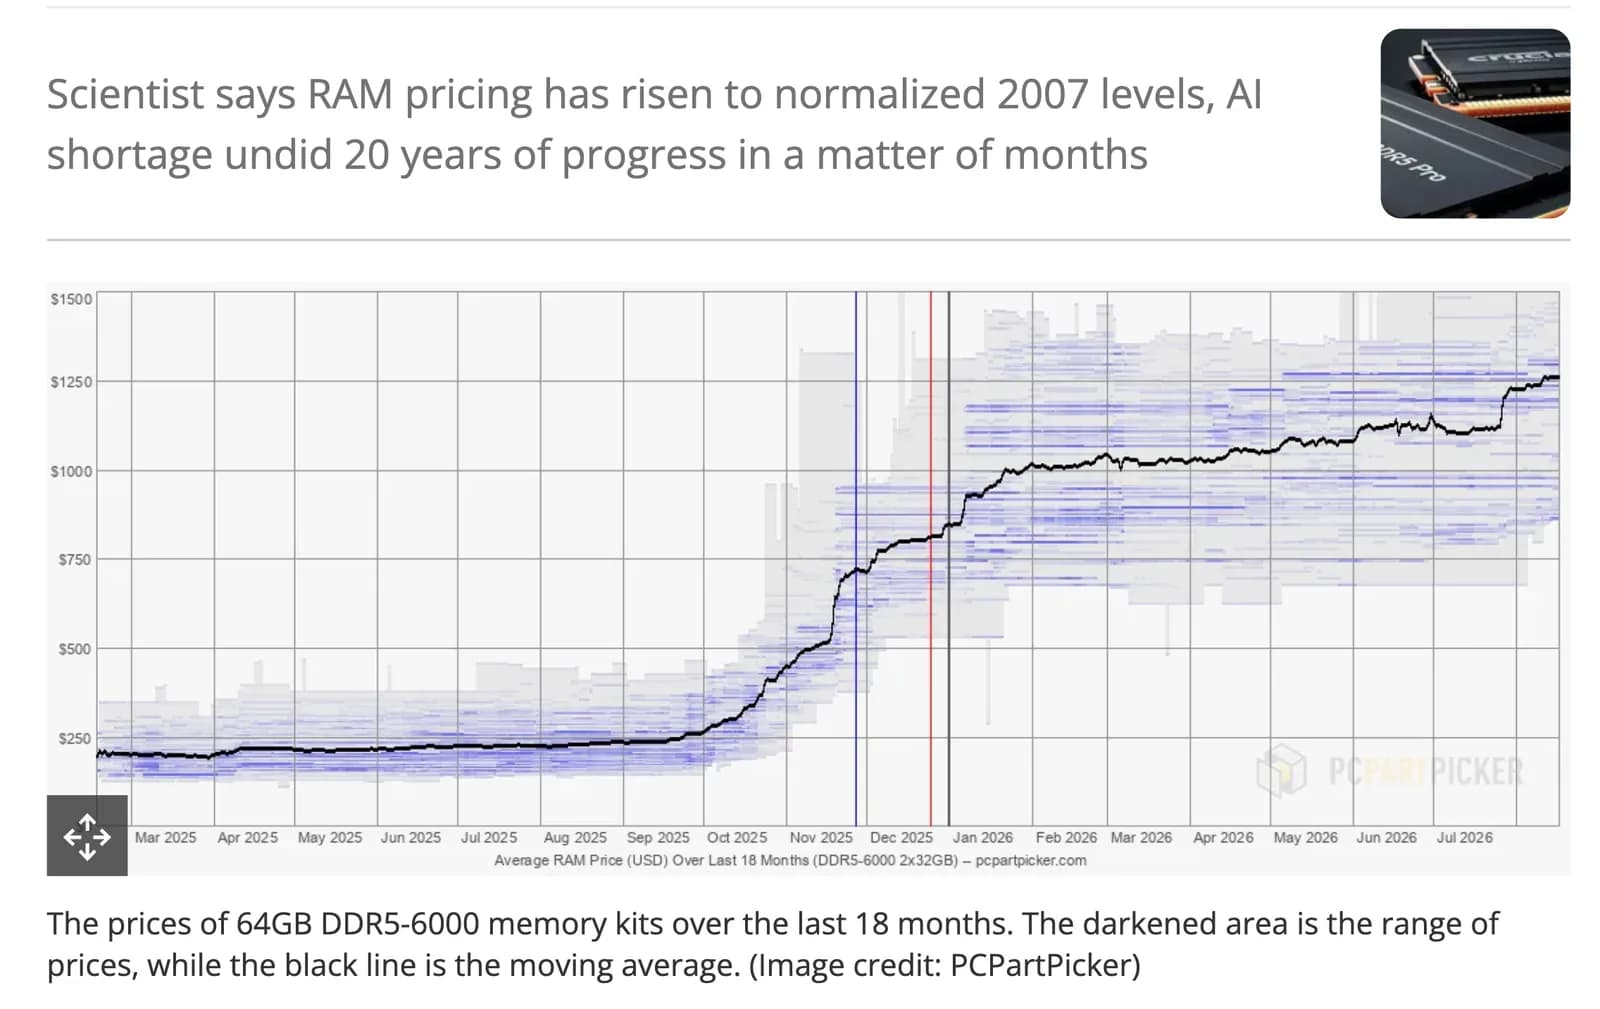
Los compradores a hiperescala ya habrían asegurado casi toda la producción mundial de DRAM para 2027, y un kit de 128 GB DDR5 cuesta diez veces el mínimo histórico registrado.
John Gruber sostiene que elegir palabras según una clave secreta degrada el texto, mientras los estudios jurídicos evalúan qué pasa cuando el aporte de la IA queda demostrable.
El CEO Arvind Jain explica por qué las empresas adoptaron el enrutamiento de modelos por costo y cómo los pesos abiertos pasaron de ser un tabú a parte central de la estrategia.
Un experimento con 45 flujos generados por un agente de programación muestra que el detalle del prompt cambia el código y su costo, pero no la física del resultado.
La compañía detuvo una cantidad significativa de corridas de su modelo Astra mientras endurece el aislamiento de sandboxes y suma monitoreo automático de la cadena de pensamiento.
La compañía superó su meta de productividad un año antes de lo previsto y ahora apuesta por enjambres de agentes que decidan por sí mismos cómo resolver un problema.
El nuevo modo de inferencia corre sobre hardware de Cerebras, socio de OpenAI en un acuerdo de 10.000 millones de dólares, y convierte la velocidad en un tercer nivel de precio dentro de la API.
Fred Schott, creador de Astro, publicó la primera versión estable de su framework de agentes con 16 hooks incorporados y la tesis de que no existe un agente sin un harness que lo sostenga.
Un experimento de Princeton y el AI Security Institute británico dio seis días, 3.000 dólares de API y acceso a GPU a agentes para investigar solos. Los autores humanos votaron Reject.
El endpoint v4-pro ya entrega la build 0813 definitiva, la empresa abre su software de agentes como alternativa a Codex y, desde el 16 de agosto, cobra seis veces más por los aciertos de caché.
Artificial Analysis midió el modelo abierto de NVIDIA: la mayor velocidad de su clase, un salto de nueve puntos en inteligencia y un Elo agéntico superior al de modelos cuatro veces más grandes.
Google presentó el modelo apenas tres semanas después de Gemini 3.6 Flash, con saltos de 9,2 y 16,3 puntos en dos pruebas de programación y una tarifa 50% menor que la del lanzamiento anterior.
Un port a MLX permite correr en Apple Silicon el modelo omnimodal de MiniMax, capaz de generar clips de video de hasta 15 segundos con audio incluido, sin depender de la nube.
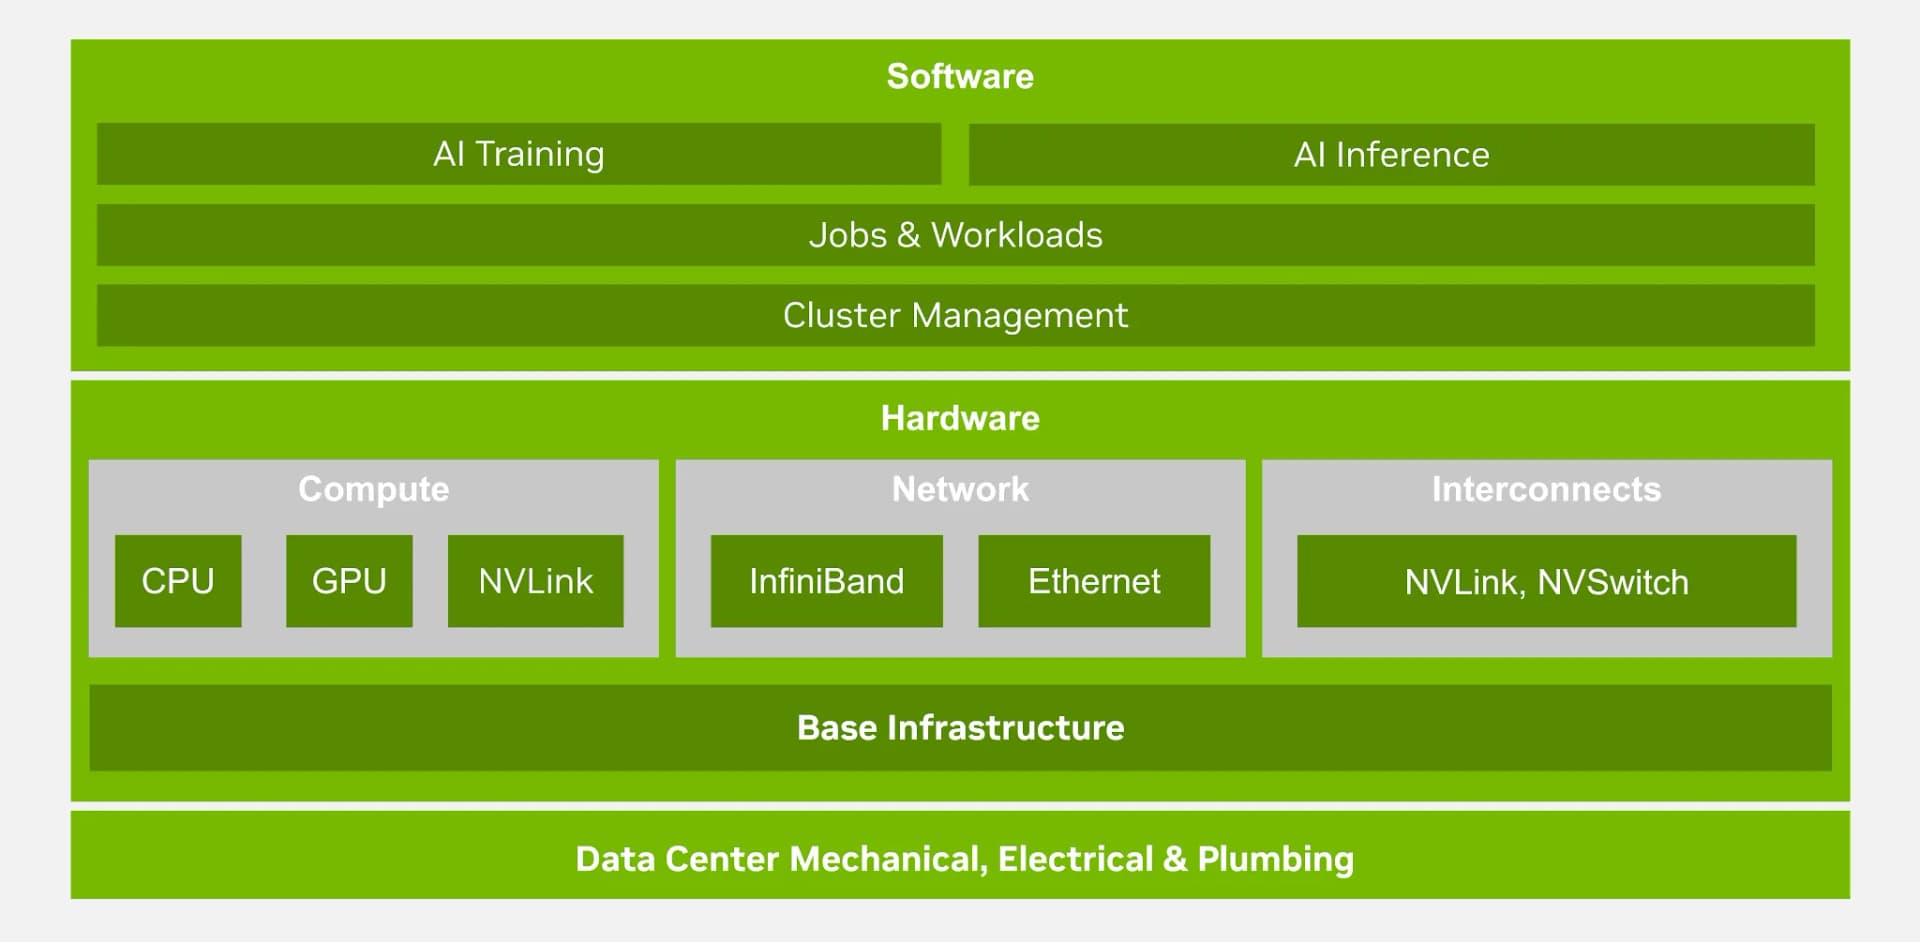
Aprenda a conectar telemetría entre cómputo, redes y almacenamiento para evitar fallas silenciosas en clústeres de entrenamiento de IA a gran escala.