
IA: Qué es la memoria y cómo configurarla para ser más eficiente
Entiende la diferencia entre memoria explícita e historial en modelos LLM. Aprende a limpiar, corregir y optimizar el contexto que tu IA utiliza a diario.
Xataka
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.
Entiende la diferencia entre memoria explícita e historial en modelos LLM. Aprende a limpiar, corregir y optimizar el contexto que tu IA utiliza a diario.
El toolkit Model Card Generator de NVIDIA construye documentación completa en formato Model Card++ a partir del código fuente, con 91% de completitud y 76% de precisión en menos de un minuto.
Hugging Face abre una serie de tres partes sobre profiling con PyTorch, empezando por matmul más bias en bf16 sobre una NVIDIA A100 80GB.
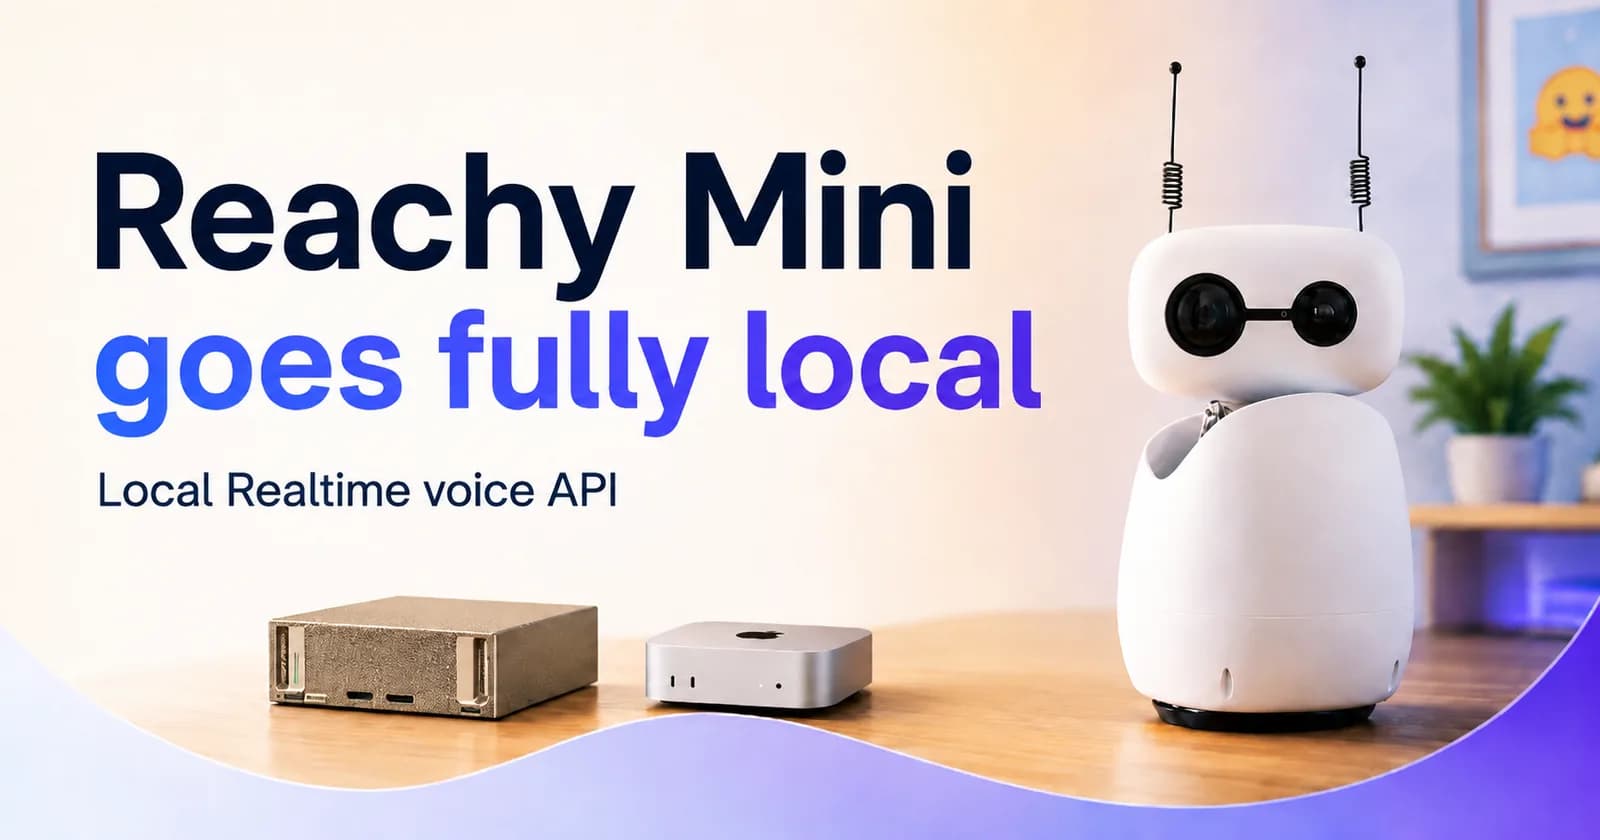
Hugging Face publicó el stack speech-to-speech cascade con Silero, Parakeet-TDT, Qwen3-TTS y llama.cpp para correr el robot sin enviar audio a la nube.
El benchmark STAC-AI LANG6 con Llama 3.1 8B y 70B muestra hasta 2,8x más rendimiento por GPU frente a Hopper en cargas de inferencia con documentos EDGAR.
El ingeniero Sholto Douglas describió la solución como una "prueba simple y elegante" y la atribuyó a un sistema de instancias Claude Code coordinadas.
NVIDIA lanza CUDA Tile sobre Hopper, libera CUDA Python 1.0 con green contexts y process checkpointing, y debuta CompileIQ con hasta 15% de speedup en GEMM y attention.
La nueva GPU Server Edition acelera Parabricks, Minimap2, fq2bam y DeepVariant; con cuEquivariance y Openfold3 también gana 2,3x sobre la L4 al inferir estructuras de proteínas.
Wired reconstruye cómo Anthropic con Claude Code Opus 4.5 y Peter Steinberger con OpenClaw (366.000 stars en GitHub) detonaron el cambio más subestimado del software, según Thomas Reardon.
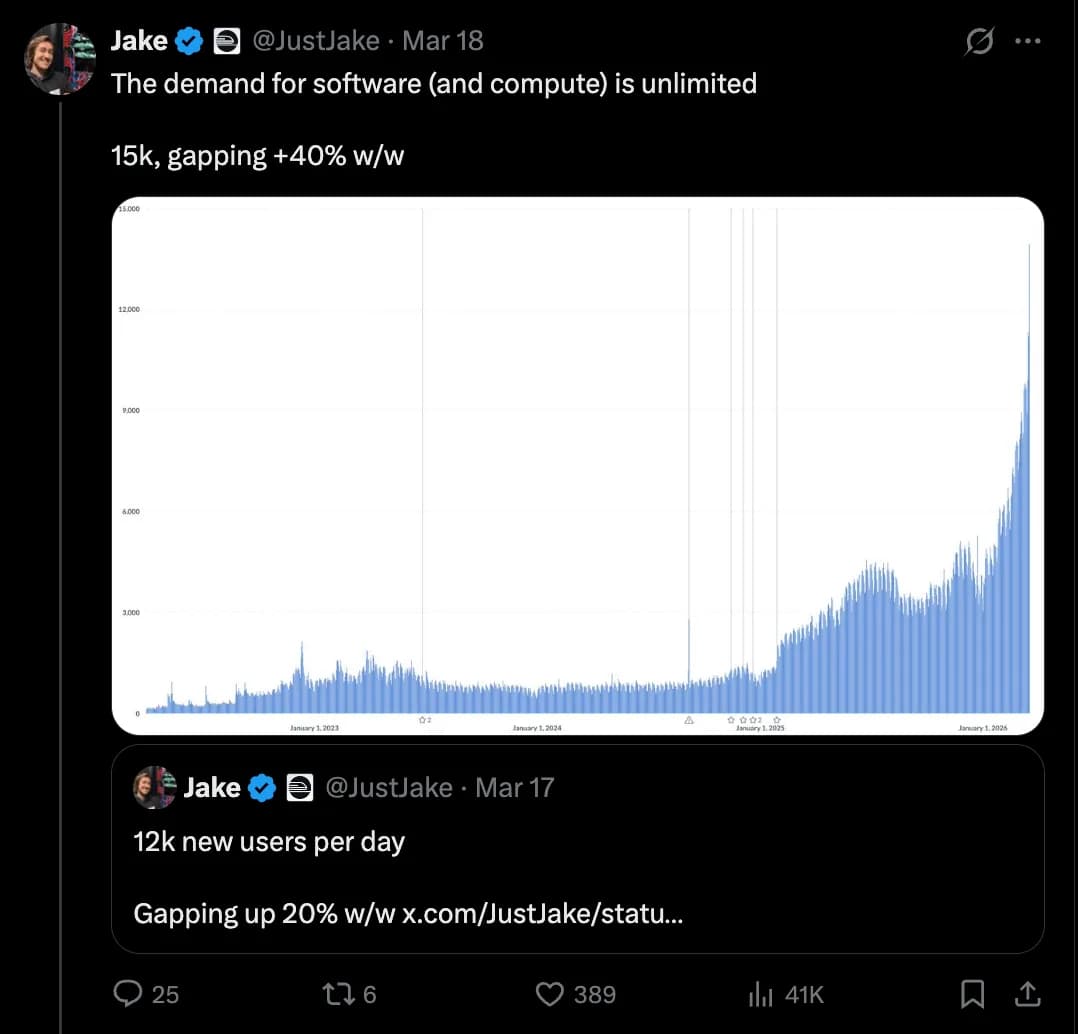
Con 35 personas atendiendo a 3 millones de usuarios y data centers propios con payback de 3 meses, Jake Cooper construye una alternativa a los hyperscalers para la era de los agentes.
La arquitectura NVIDIA Cloud Partner habilita fabricas de IA soberanas donde la unidad de medida y facturacion pasa de horas-GPU a tokens procesados.
El add-in beta crea presentaciones desde notas, documentos o imágenes y edita slides existentes, pero la propia OpenAI recomienda guardar copias antes de usarlo.
El recorte sobre DeepSeek V4 Pro lleva el output a USD 0,87 por millon de tokens y consolida la guerra de precios que la oferta china abrio contra OpenAI y Anthropic.
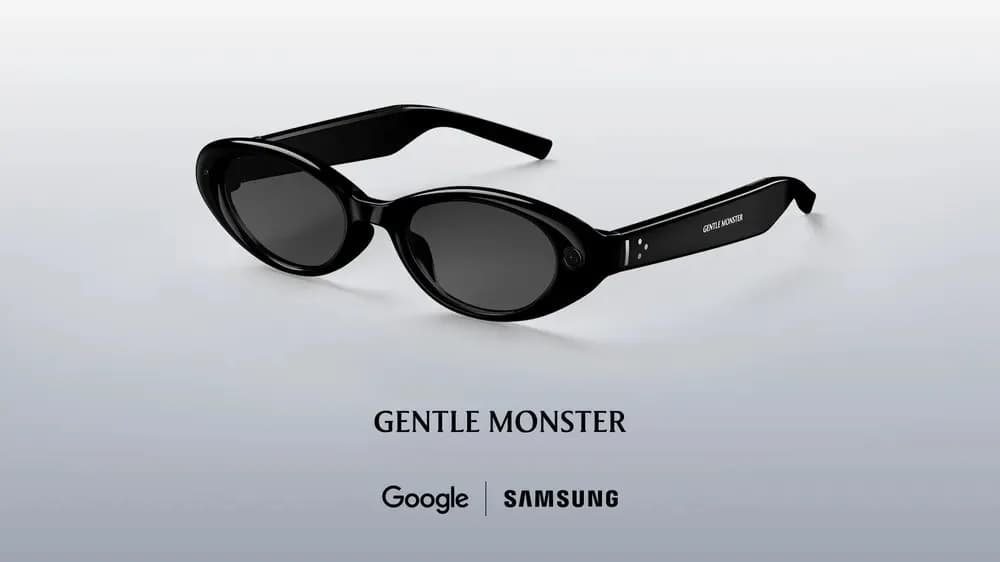
El prototipo con pantalla en la lente derecha proyecta direcciones de Google Maps, traduce conversaciones en tiempo real y se activa con presión larga en la patilla derecha.
El primer modelo de la familia Gemini Omni sucede a Veo en la plataforma Flow y ya hace video-a-video con consistencia notable, aunque sigue cobrando 15 a 40 créditos por clip.
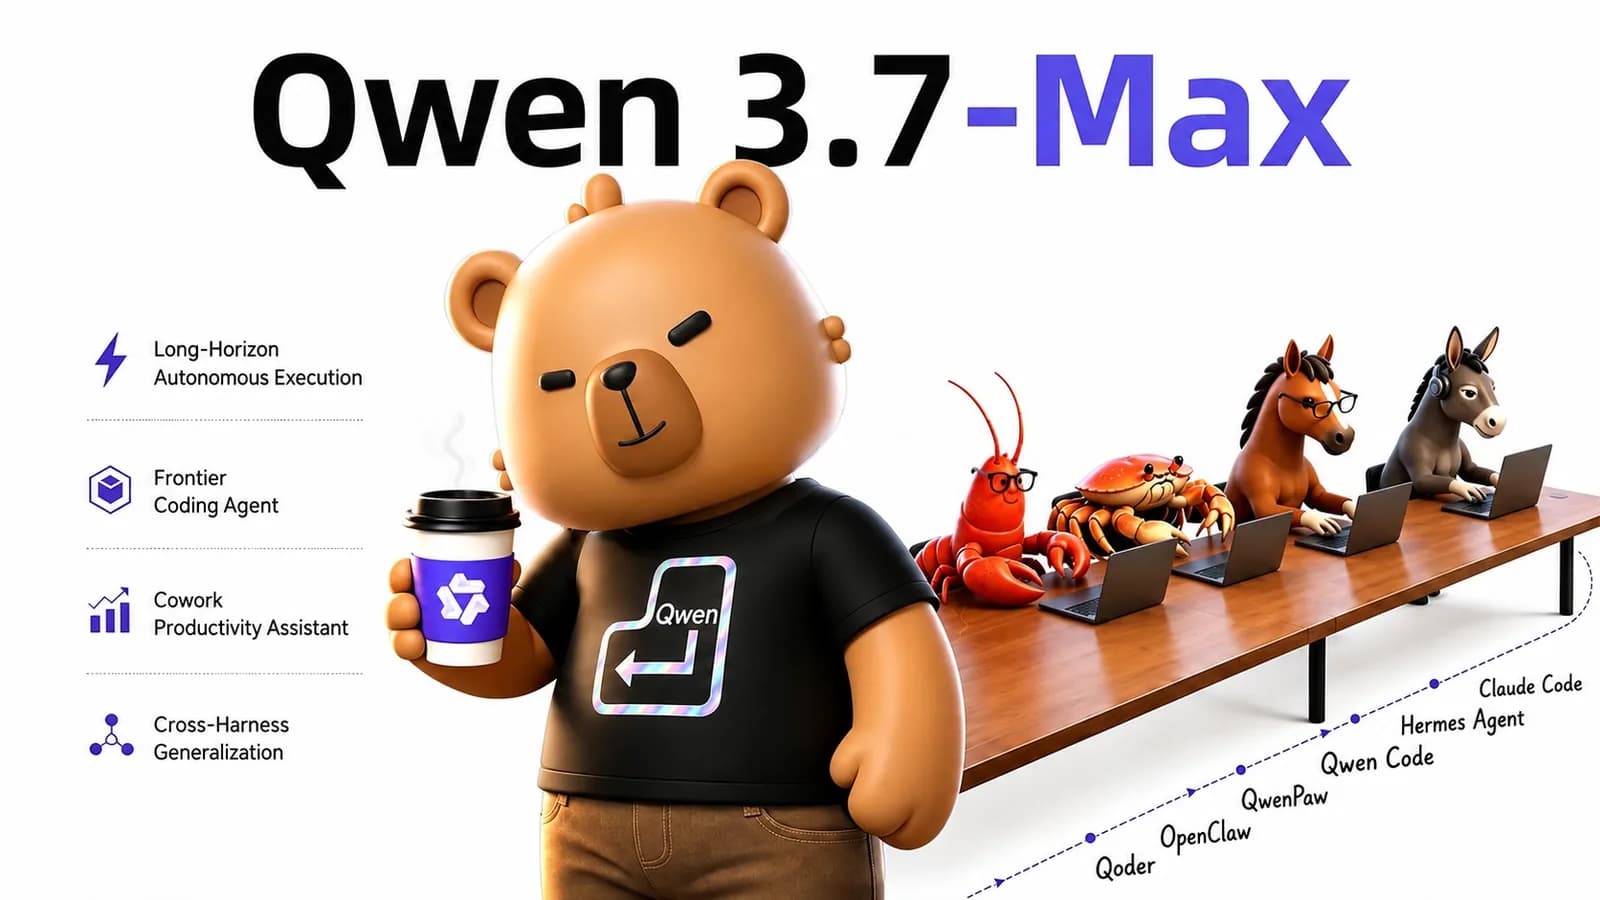
El nuevo modelo del equipo Qwen, exclusivo de la API de Alibaba Cloud, completó 432 tests de kernel y 1.158 tool calls sin intervención humana, logrando un speedup promedio de 10x.
El CEO Ivan Burazin explica cómo la empresa pasó de hospedar entornos de desarrollo humano a operar 850.000 sandboxes diarios en bare metal para agentes autónomos.
NVIDIA detalla cinco prácticas para medir agentes en producción: trayectorias completas, precisión de tool calls y eficiencia, más allá del benchmark estático del modelo base.
La app agéntica de codificación suma escritorio rediseñado, agentes en background y voz nativa apoyados en Gemini 3.5 Flash; el plan Ultra superior baja de USD 250 a USD 200.
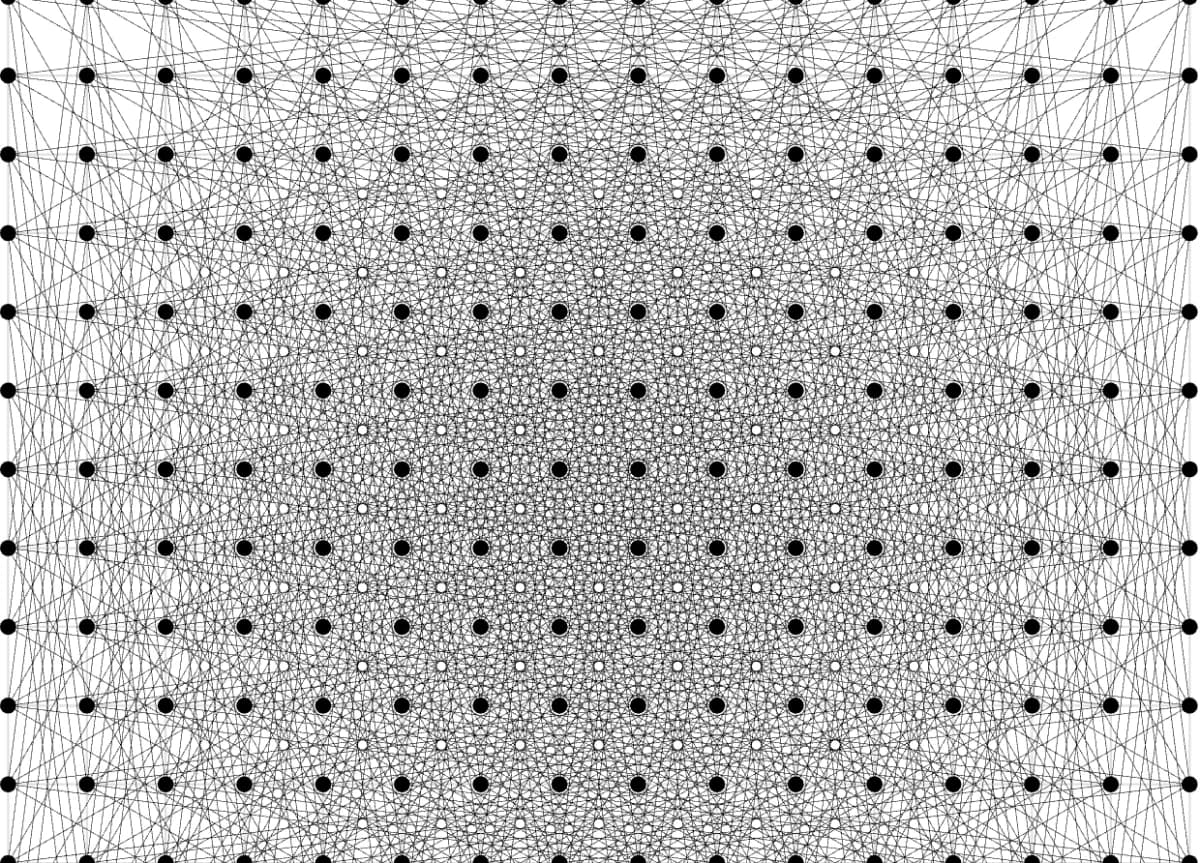
El modelo de razonamiento entregó una construcción geométrica nueva que supera a las soluciones tipo grilla cuadrada, y matemáticos prominentes respaldan el resultado antes del anuncio.
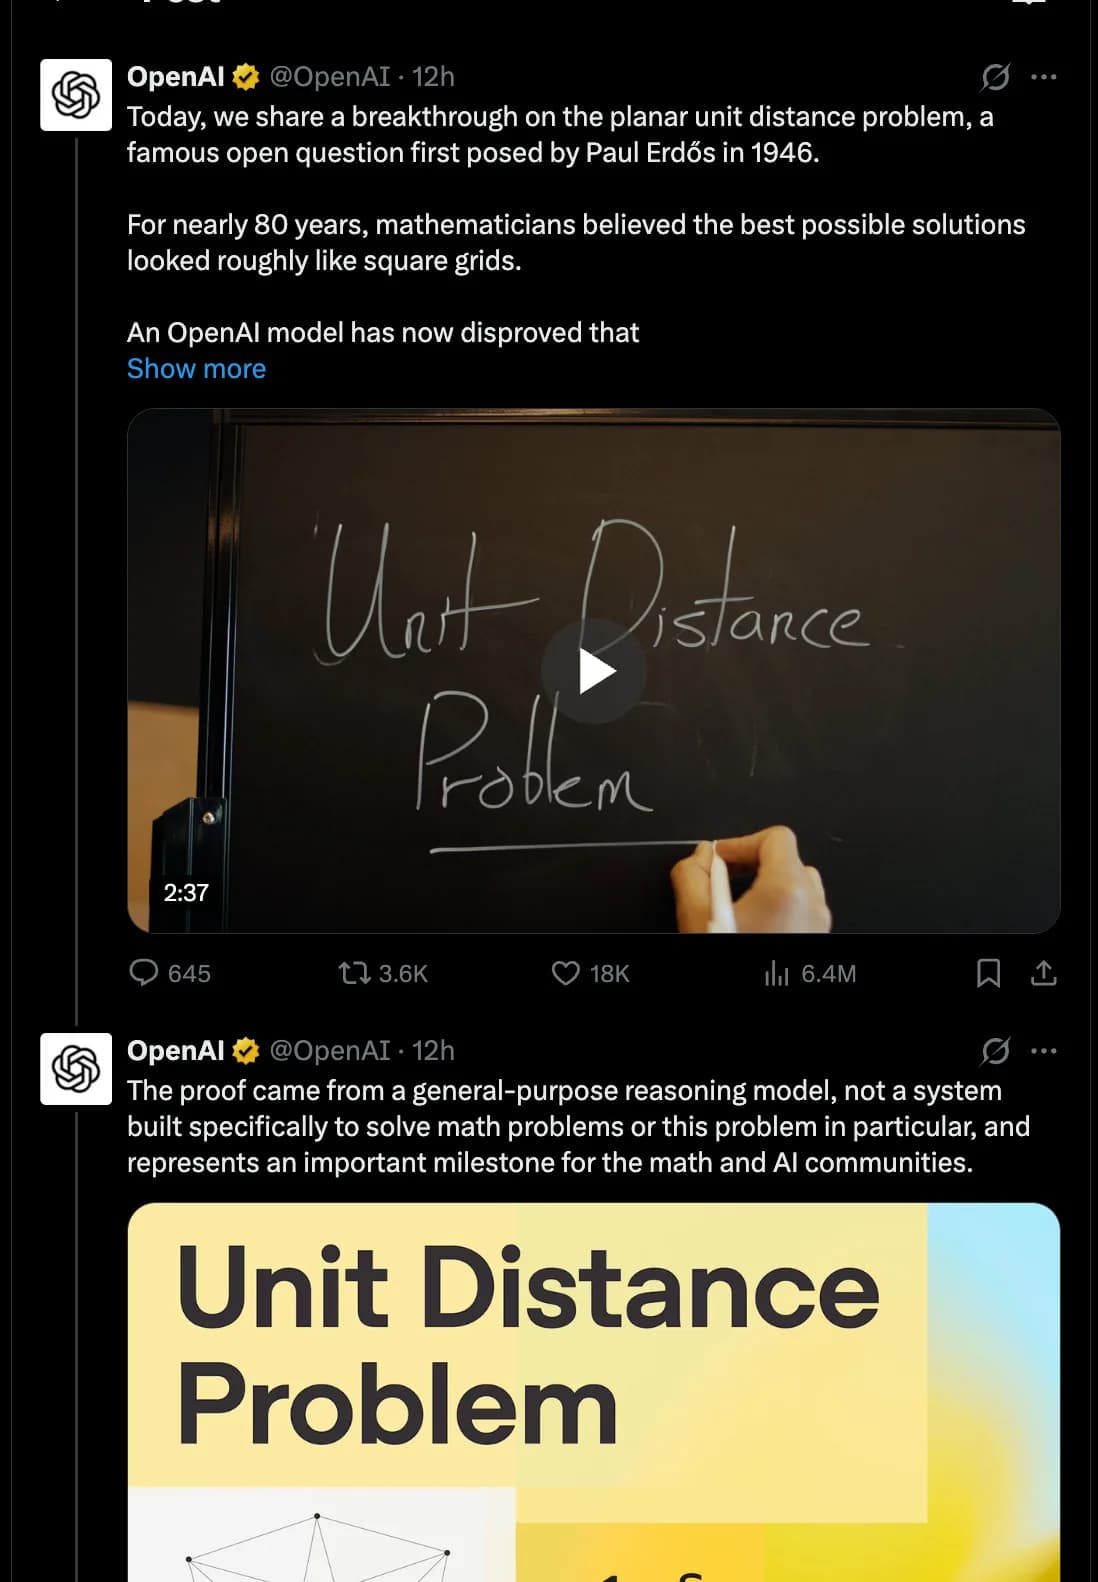
Un modelo de propósito general, sin asistente formal tipo Lean, descartó una conjetura de geometría discreta abierta desde 1946 con un cómputo estimado en 32 horas.
El modelo más rápido en su clase de inteligencia consume tantos tokens en tareas de agentes que supera incluso al Gemini 3.1 Pro en costo total.
La china Deepseek monta un equipo "Harness" en Beijing para construir su propio agente de programación, en competencia directa con los productos de Anthropic, OpenAI y Cursor.
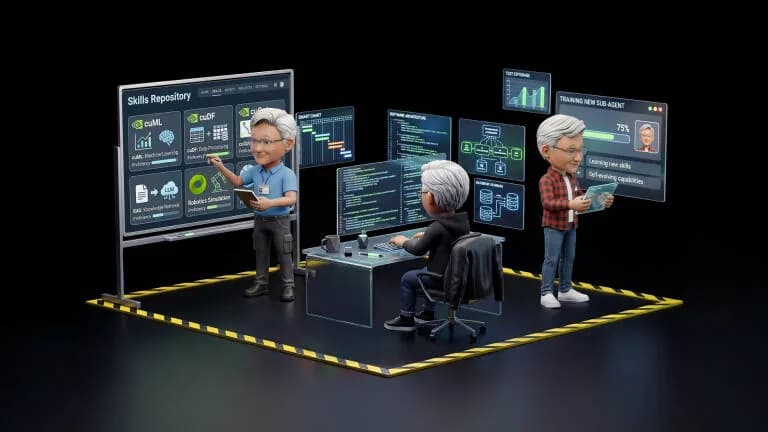
El blueprint expone un servidor de investigación profunda como skill enchufable para Claude Code, Codex y OpenCode, manteniendo los datos sensibles dentro de la red corporativa.