Google y Meta lanzan TorchTPU para correr PyTorch nativo en las TPU
El nuevo backend de código abierto ejecuta modelos de PyTorch en las TPU de Google cambiando cuda por tpu, y ya se validó con los 5.000 modelos más descargados de Hugging Face.
10 notas publicadas

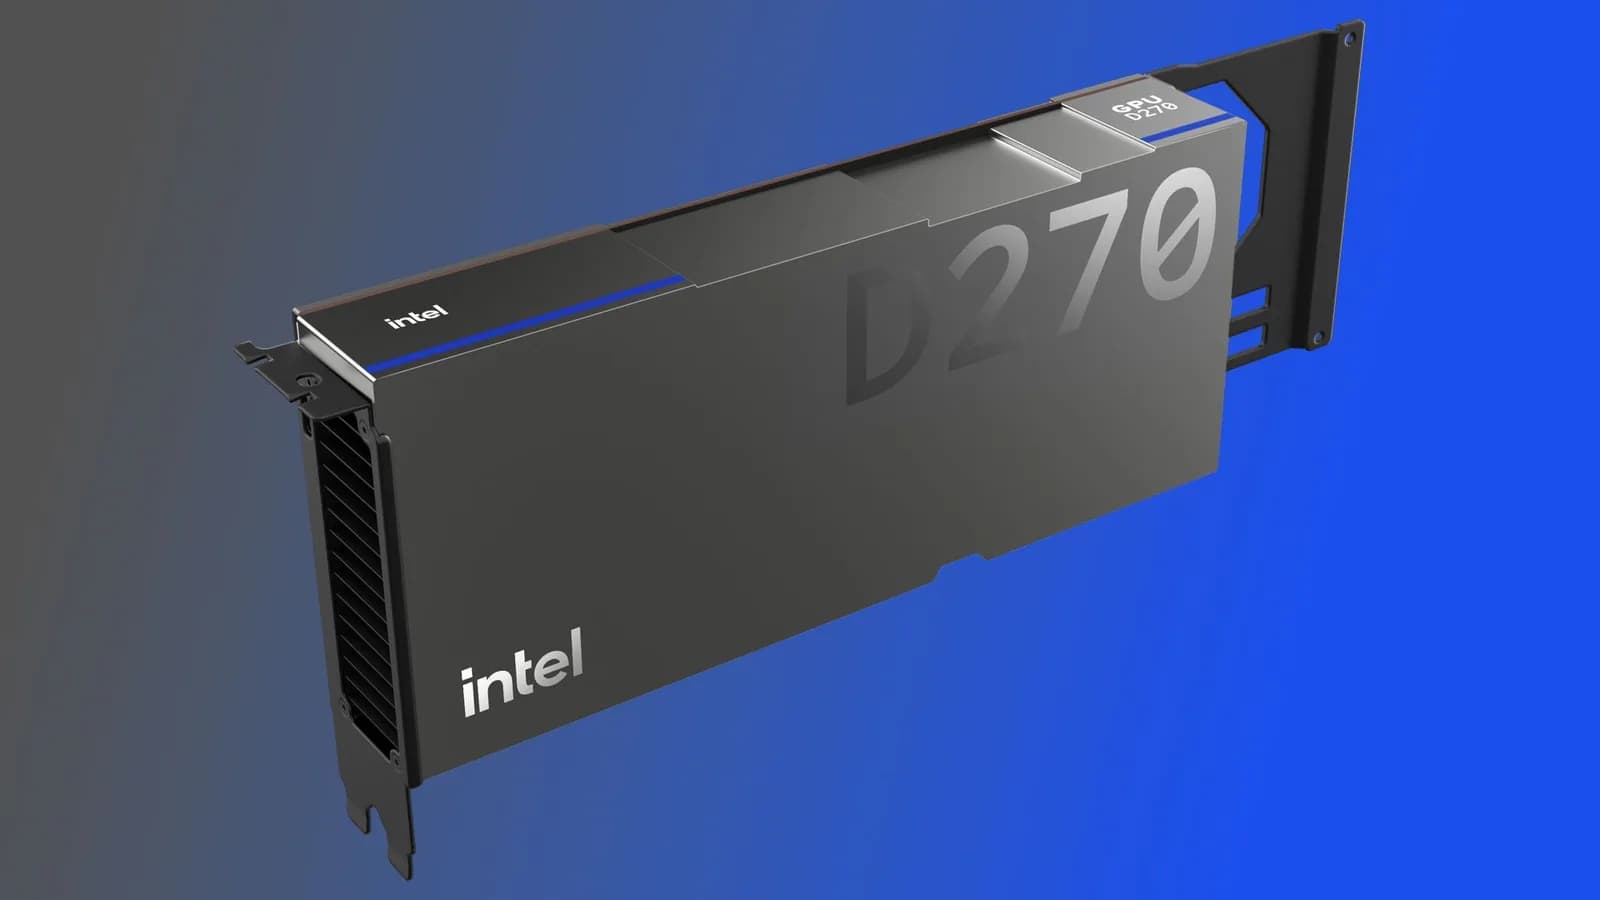
El acelerador de inferencia promete 1,3 PFLOPS en FP8, 1,5 TB/s de ancho de banda y refrigeración por aire en tarjetas PCIe de 350 W.

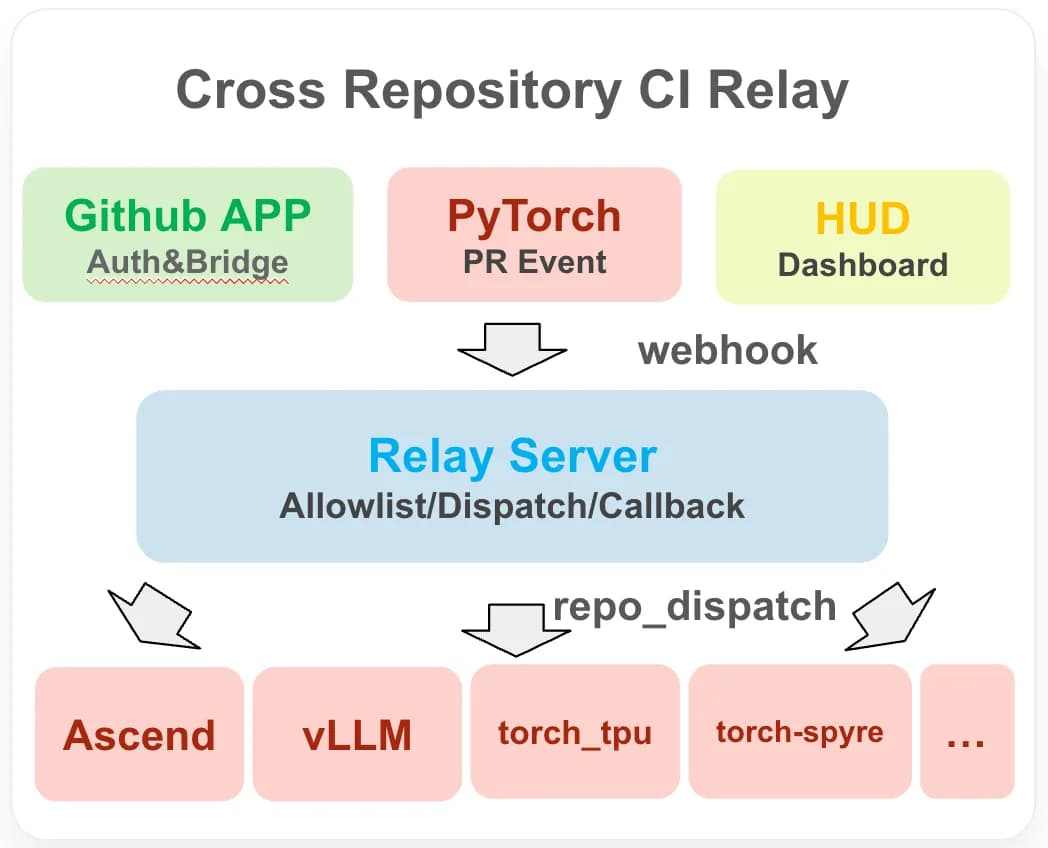
El grupo de integración de aceleradores de PyTorch resumió su primer semestre de 2026, con un relé de CI entre repositorios, pruebas independientes del hardware y perfilado para backends externos.

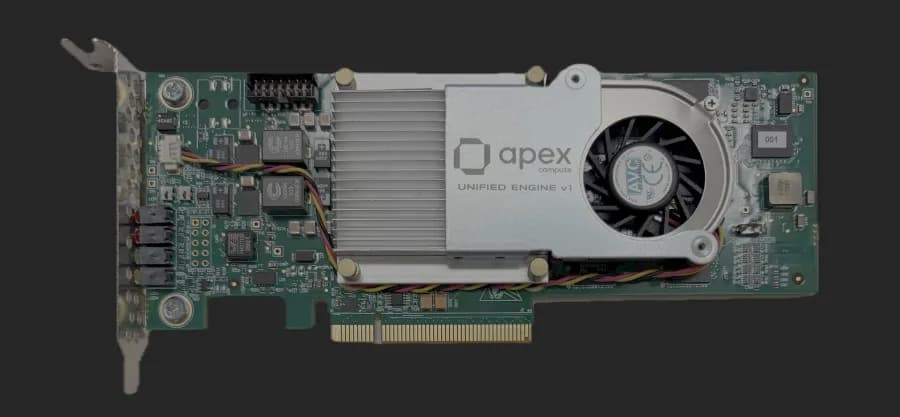
La startup californiana pidió a Khronos sus identificadores de proveedor y desarrolla el driver a la vista en GitHub, lo que abre la puerta a llama.cpp.

La empresa dice que no alcanza a cubrir la demanda interna, y su respuesta a Nvidia pasa por clusters Atlas de hasta 15.488 aceleradores en vez de competir chip contra chip.

La compañía también duplicó el rendimiento en FP4 del Ascend 960PR frente a lo que había anunciado el año pasado, y detalló por primera vez los chips que llegan en 2028 y 2029.

El acelerador declara 4 petaFLOPS en FP4 y 288 GB de memoria propia HiZQ, el doble de rendimiento y de capacidad que la serie 950 lanzada este año.

La startup de inferencia se suma a Qualcomm, Arm, Marvell, Amazon, Fujitsu y MediaTek en licenciar la interconexión de Nvidia, y renuncia a diseñar su propia red de escalado vertical.

El gerente general de OpenAI Korea confirmó trabajo conjunto en chips de próxima generación, lo que apunta a un doble abastecimiento con TSMC y a volúmenes enormes.

La taiwanesa adoptará NVLink Fusion para sus aceleradores de IA a medida, sus sistemas locales y sus plataformas automotrices, mientras Nvidia se asegura un lugar en el mercado de chips que no diseña.
Otros temas que aparecen junto a #aceleradores ia en nuestra cobertura editorial.