Saltar al contenido
Etiqueta

#inferencia

43 notas publicadas

Meta ya sirve IA en producción sobre las TPU de Google
Electrónica

Meta ya sirve IA en producción sobre las TPU de Google

Lo hace con una versión de SGLang escrita para PyTorch nativo, y un vLLM equivalente marcó 700 tokens por segundo contra 452 de 16 GB200.

Tom's Hardware
AMD e Intel unen sus optimizaciones de PyTorch para CPU en oneDNN
Electrónica

AMD e Intel unen sus optimizaciones de PyTorch para CPU en oneDNN

La biblioteca ZenDNN de AMD pasa a formar parte de oneDNN, el backend abierto que Intel impulsa desde la UXL Foundation.

Tom's Hardware
DeepSeek libera DeepInfer, el motor que sirve a su modelo V4.1 Flash
IA

DeepSeek libera DeepInfer, el motor que sirve a su modelo V4.1 Flash

El código sale bajo licencia Apache 2.0 y se apoya en vLLM, aunque la gestión de caché y el balanceo de carga de producción quedaron fuera.

The Decoder
Mercury 3 de Inception supera los 1.000 tokens por segundo
Electrónica

Mercury 3 de Inception supera los 1.000 tokens por segundo

El modelo de lenguaje por difusión es 40 veces más grande que Mercury 1, amplía el contexto a un millón de tokens y se compara con GPT-6 Luna y Claude Haiku 5.5.

Interesting Engineering
Microsoft anuncia Maia 300 y racks de IA a escala de gigawatts
Electrónica

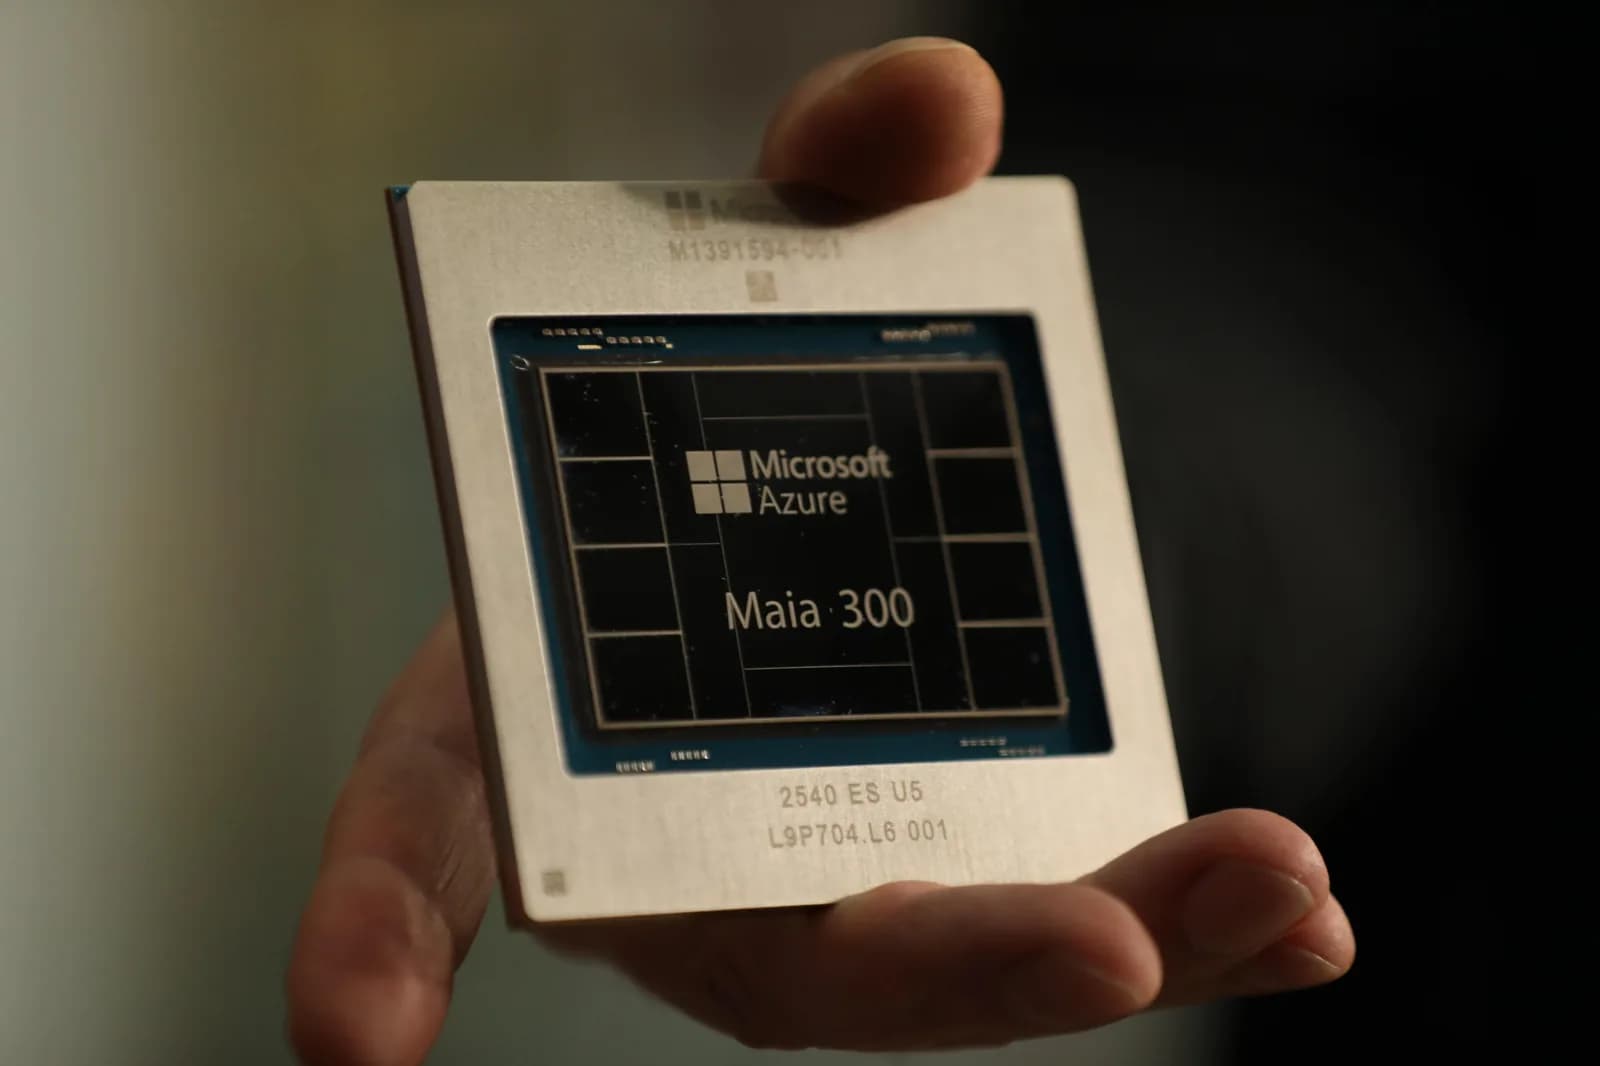
Microsoft anuncia Maia 300 y racks de IA a escala de gigawatts

El chip propio de Azure llega en 2027 en racks de hasta 96 aceleradores, con ocho pilas de HBM4 y 18 TB/s de ancho de banda por chip.

The Register
Apple arma una nube de GPU con los Mac que sus empleados no usan
Electrónica

Apple arma una nube de GPU con los Mac que sus empleados no usan

El sistema Minions reparte tareas de inferencia entre Mac con Apple Silicon y bajó esperas de más de 10 horas a minutos, según un paper de sus investigadores.

Tom's Hardware
Intel bautiza Crescent Island como GPU D-Series y da su cifra en FP8
Electrónica

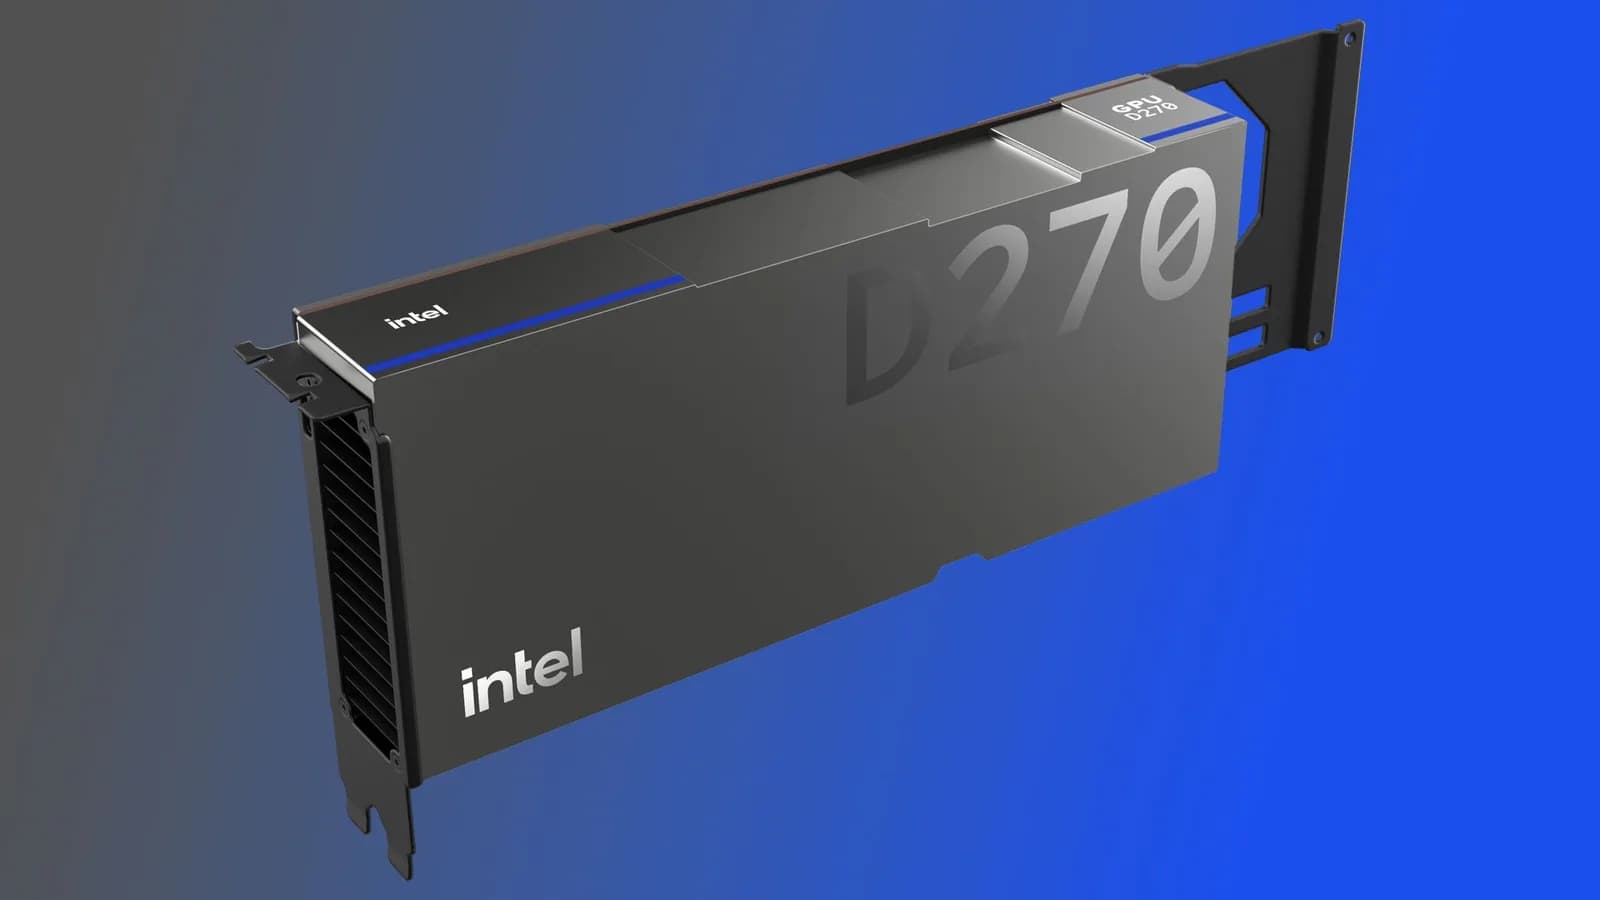
Intel bautiza Crescent Island como GPU D-Series y da su cifra en FP8

El acelerador de inferencia promete 1,3 PFLOPS en FP8, 1,5 TB/s de ancho de banda y refrigeración por aire en tarjetas PCIe de 350 W.

Tom's Hardware
Maia 300, el chip de IA con que Microsoft quiere depender menos de Nvidi
IA

Maia 300, el chip de IA con que Microsoft quiere depender menos de Nvidi

La tercera generación del acelerador propio de Microsoft se fabrica en el nodo N2P de TSMC y entrará a producción en 2027.

The Verge
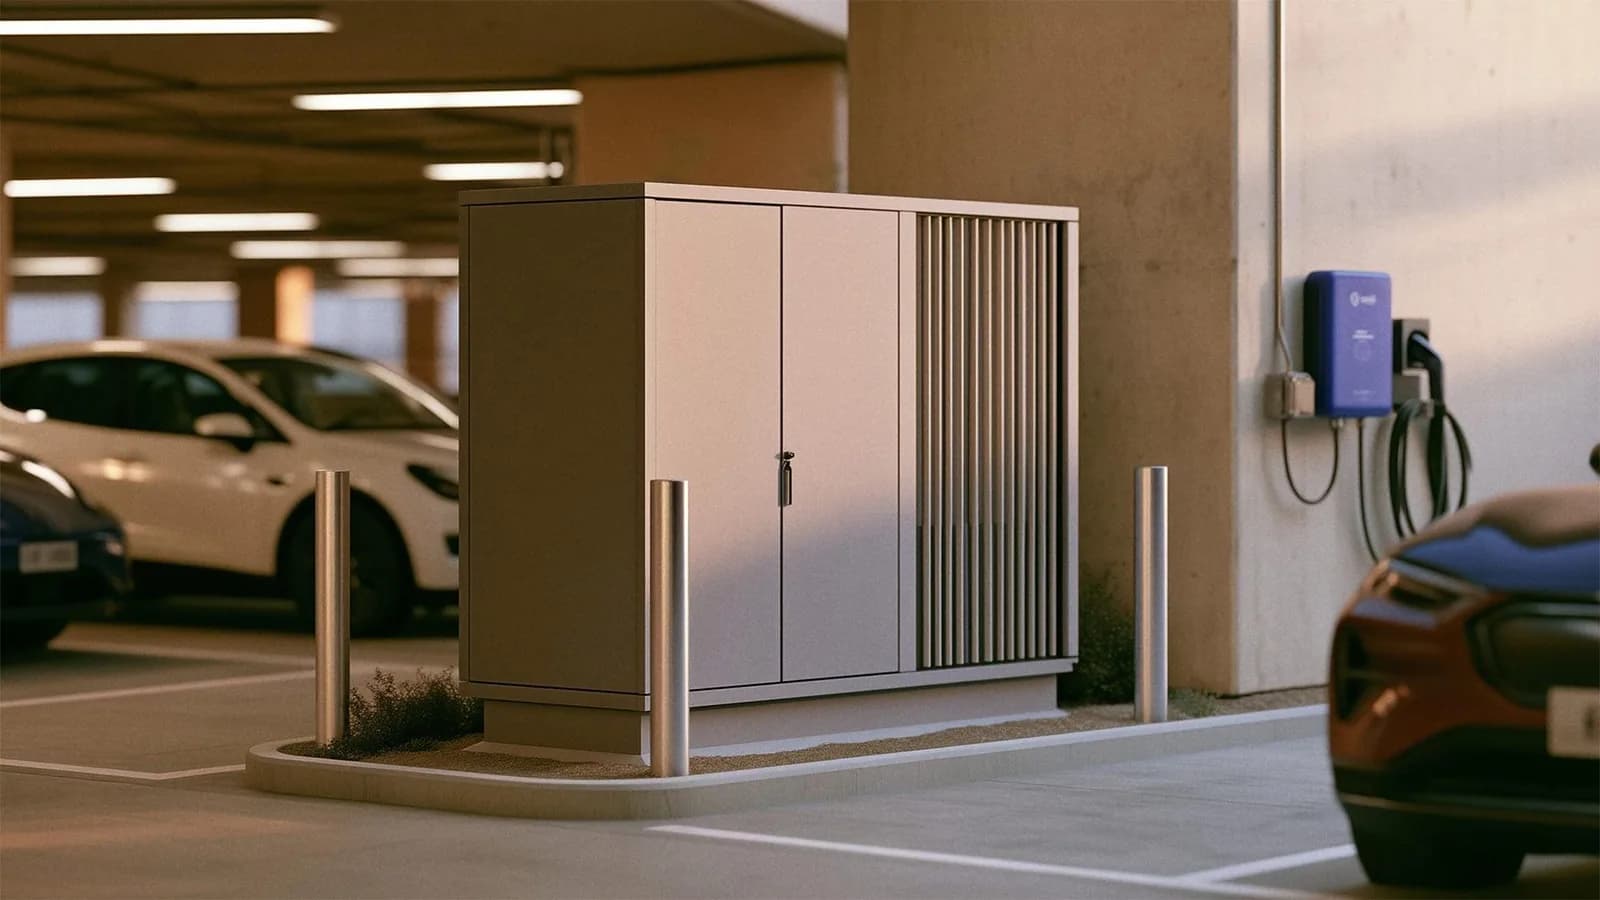
Xeal quiere instalar 100.000 GPU de Nvidia en sus cargadores de autos
Electrónica

Xeal quiere instalar 100.000 GPU de Nvidia en sus cargadores de autos

La empresa de carga de vehículos eléctricos diseñó gabinetes con hasta 48 GPU para aprovechar la potencia eléctrica que sus 1.600 estaciones no usan.

Tom's Hardware
Helion entra al backend lineal de vLLM y supera a CUTLASS en Hopper
IA

Helion entra al backend lineal de vLLM y supera a CUTLASS en Hopper

Un solo kernel GEMM escrito en Helion cubre las variantes estándar, Split-K y Swap-AB, y el autoajuste elige la mejor para cada forma de entrada.

PyTorch Blog
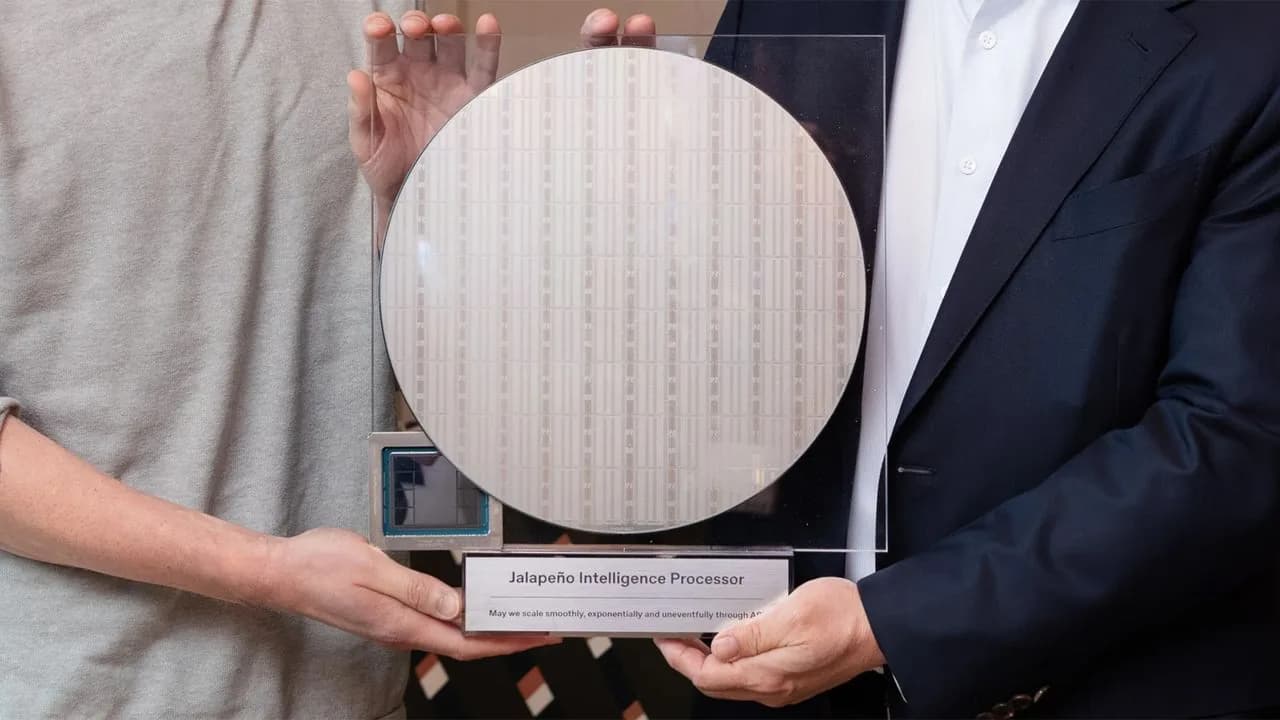
OpenAI dejará Jalapeño para uso interno, pero no descarta abrirlo a otro
Electrónica

OpenAI dejará Jalapeño para uso interno, pero no descarta abrirlo a otro

Richard Ho, jefe de hardware de OpenAI, dijo a Tom's Hardware que el chip es de propósito general y que la demanda interna de cómputo lo ocupará por mucho tiempo.

Tom's Hardware
NVIDIA cifra la inferencia y conserva el 96% del rendimiento
IA

NVIDIA cifra la inferencia y conserva el 96% del rendimiento

La medición corrió sobre DeepSeek-R1 en ocho GPU B200, con el cifrado encendido y apagado, y dejó el sobrecosto de latencia por token bajo el 5%.

NVIDIA Developer
vLLM agrega capas portables a 3,4% del rendimiento nativo
IA

vLLM agrega capas portables a 3,4% del rendimiento nativo

El motor de inferencia rompió la compatibilidad con torch.compile para correr más rápido en las GPU nuevas, y ahora construye un camino aparte para las viejas.

PyTorch Blog
AIPerf reemplaza a GenAI-Perf para medir inferencia de LLM
IA

AIPerf reemplaza a GenAI-Perf para medir inferencia de LLM

NVIDIA reescribió su cliente de carga desde cero, con procesos de trabajo separados y coordinación por ZMQ, para que el propio medidor deje de ser el cuello de botella.

NVIDIA Developer
Jetson AGX Thor cierra el test agéntico de MLPerf en 24 minutos
IA

Jetson AGX Thor cierra el test agéntico de MLPerf en 24 minutos

TensorRT Edge-LLM corrió Qwen3.6-27B en un solo kit de desarrollo y completó las 1.007 vueltas 6,4 veces más rápido que la referencia de llama.cpp.

NVIDIA Developer
Un modelo MoE de 30B activa solo 3B parámetros por token
IA

Un modelo MoE de 30B activa solo 3B parámetros por token

NVIDIA explica con Nemotron 3.5 Lightning en qué se diferencian los modelos densos y los de mezcla de expertos, y por qué la decisión depende del presupuesto de memoria y de la concurrencia.
NVIDIA Developer
Vera Rubin entrega hasta 30 veces más tokens por megavatio
IA

Vera Rubin entrega hasta 30 veces más tokens por megavatio

La medición de SemiAnalysis AgentX sobre el modelo DeepSeek V4 Pro compara el NVL72 de Vera Rubin contra el GB300 NVL72, y NVIDIA presentó el resultado en el AI Infra Summit.

NVIDIA Blog
DeepSeek V4.1 Flash separa los parámetros de leer y de escribir
IA

DeepSeek V4.1 Flash separa los parámetros de leer y de escribir

El modelo suma 763.000 millones de parámetros, activa 8.000 millones en la entrada y 16.000 millones en la salida, y con eso baja la caché de claves y valores hasta un octavo de la del V4 Flash.

Latent Space
DeepSeek V4.1 Flash crece 2,5 veces y usa menos memoria
Electrónica

DeepSeek V4.1 Flash crece 2,5 veces y usa menos memoria

Los 196.000 millones de parámetros N-gram del modelo se pueden mover a la RAM del sistema, y eso baja de 763 GB a 567 GB la memoria de GPU que pide para arrancar.

The Register
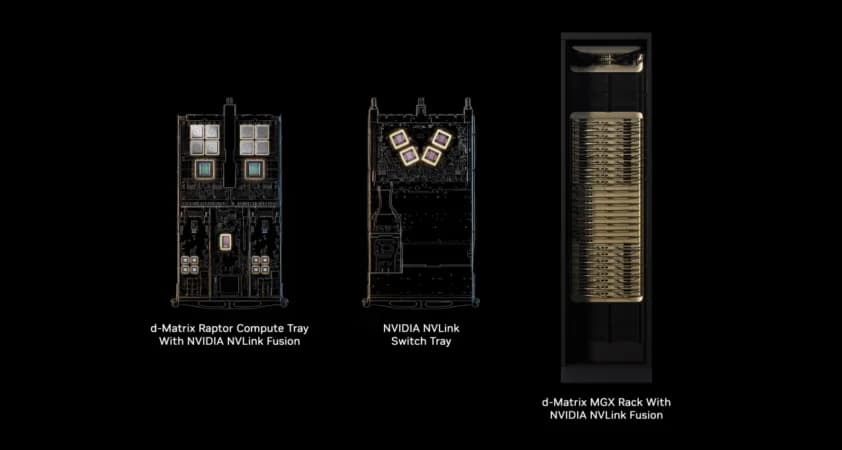
d-Matrix conecta sus XPU Raptor a la red NVLink de NVIDIA
IA

d-Matrix conecta sus XPU Raptor a la red NVLink de NVIDIA

El fabricante de aceleradores de inferencia adopta la arquitectura de rack MGX en vez de construir su propia infraestructura de escala completa.

NVIDIA Blog
d-Matrix adopta NVLink Fusion y armará racks de 144 Raptor
Electrónica

d-Matrix adopta NVLink Fusion y armará racks de 144 Raptor

La startup de inferencia se suma a Qualcomm, Arm, Marvell, Amazon, Fujitsu y MediaTek en licenciar la interconexión de Nvidia, y renuncia a diseñar su propia red de escalado vertical.

The Register
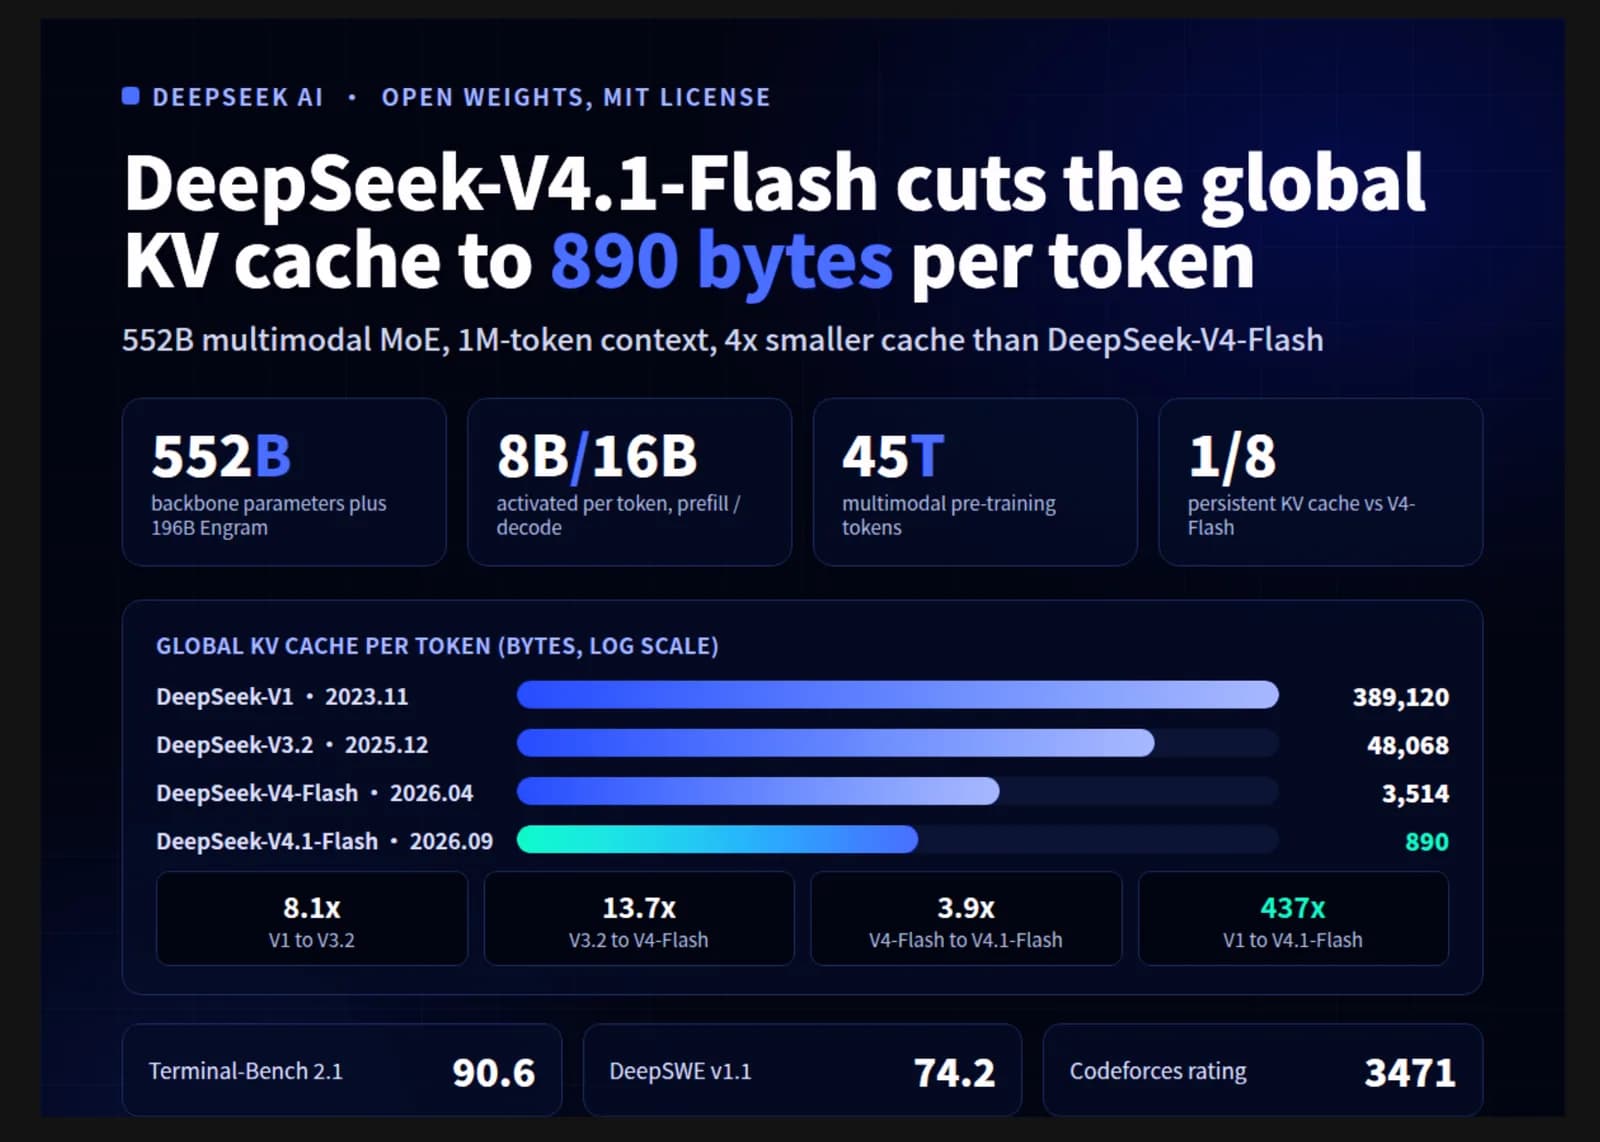
DeepSeek-V4.1-Flash: contexto de 1M y caché KV de 890 bytes
IA

DeepSeek-V4.1-Flash: contexto de 1M y caché KV de 890 bytes

El modelo abre pesos bajo licencia MIT y ataca el cuello de botella real de los agentes largos, que no es la generación sino el costo de guardar millones de tokens en memoria.

MarkTechPost
NVIDIA acelera hasta 5 veces el primer token al aislar el encoder
IA

NVIDIA acelera hasta 5 veces el primer token al aislar el encoder

La desagregación encode-prefill-decode separa el encoder de visión del resto de la inferencia y rinde en cargas con muchas imágenes, pero se vuelve contraproducente con salidas largas.

NVIDIA Developer
AWS ficha a Qualcomm por hasta 60.000 millones a 2036
Electrónica

AWS ficha a Qualcomm por hasta 60.000 millones a 2036

El acuerdo cubre silicio personalizado para inferencia y óptica de 1,6 Tbps, aunque ninguna de las dos compañías entregó detalles concretos sobre los chips involucrados.

The Register
Deepseek quiere 160.000 chips Huawei en Mongolia Interior
IA

Deepseek quiere 160.000 chips Huawei en Mongolia Interior

El centro de datos correría solo inferencia, no entrenamiento, y sería el mayor conjunto conocido de aceleradores Huawei, aunque la entrega completa tomaría más de un año.

The Decoder
Decodificación especulativa: cómo elegir el largo del borrador
IA

Decodificación especulativa: cómo elegir el largo del borrador

NVIDIA publica las reglas prácticas para decidir cuántos tokens adelantar y con qué mecanismo generarlos, sin perder precisión en la inferencia.

NVIDIA Developer
NVIDIA: cómo dimensionar GPU de inferencia sin sobregastar
IA

NVIDIA: cómo dimensionar GPU de inferencia sin sobregastar

La compañía publicó un marco de trabajo que ordena el cálculo alrededor del uso real de la carga, con cuatro escenarios de empresa y sus requisitos de memoria.

NVIDIA Developer
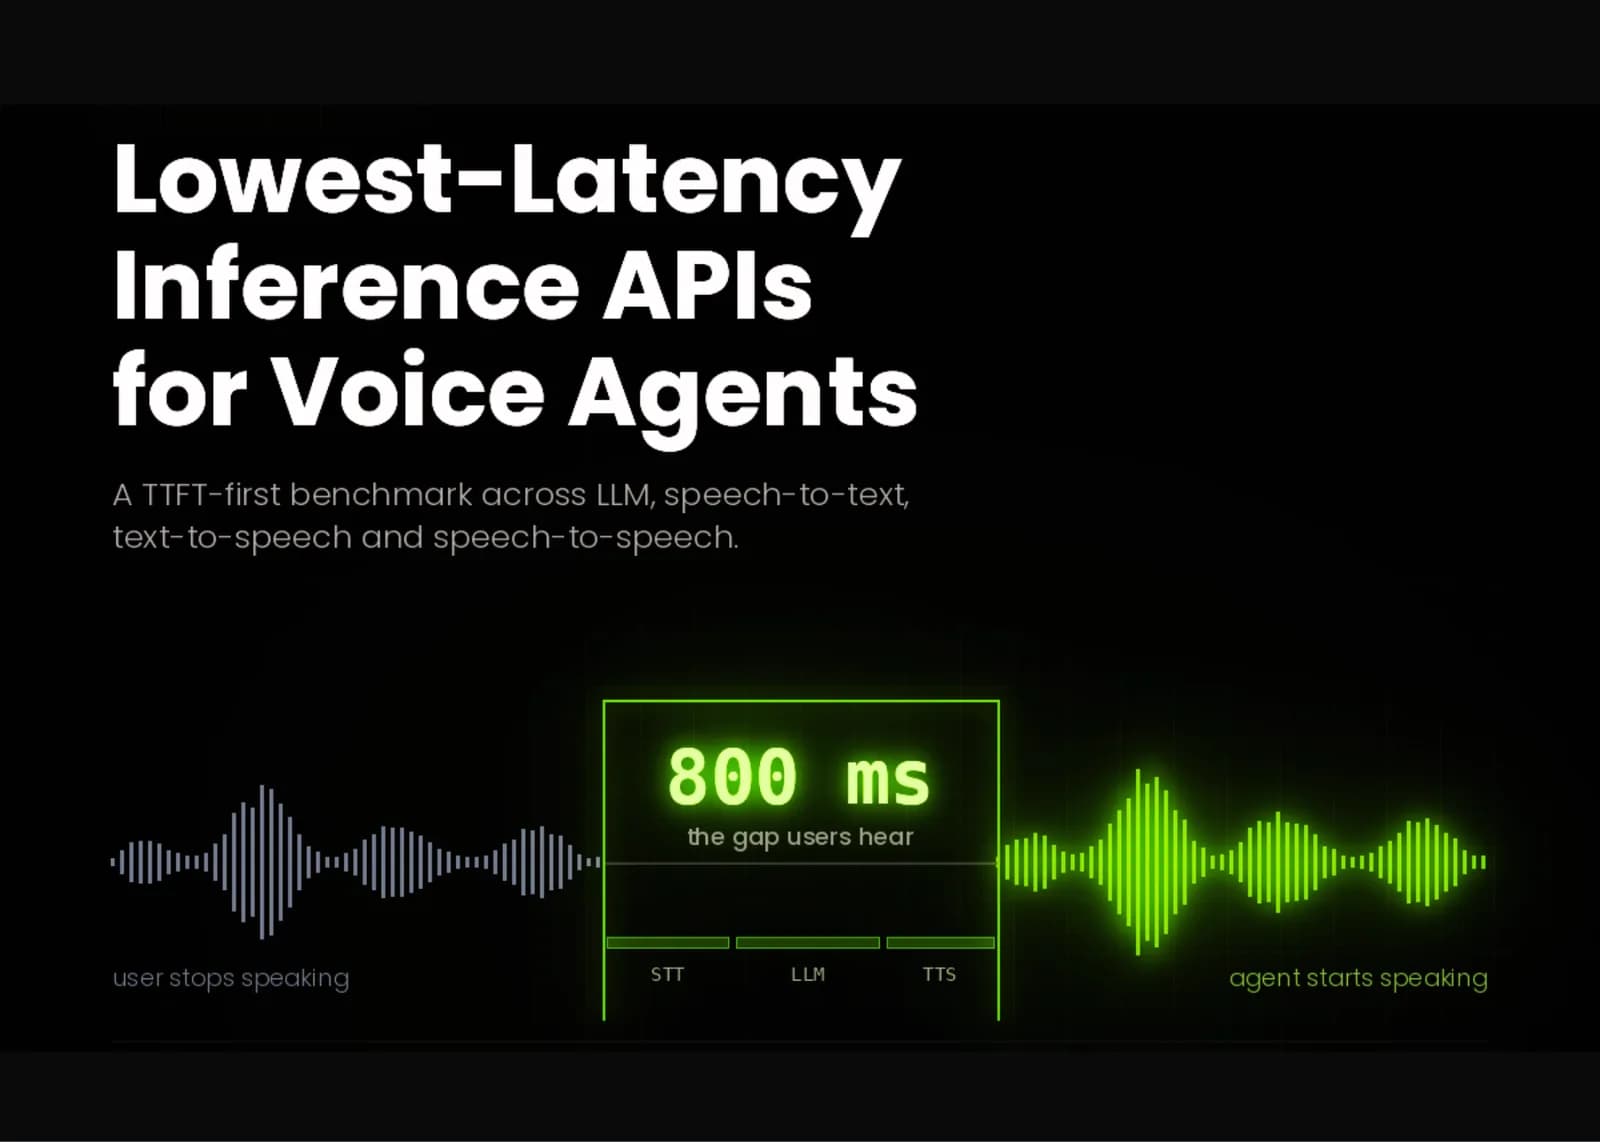
Agentes de voz: el presupuesto real de latencia es 700
IA

Agentes de voz: el presupuesto real de latencia es 700

El tiempo hasta el primer token es la métrica con la que los equipos eligen su API de inferencia, y también la que más los confunde: la síntesis no habla hasta recibir una cláusula completa.

MarkTechPost
Jalapeño, el chip de OpenAI, supera a Blackwell en trabajo por watt
IA

Jalapeño, el chip de OpenAI, supera a Blackwell en trabajo por watt

OpenAI publicó en Hot Chips 37 los primeros números de su chip de inferencia propio: entre 1,5 y 1,9 veces más trabajo por watt que los sistemas GB200 y GB300 de NVIDIA.

Latent Space
Qwen3.8-Flash-Next rinde 16.000 tokens por segundo en la GB300
IA

Qwen3.8-Flash-Next rinde 16.000 tokens por segundo en la GB300

Alibaba liberó los pesos del modelo como anticipo de la arquitectura Qwen4, y NVIDIA publicó su validación sobre el rack GB300 NVL72 con soporte desde el día cero.

NVIDIA Developer
TensorRT Model Connect: de Hugging Face a C++ en dos comandos
IA

TensorRT Model Connect: de Hugging Face a C++ en dos comandos
NVIDIA liberó implementaciones de referencia para llevar modelos abiertos desde un identificador de Hugging Face hasta inferencia nativa en C++, sin PyTorch ni Python en producción.

NVIDIA Developer
Jalapeño por dentro: 64 núcleos, cada uno con su HBM4
Electrónica

Jalapeño por dentro: 64 núcleos, cada uno con su HBM4

OpenAI detalló en Hot Chips la arquitectura NUMA de su acelerador de inferencia: 216 GB de HBM4, dos redes internas separadas y más de la mitad del núcleo escrita con ayuda de sus propios modelos.

Tom's Hardware
Vera Rubin NVL72: hasta 30 veces más trabajo por megavatio
IA

Vera Rubin NVL72: hasta 30 veces más trabajo por megavatio

Nvidia midió sus nuevos sistemas contra el GB300 NVL72 usando trayectorias reales de sesiones de programación con agentes, aunque los resultados todavía esperan revisión de SemiAnalysis.

NVIDIA Blog
Jalapeño, el chip de OpenAI, supera a Blackwell y a Rubin
IA

Jalapeño, el chip de OpenAI, supera a Blackwell y a Rubin

El primer acelerador propio de OpenAI, hecho con Broadcom, se llevó los mejores números de rendimiento por watt en el banco de pruebas InferenceX, aunque no pasa de muestras de ingeniería.

The Decoder
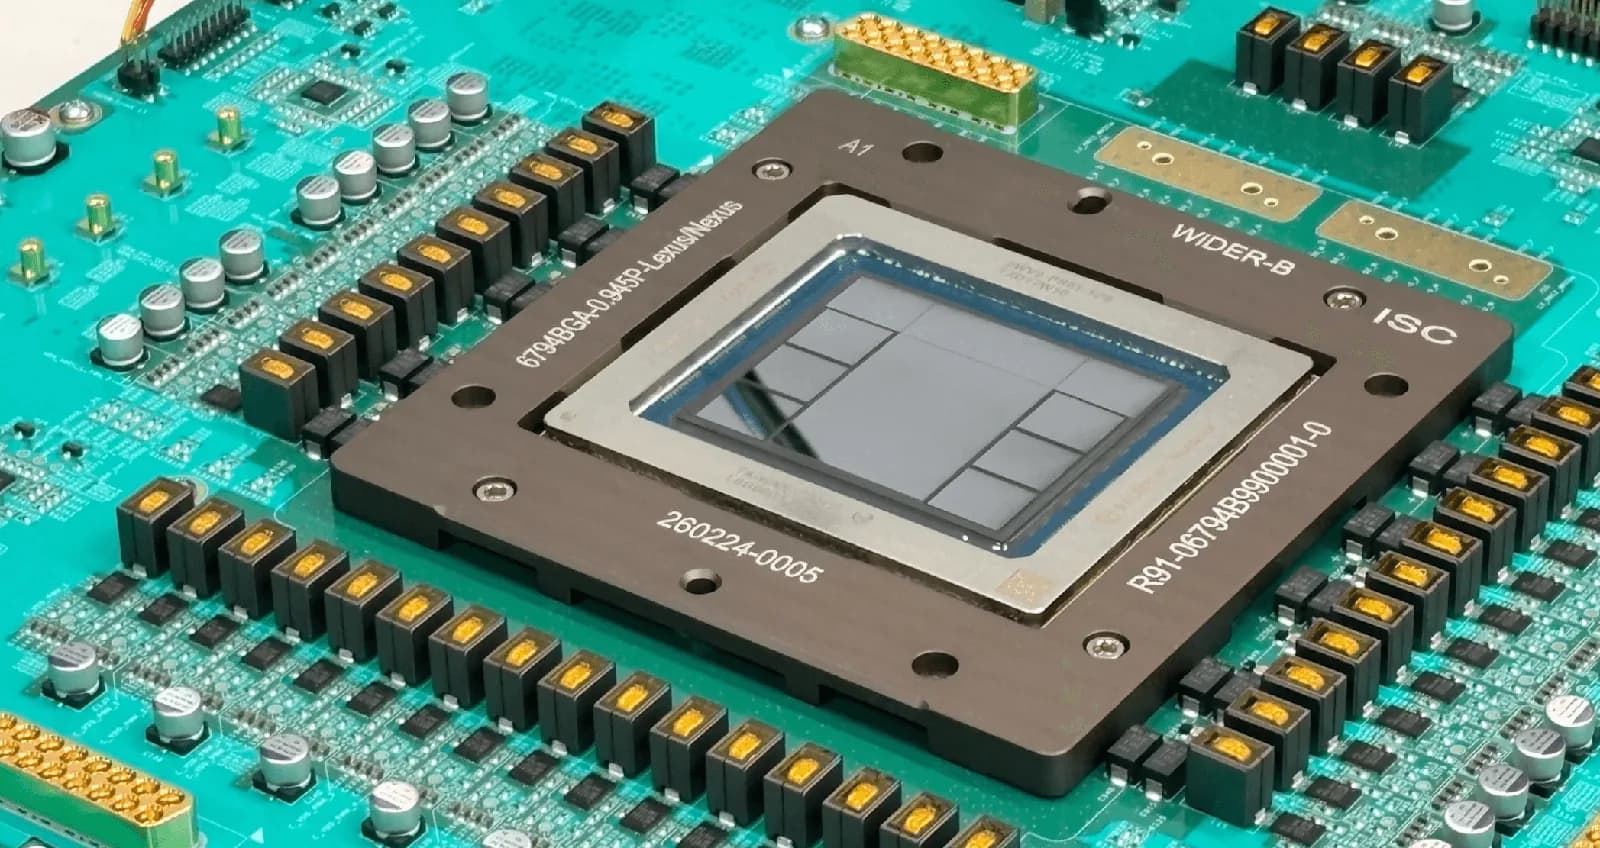
d-Matrix apila su acelerador sobre DRAM: 100 TB/s por tarjeta
Electrónica

d-Matrix apila su acelerador sobre DRAM: 100 TB/s por tarjeta

Raptor invierte el orden habitual del apilamiento 3D y deja el dado de cómputo arriba, pero la empresa aún no dice quién le fabrica la memoria a medida.

Tom's Hardware
Dynamo restaura la inferencia de un LLM en 7,3 segundos
IA

Dynamo restaura la inferencia de un LLM en 7,3 segundos

El motor sombra de NVIDIA mantiene una réplica ya inicializada en la misma GPU y comparte los pesos en memoria, con lo que el reinicio en frío de 283 segundos se vuelve innecesario.

NVIDIA Developer
Samsung LPDDR5X-PIM: 614 GB/s calculando en la memoria
Electrónica

Samsung LPDDR5X-PIM: 614 GB/s calculando en la memoria

La primera memoria de bajo consumo con lógica integrada multiplica por ocho el ancho de banda y rinde 3,01 veces más tokens por segundo en inferencia.

Tom's Hardware
Jetson Orin Nano 2: 78 TOPS y el doble de inferencia
Robótica

Jetson Orin Nano 2: 78 TOPS y el doble de inferencia

NVIDIA presentó su nuevo computador de entrada para IA de borde, que duplica el rendimiento del Orin Nano Super y consume 40% menos en modo de 15 watts.

The Robot Report
Jalapeño, el chip de OpenAI: 1,7 exaFLOPS y 27,5 TB de HBM4
Electrónica

Jalapeño, el chip de OpenAI: 1,7 exaFLOPS y 27,5 TB de HBM4

OpenAI mostró en Hot Chips su acelerador desarrollado con Broadcom, pensado solo para inferencia, con producción en volumen prevista para 2027.

The Register
OpenAI lanza Ultrafast: GPT-5.6 Sol a 750 tokens por segundo
IA

OpenAI lanza Ultrafast: GPT-5.6 Sol a 750 tokens por segundo

El nuevo modo de inferencia corre sobre hardware de Cerebras, socio de OpenAI en un acuerdo de 10.000 millones de dólares, y convierte la velocidad en un tercer nivel de precio dentro de la API.

The Decoder
Frozen v2: el chip de Google que graba Gemini en el silicio
IA

Frozen v2: el chip de Google que graba Gemini en el silicio

El chip, atribuido a Jeff Dean, grabaría el plano de Gemini en el hardware para ser 6 a 10 veces más eficiente que los TPU actuales. Google lo desplegaría desde 2028 para abaratar la inferencia.

The Decoder
SGLang sirve DeepSeek-V4 en GB300 con 5x más throughput
IA

SGLang sirve DeepSeek-V4 en GB300 con 5x más throughput

Dos meses después del lanzamiento, el stack abierto pasó de 2.200 a 11.200 tok/s/GPU a la misma interactividad gracias a KV Compression V2, W4A4 MegaMoE y CUDA graphs rompibles en el prefill.

PyTorch Blog

Etiquetas relacionadas

Otros temas que aparecen junto a #inferencia en nuestra cobertura editorial.