
Robótica
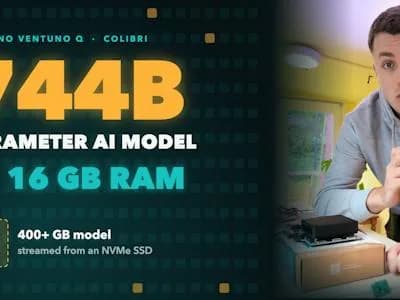
GLM-5.3 y sus 744.000 millones de parámetros corren en 16 GB de RAM
Jim Bruges carga desde un SSD solo los expertos que necesita cada token. Funciona, aunque GLM-5.3 tardó siete minutos en nombrar tres planetas.
Hackster.io
6 notas publicadas
Mistral lo apoda Le Chonk, lo entrenó con unas 3.800 GPU Grace Blackwell en Europa y liberará los pesos en Hugging Face dentro de octubre.
La startup de Brooklyn dice que Beam iguala a GLM-5.2 de Z.ai en razonamiento con 3 a 4 veces menos cómputo de inferencia, y promete liberar los pesos este mes.
El nuevo sistema del Allen Institute for AI triplica el rendimiento de su versión anterior en GPU B300 y será la base del próximo Olmo.
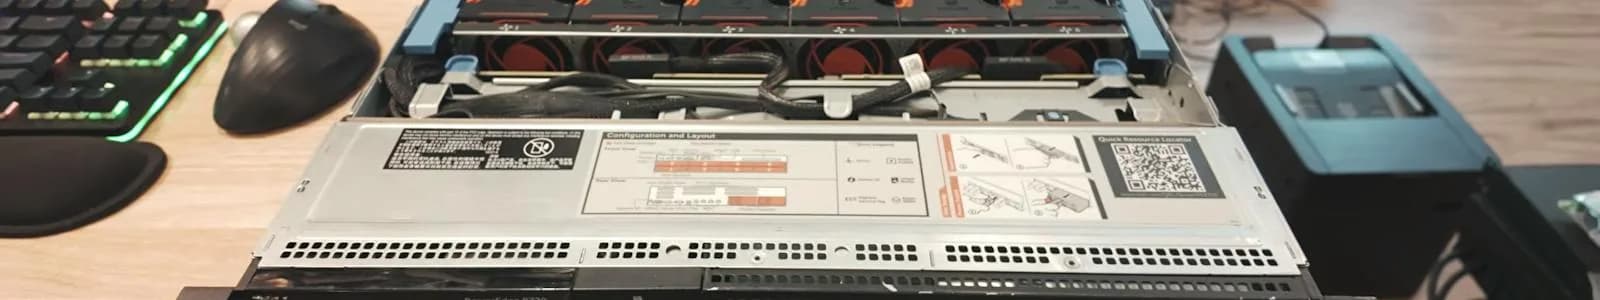
El youtuber MattMo llenó un Dell PowerEdge R720 de 2012 con 384 GB de memoria DDR3 ECC y ejecutó modelos completos en los dos Xeon, sin una sola tarjeta aceleradora.
Los kernels de Transformer Engine para JAX atacan los tensores irregulares del enrutamiento sin descartes, en una línea base donde la comunicación entre GPU se comía el 84% del tiempo de kernel.
Otros temas que aparecen junto a #mezcla de expertos en nuestra cobertura editorial.