
IA
MIT entrena una IA que lee la estructura 3D de los cristales
El modelo une estructuras atómicas con descripciones en lenguaje natural y encontró candidatos para electrolitos de baterías de litio de estado sólido.
MIT CSAIL
19 notas publicadas
Google DeepMind lanzó Live Avatar para Gemini Enterprise, un rostro animado que sincroniza labios y gestos con la voz del modelo y llama herramientas sin cortar la conversación.
Alibaba lo dejó disponible por API con contexto de 1 millón de tokens y sin pesos abiertos, y liberó aparte los complementos Qwen-MM-Plugins bajo Apache-2.0.
Extended Thinking encabeza el índice de voz de Artificial Analysis con 82,6 puntos, y la versión base cuesta US$0,84 por hora de audio.
La desagregación encode-prefill-decode separa el encoder de visión del resto de la inferencia y rinde en cargas con muchas imágenes, pero se vuelve contraproducente con salidas largas.
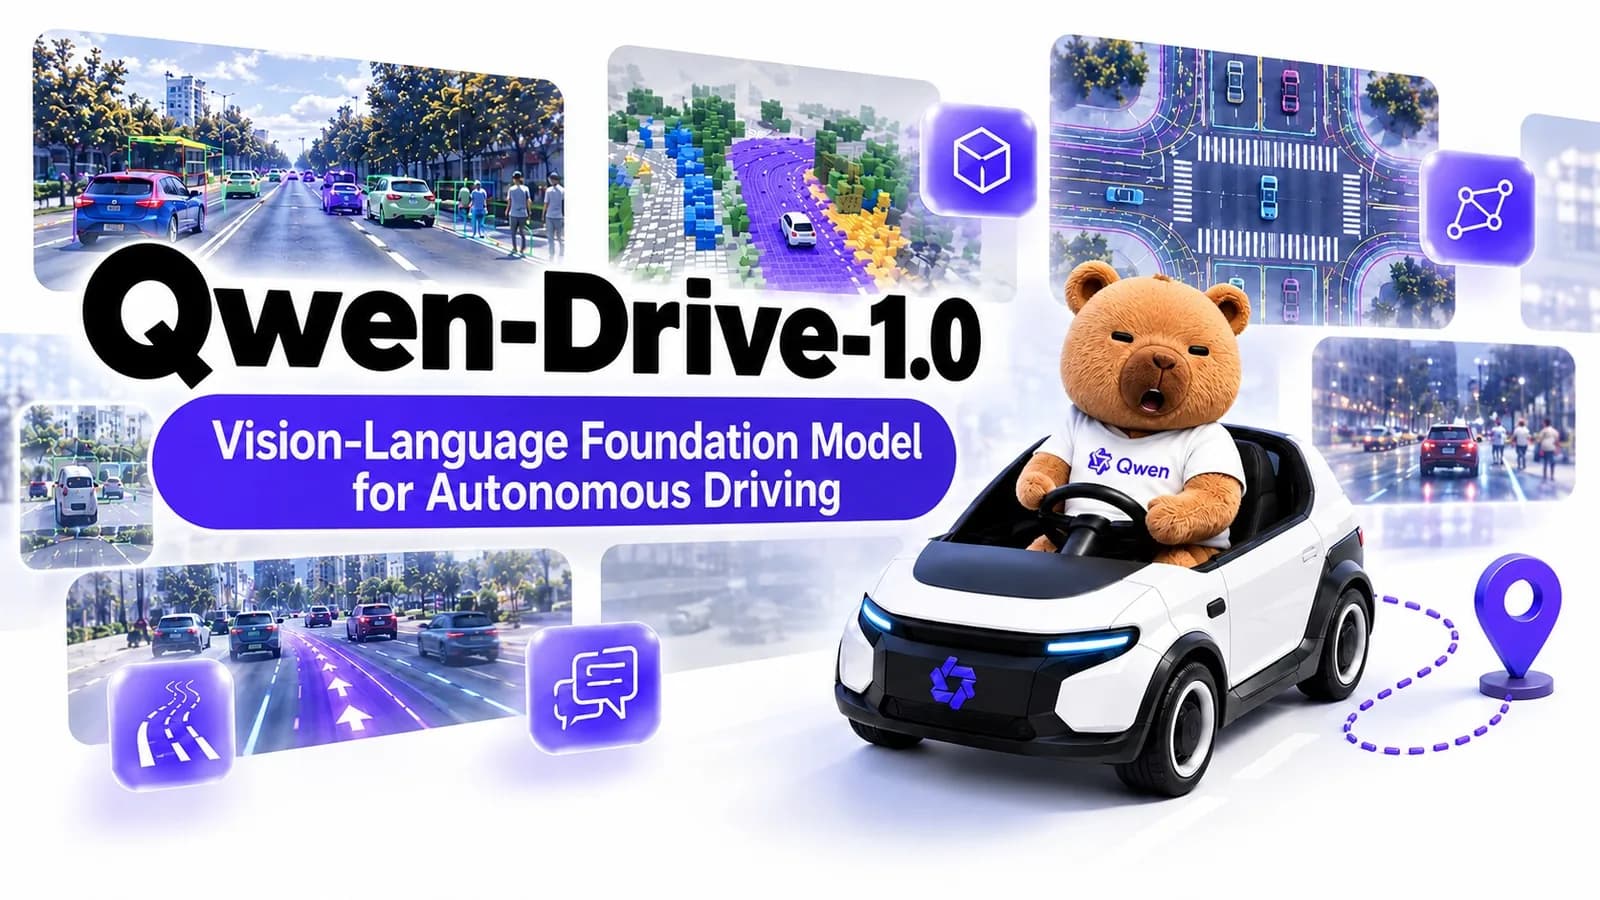
El modelo de Alibaba unifica percepción espacial, preguntas de tránsito y planificación de ruta, y bajó del 24% al 12% las salidas de calzada en simulación.
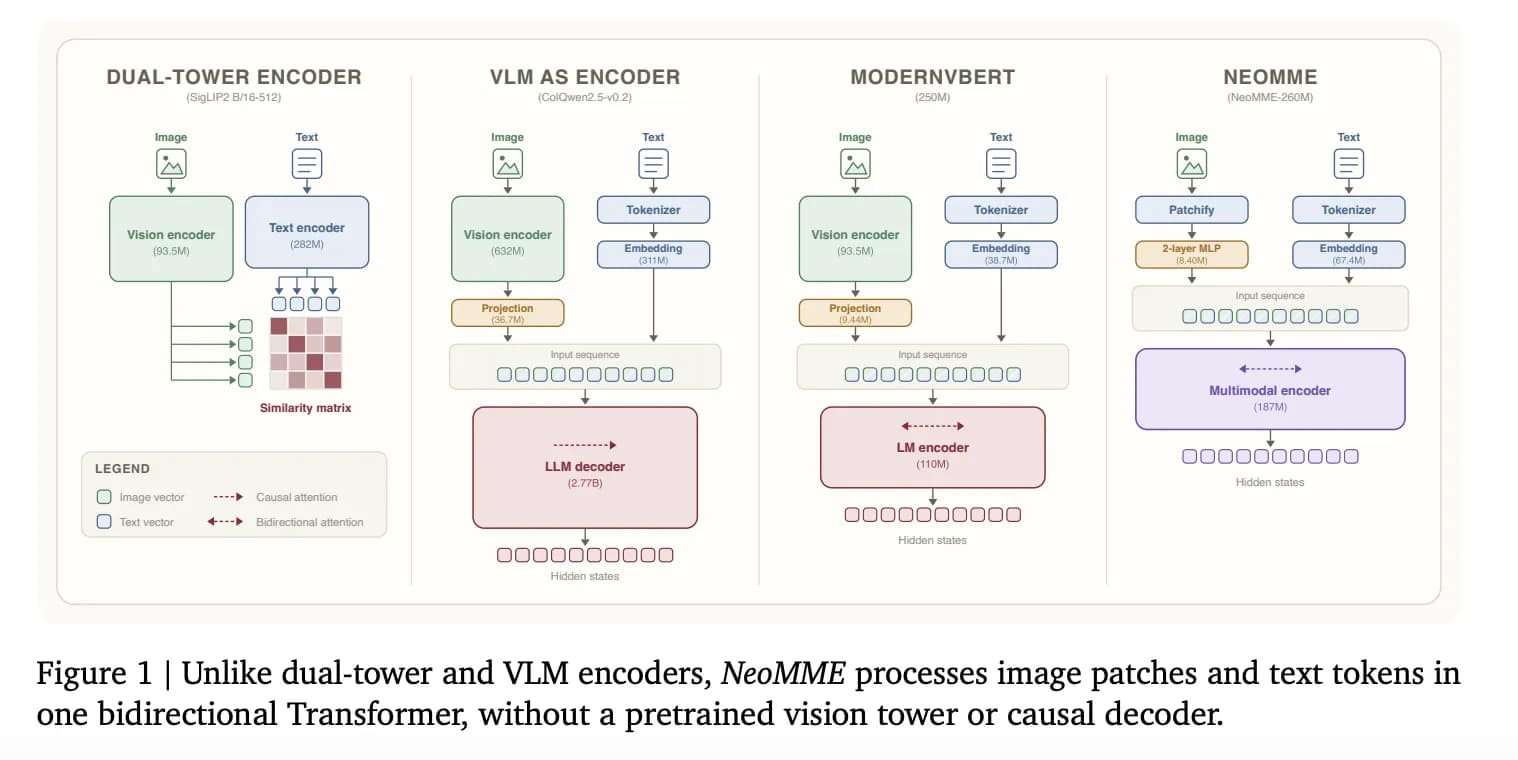
H Company presenta NeoMME, una familia de encoders multimodales que elimina la visión tower y el decoder causal para mejorar la eficiencia en tareas de recuperación.
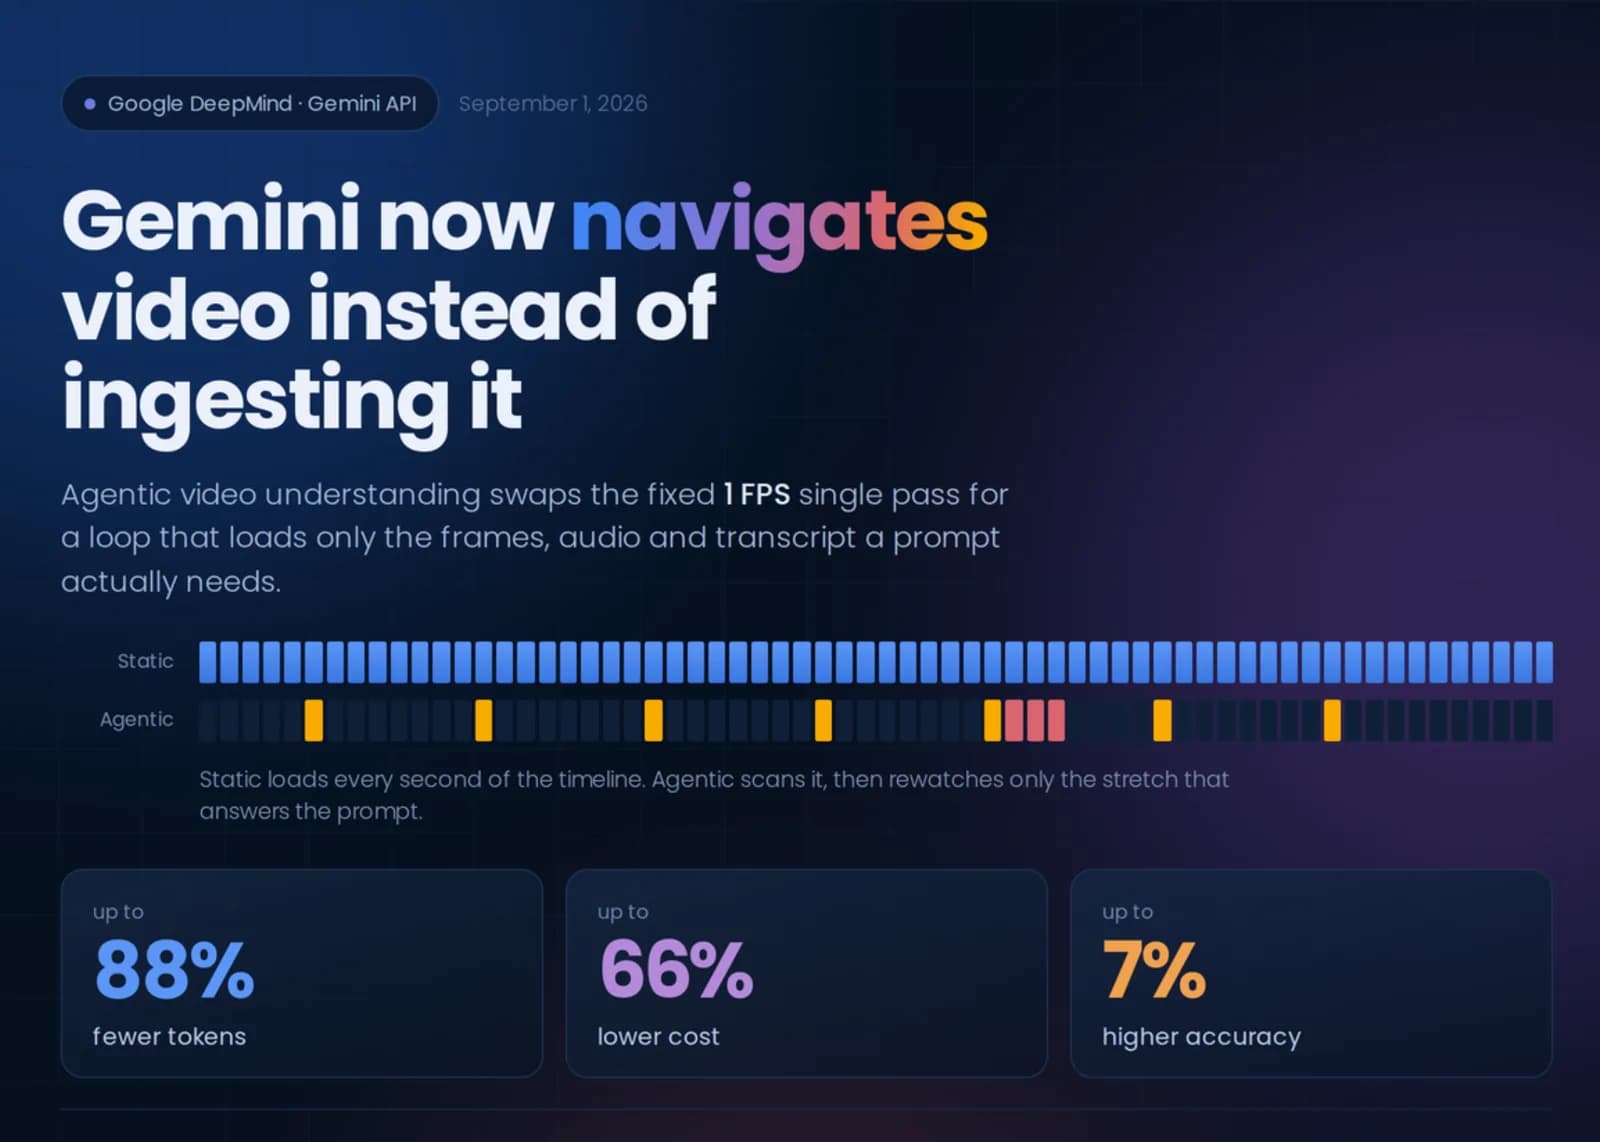
Google habilitó el modo agéntico de comprensión de video en sus modelos Flash: en vez de tragarse la línea de tiempo completa a un cuadro por segundo, el modelo decide qué mirar.
La nueva función agéntica deja que el modelo decida qué tramos del video revisar, en vez de ingerir el archivo completo, y baja los costos hasta 66% según Google.
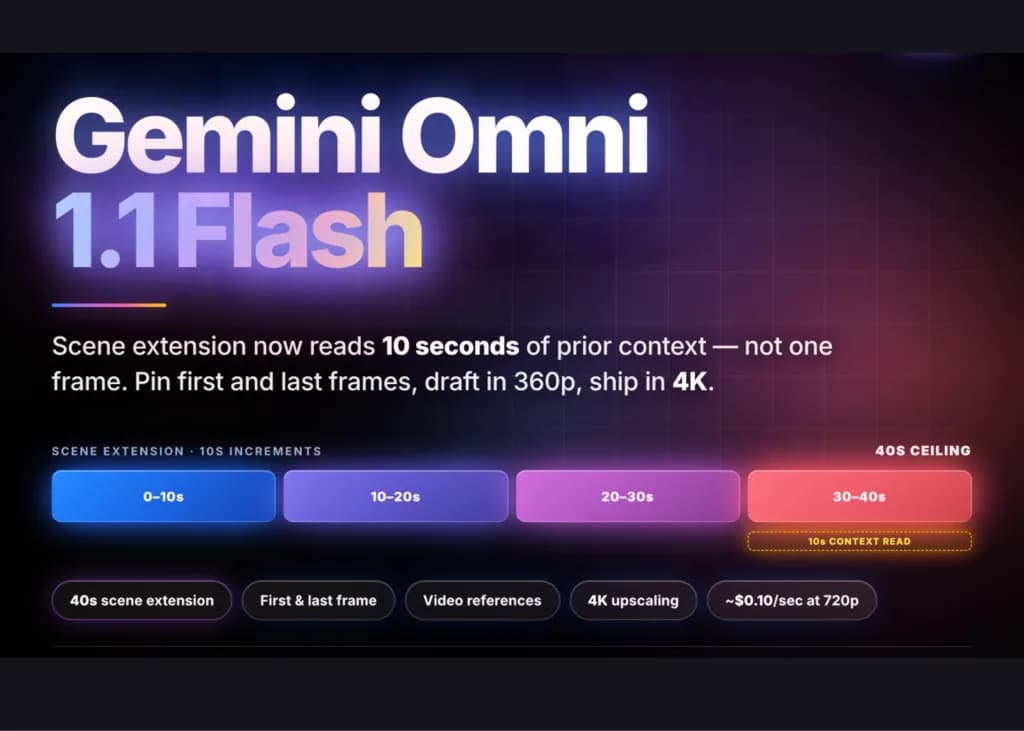
La actualización lee 10 segundos de contexto previo en vez de un solo cuadro final, permite fijar primer y último fotograma, y deja hacer borradores en 360p a un tercio del costo.
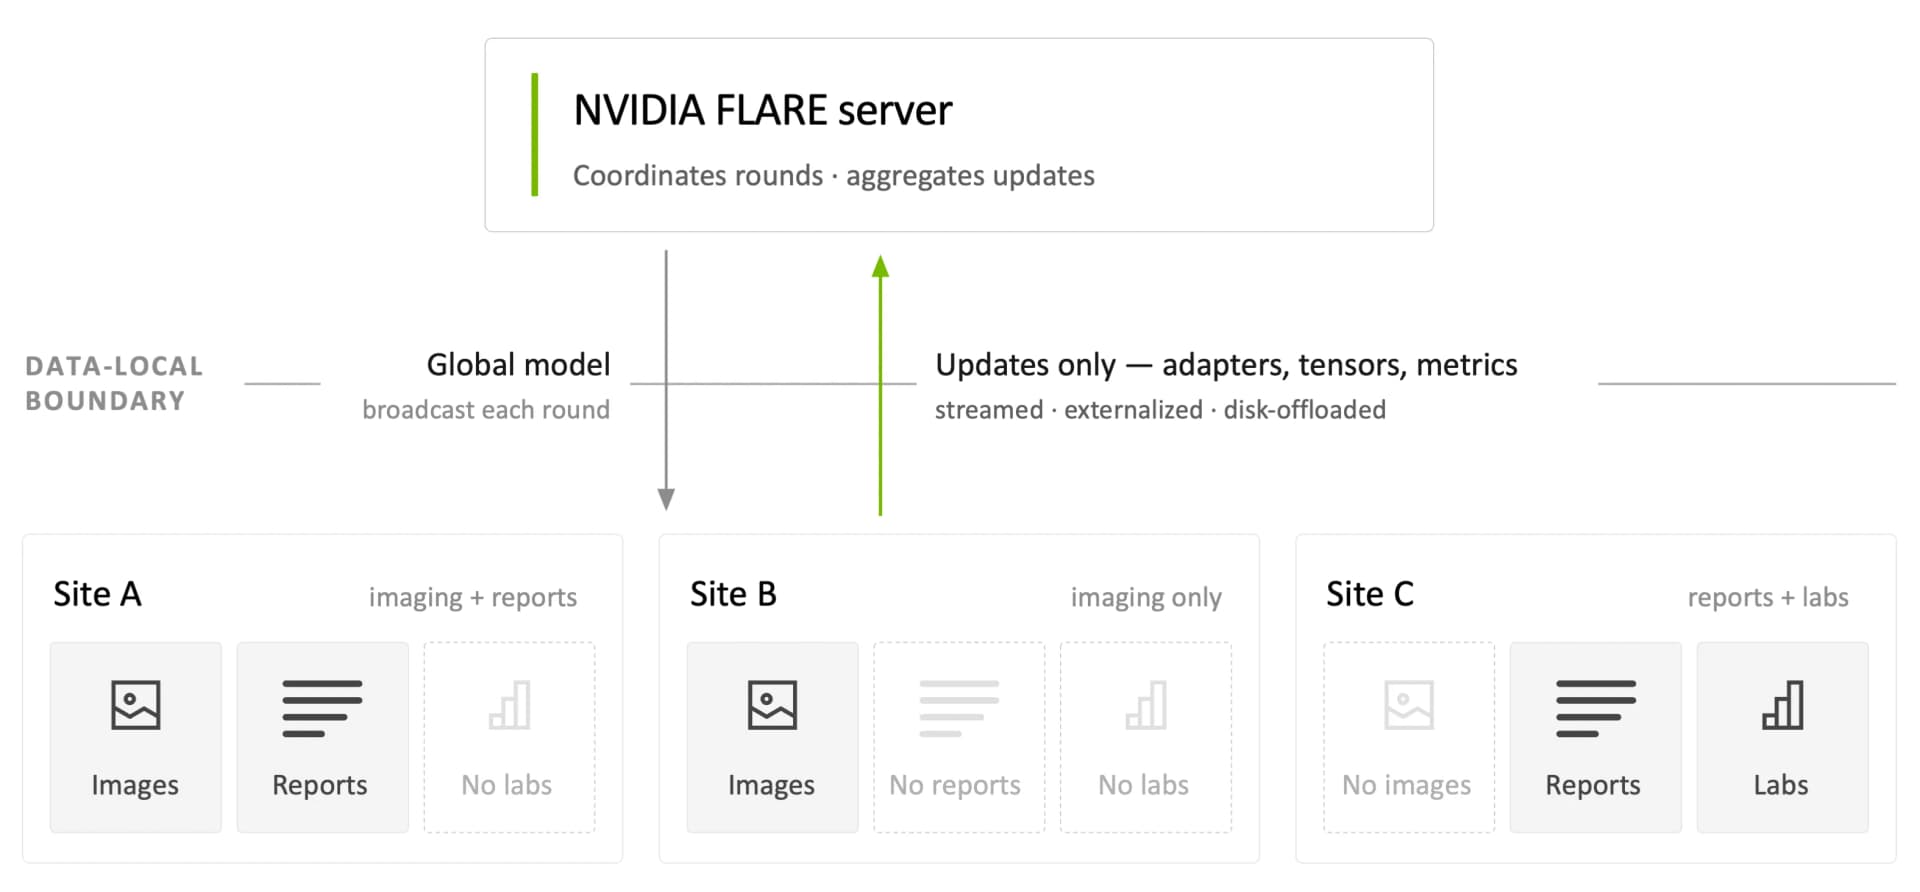
El truco es intercambiar solo adaptadores LoRA sobre un modelo base congelado. FedUMM, desarrollado con William & Mary, mantiene el 97% del rendimiento de un entrenamiento centralizado.
BFL presenta FLUX 3, un modelo multimodal capaz de generar video con audio, texto y controlar robots, superando a competidores como Gemini Omni y Grok Imagine.
Black Forest Labs presenta un modelo multimodal que aprende de imágenes, video y audio, y que la empresa alemana ya prueba en robótica junto a Audi.
El modelo multimodal de 2,4 billones de parámetros llega en versión preview y busca frenar el impulso de Kimi K3 antes de que Moonshot AI salga a bolsa.
Thinking Machines Lab, la empresa de Mira Murati, presenta su primer modelo entrenado desde cero: 975.000 millones de parámetros, multimodal y con pesos abiertos de uso comercial libre.
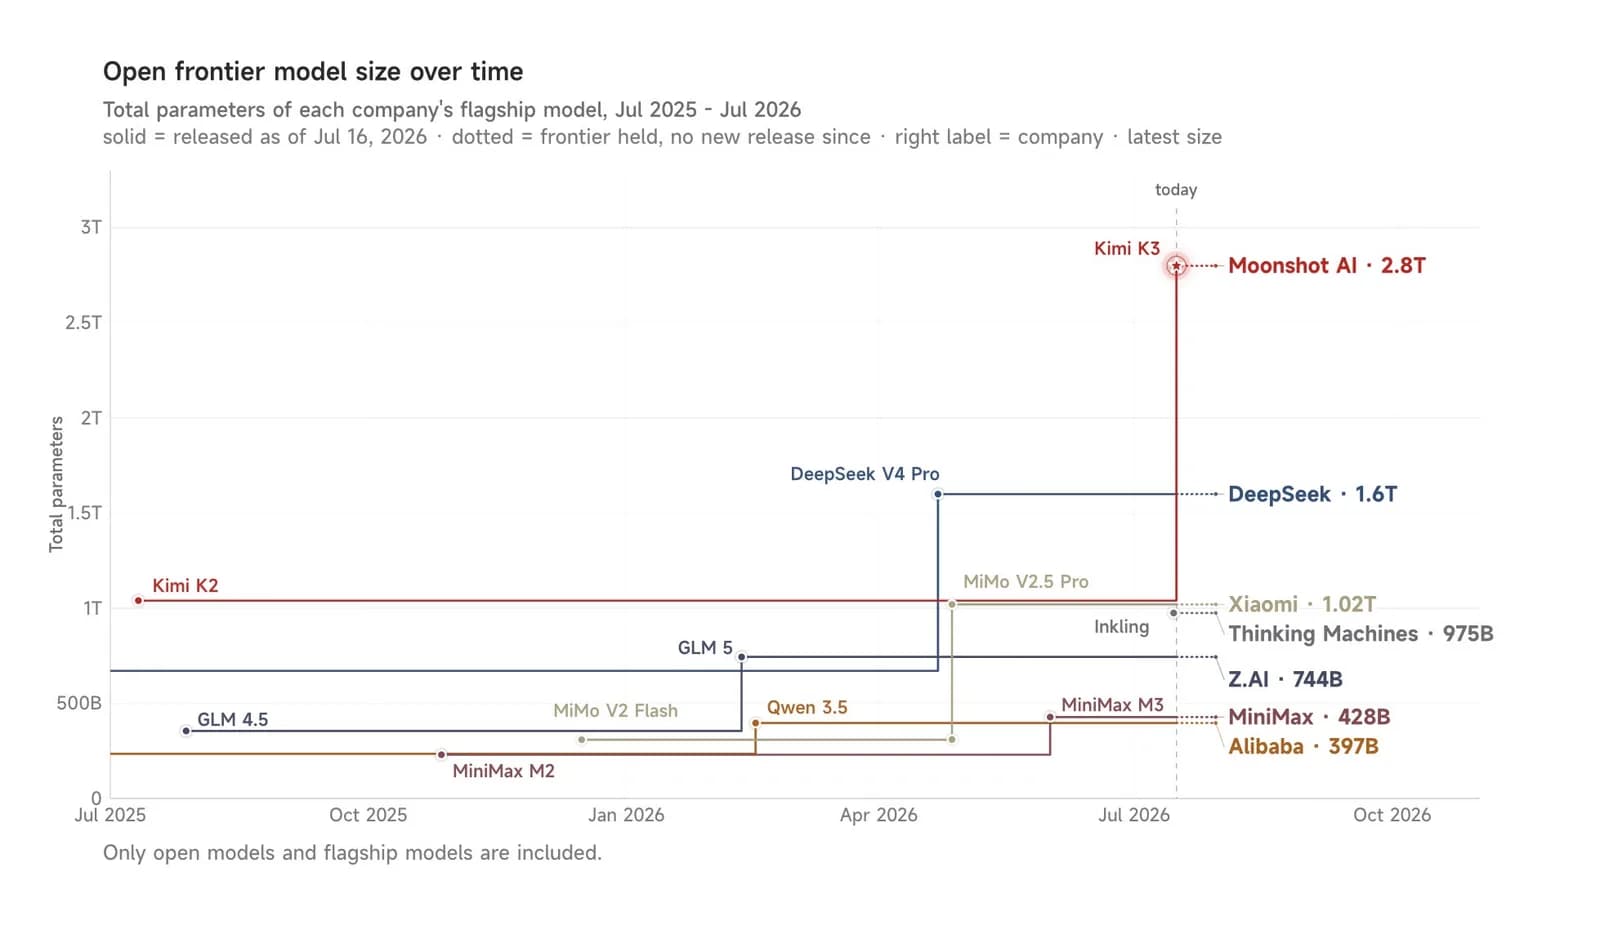
Moonshot AI presenta un modelo de 2,8 billones de parámetros con contexto de 1 millón de tokens y pesos abiertos prometidos para el 27 de julio, que ya lidera el ranking de código frontend.
Inkling es un modelo open-weight de 975.000 millones de parámetros entrenado desde cero para entender texto, audio y video, y podría posicionar a la startup de Mira Murati frente a OpenAI y Anthropic.
El sistema de reconocimiento de voz tiene 2.000 millones de parámetros, se publica bajo licencia Apache 2.0 y ataca dialectos, mezcla árabe-inglés y vocabulario especializado.
Google DeepMind presenta Gemma 4 12B, un modelo de 12 mil millones de parámetros diseñado para ejecutar inteligencia multimodal avanzada directamente en tu laptop.
Otros temas que aparecen junto a #multimodal en nuestra cobertura editorial.