Nvidia lanza Nemotron 3.5, modelos abiertos para agentes en empresas y P
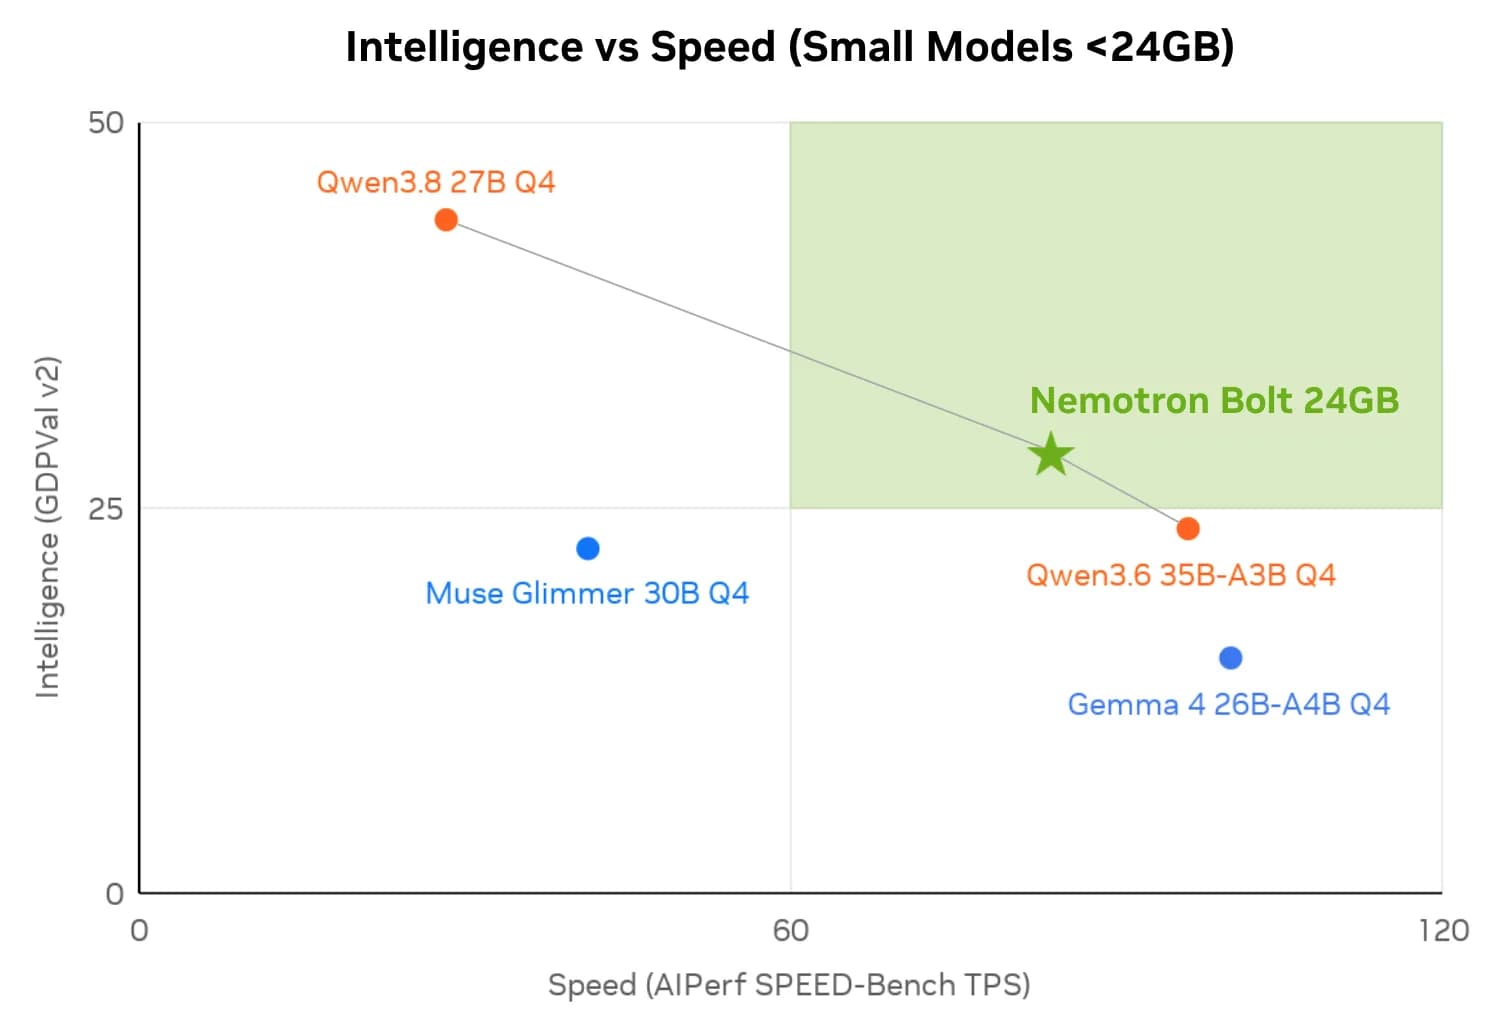
Super VL tiene 120.000 millones de parámetros y apunta al centro de datos, mientras los dos Bolt están hechos para correr local en equipos con RTX Spark y DGX Spark.
15 notas publicadas

Super VL tiene 120.000 millones de parámetros y apunta a agentes empresariales. Los Bolt corren en 24 GB y 4 GB de memoria, en PC y Jetson.

NVIDIA especializó su familia Nemotron 3 con ajuste fino y aprendizaje por refuerzo, y liberó en Hugging Face los modelos, los datos y las recetas.

NVIDIA explica con Nemotron 3.5 Lightning en qué se diferencian los modelos densos y los de mezcla de expertos, y por qué la decisión depende del presupuesto de memoria y de la concurrencia.

Koa se construyó sobre Nemotron, el modelo de pesos abiertos de Nvidia, y se entrenó con datos sintéticos que imitan llamadas de servicio al cliente sin usar información real de las empresas.

La cuantización NVFP4 combinada con decodificación especulativa multiplica por 6,28 el rendimiento frente a BF16, según las pruebas que NVIDIA publicó para sus placas AGX Thor y AGX Orin.

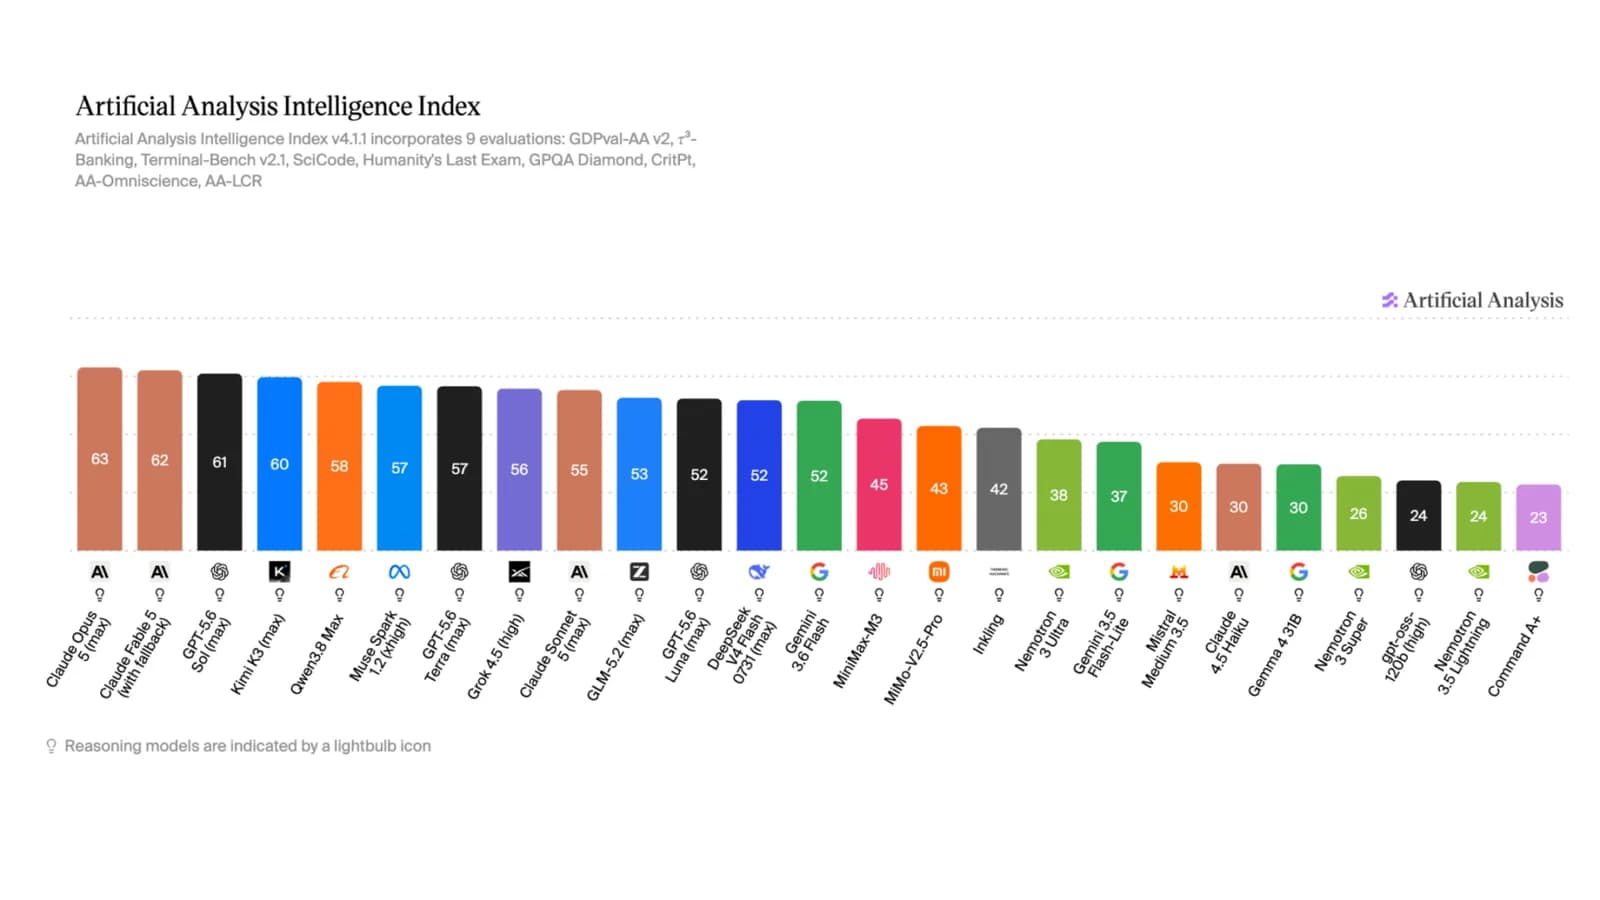
Artificial Analysis midió el modelo abierto de NVIDIA: la mayor velocidad de su clase, un salto de nueve puntos en inteligencia y un Elo agéntico superior al de modelos cuatro veces más grandes.

NVIDIA expande su familia Nemotron con un modelo de 30B parámetros diseñado para agentes inteligentes, optimizado para ejecución local y menores costos.

NVIDIA expande su ecosistema con el modelo Nemotron 3.5 Lightning y la biblioteca NeMo Switchyard para optimizar el despliegue de agentes IA autónomos.

El modelo de NVIDIA alcanza 97,1% de tasa de aprobacion en el benchmark CVDP usando hasta 71% menos tokens que sus rivales de codigo abierto en diseno de chips.

NVIDIA y LangChain muestran cómo la ingeniería de arnés acerca a un modelo abierto a la precisión de frontera, ajustando el entorno del agente en lugar de los pesos del modelo.

LangChain ajustó su harness Deep Agents para el modelo abierto de NVIDIA y logró paridad con los modelos cerrados a un décimo del costo de inferencia.

El equipo de NVIDIA reduce el checkpoint del modelo de 550B desde 1.121 GB en BF16 a 352 GB en NVFP4, con la técnica four-over-six que recupera 98,5% de la precisión sobre Blackwell.

El nuevo modelo Mixture-of-Experts de NVIDIA promete mayor velocidad, eficiencia en contextos largos y una arquitectura diseñada para flujos de trabajo complejos.

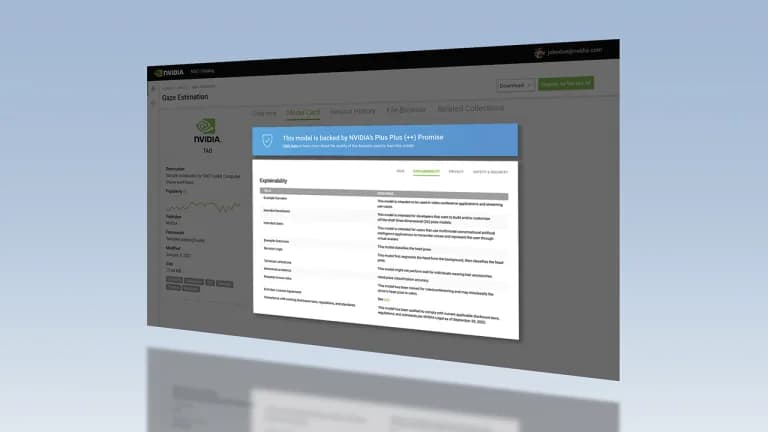
El toolkit Model Card Generator de NVIDIA construye documentación completa en formato Model Card++ a partir del código fuente, con 91% de completitud y 76% de precisión en menos de un minuto.
Otros temas que aparecen junto a #nemotron en nuestra cobertura editorial.