
IA
Transformers ya corre los modelos GGUF de llama.cpp
La integración reutiliza los kernels de ggml, parte por los Mac con Apple Silicon y arranca con la arquitectura Qwen3.5.
Hugging Face
7 notas publicadas
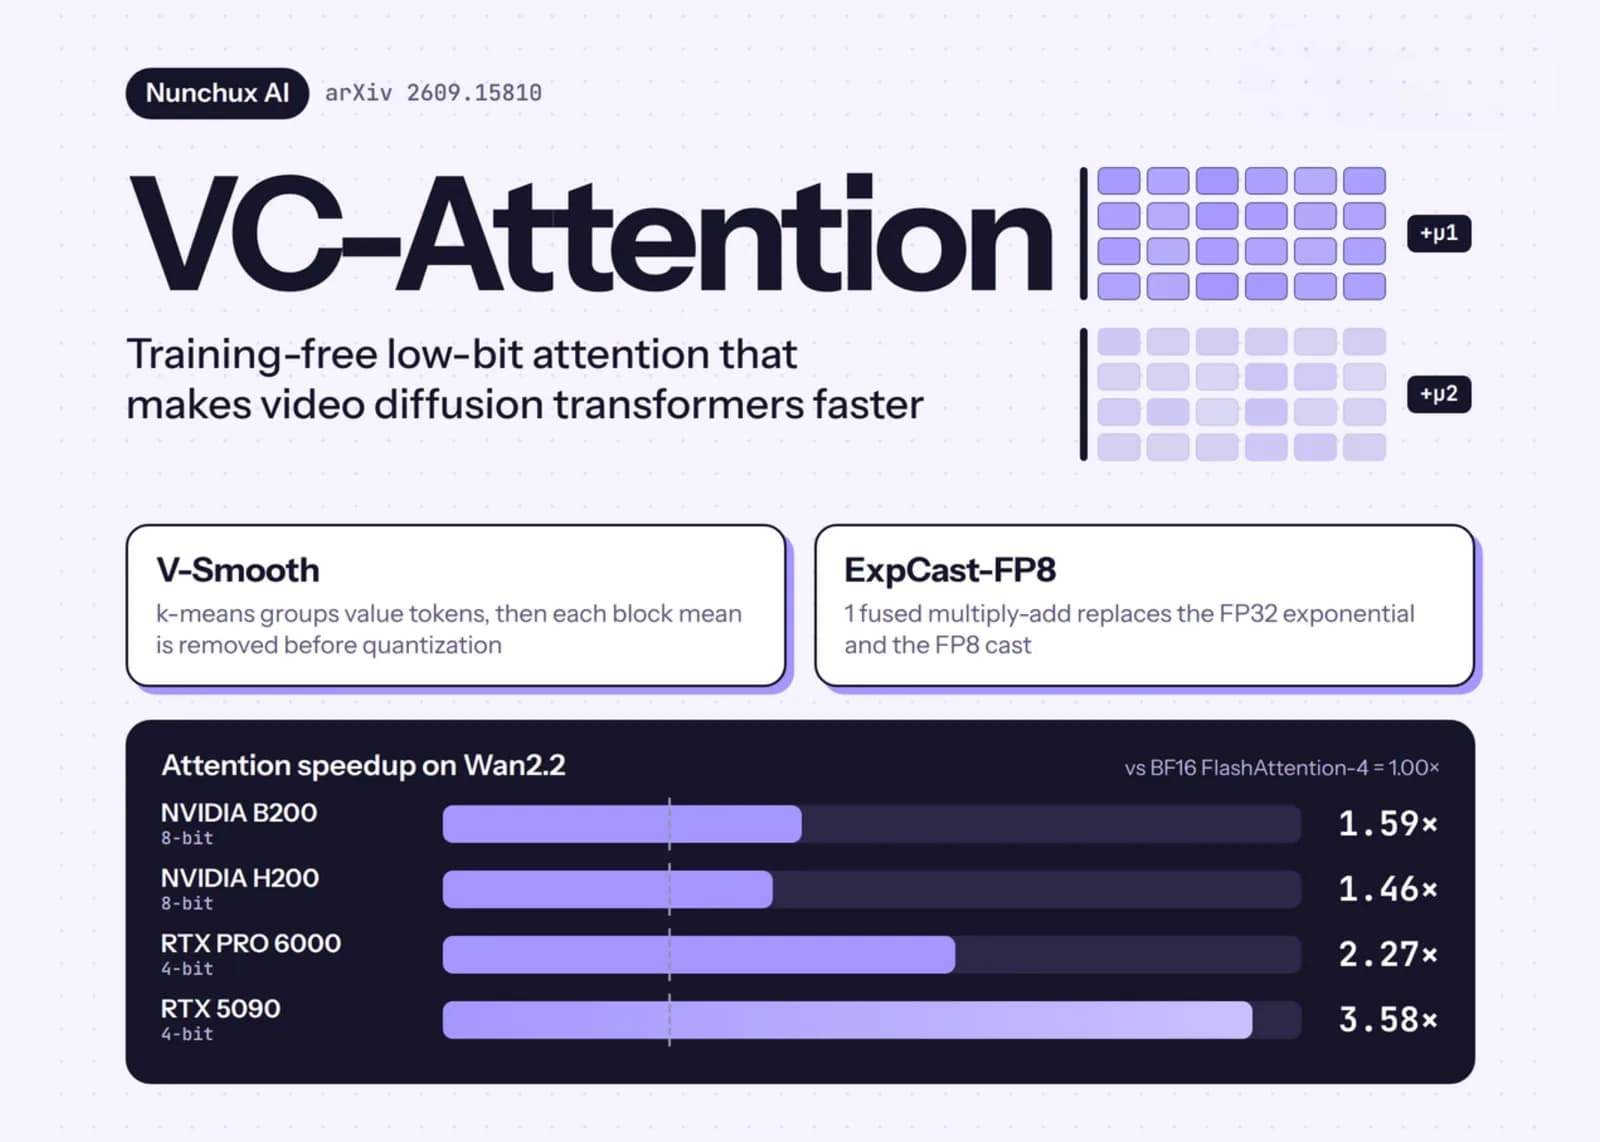
El kernel de Nunchux AI cuantiza solo el residuo de los valores y cambia la exponencial en FP32 del softmax por una multiplicación y suma fusionadas, sin entrenamiento previo.
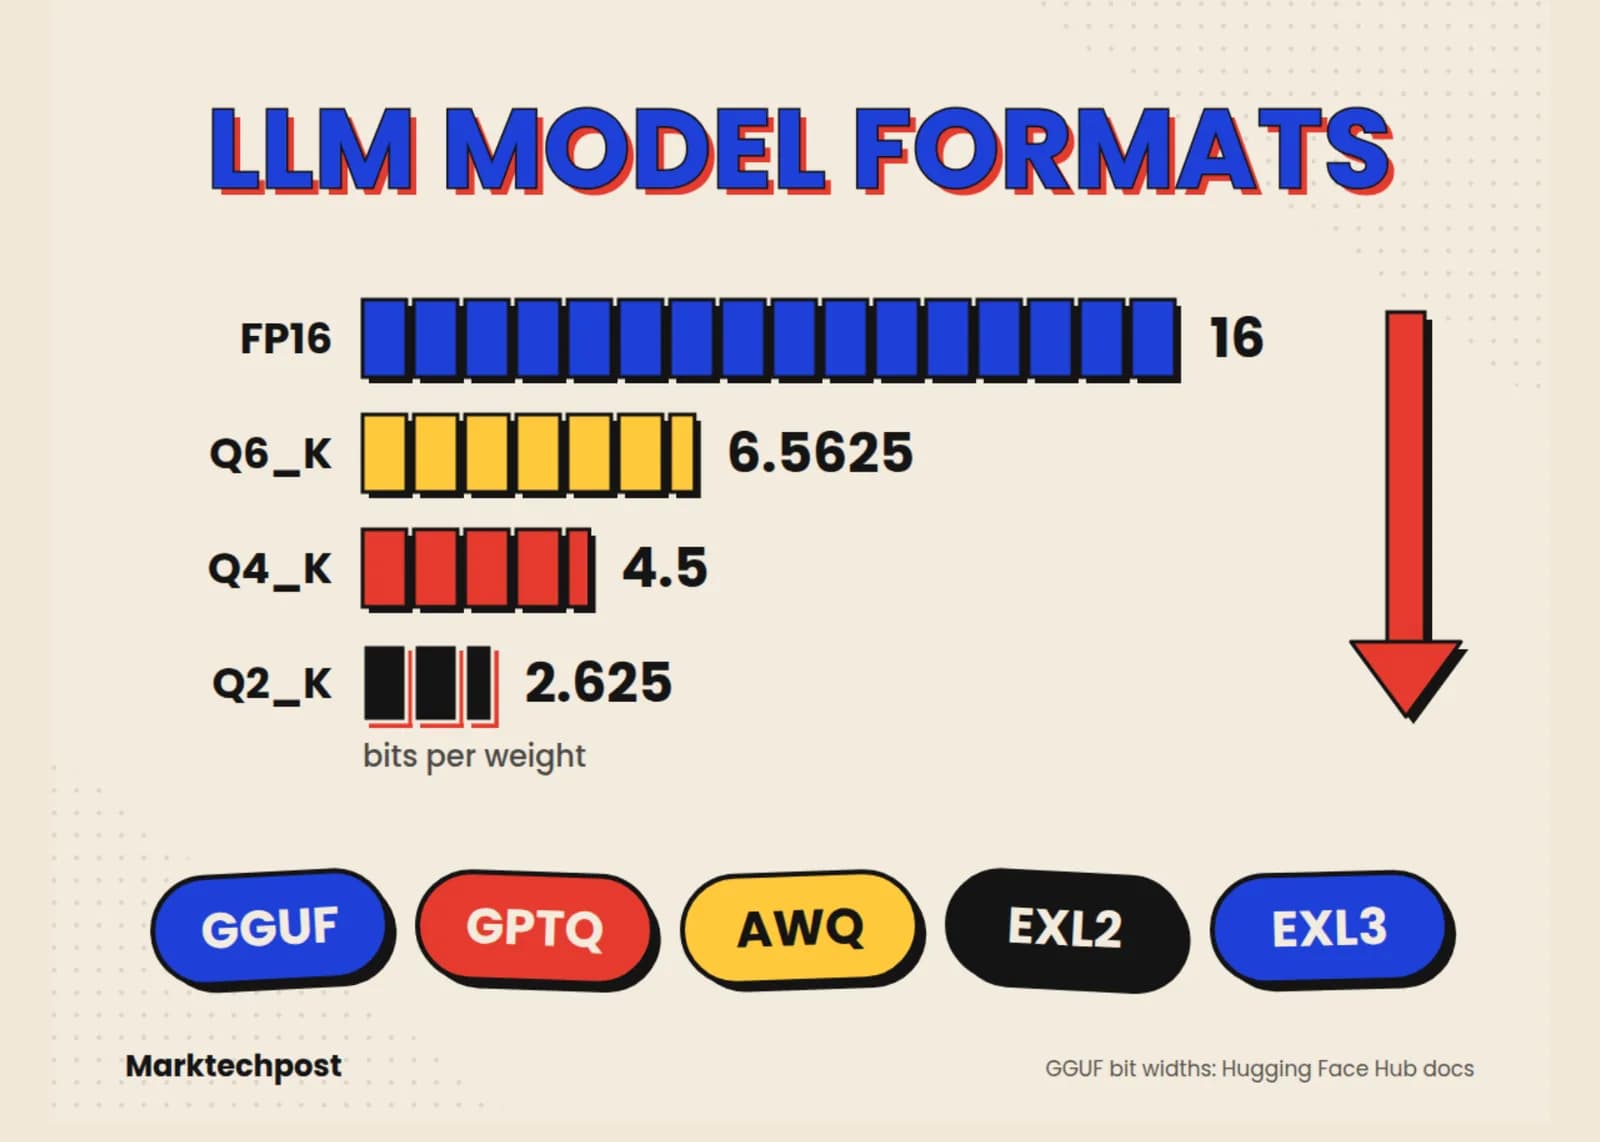
La confusión parte por mezclar dos capas distintas, el contenedor que guarda los tensores en disco y el método que aprieta los pesos a menos bits.
La cuantización NVFP4 combinada con decodificación especulativa multiplica por 6,28 el rendimiento frente a BF16, según las pruebas que NVIDIA publicó para sus placas AGX Thor y AGX Orin.
La compañía publicó un marco de trabajo que ordena el cálculo alrededor del uso real de la carga, con cuatro escenarios de empresa y sus requisitos de memoria.
El equipo de NVIDIA reduce el checkpoint del modelo de 550B desde 1.121 GB en BF16 a 352 GB en NVFP4, con la técnica four-over-six que recupera 98,5% de la precisión sobre Blackwell.
Receta paso a paso de post-training quantization con ModelOpt que lleva CLIP-ViT-L-14 de FP16 a FP8 sin perder calidad en clasificación zero-shot ni retrieval.
Otros temas que aparecen junto a #cuantizacion en nuestra cobertura editorial.