
NVIDIA PAIR une los PC ociosos de la casa en un clúster de IA
El Personal AI Router es software libre, funciona con GeForce RTX 20 en adelante y también con chips Apple M4, y aprovecha los equipos mientras nadie los usa.
The Verge
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.
El Personal AI Router es software libre, funciona con GeForce RTX 20 en adelante y también con chips Apple M4, y aprovecha los equipos mientras nadie los usa.
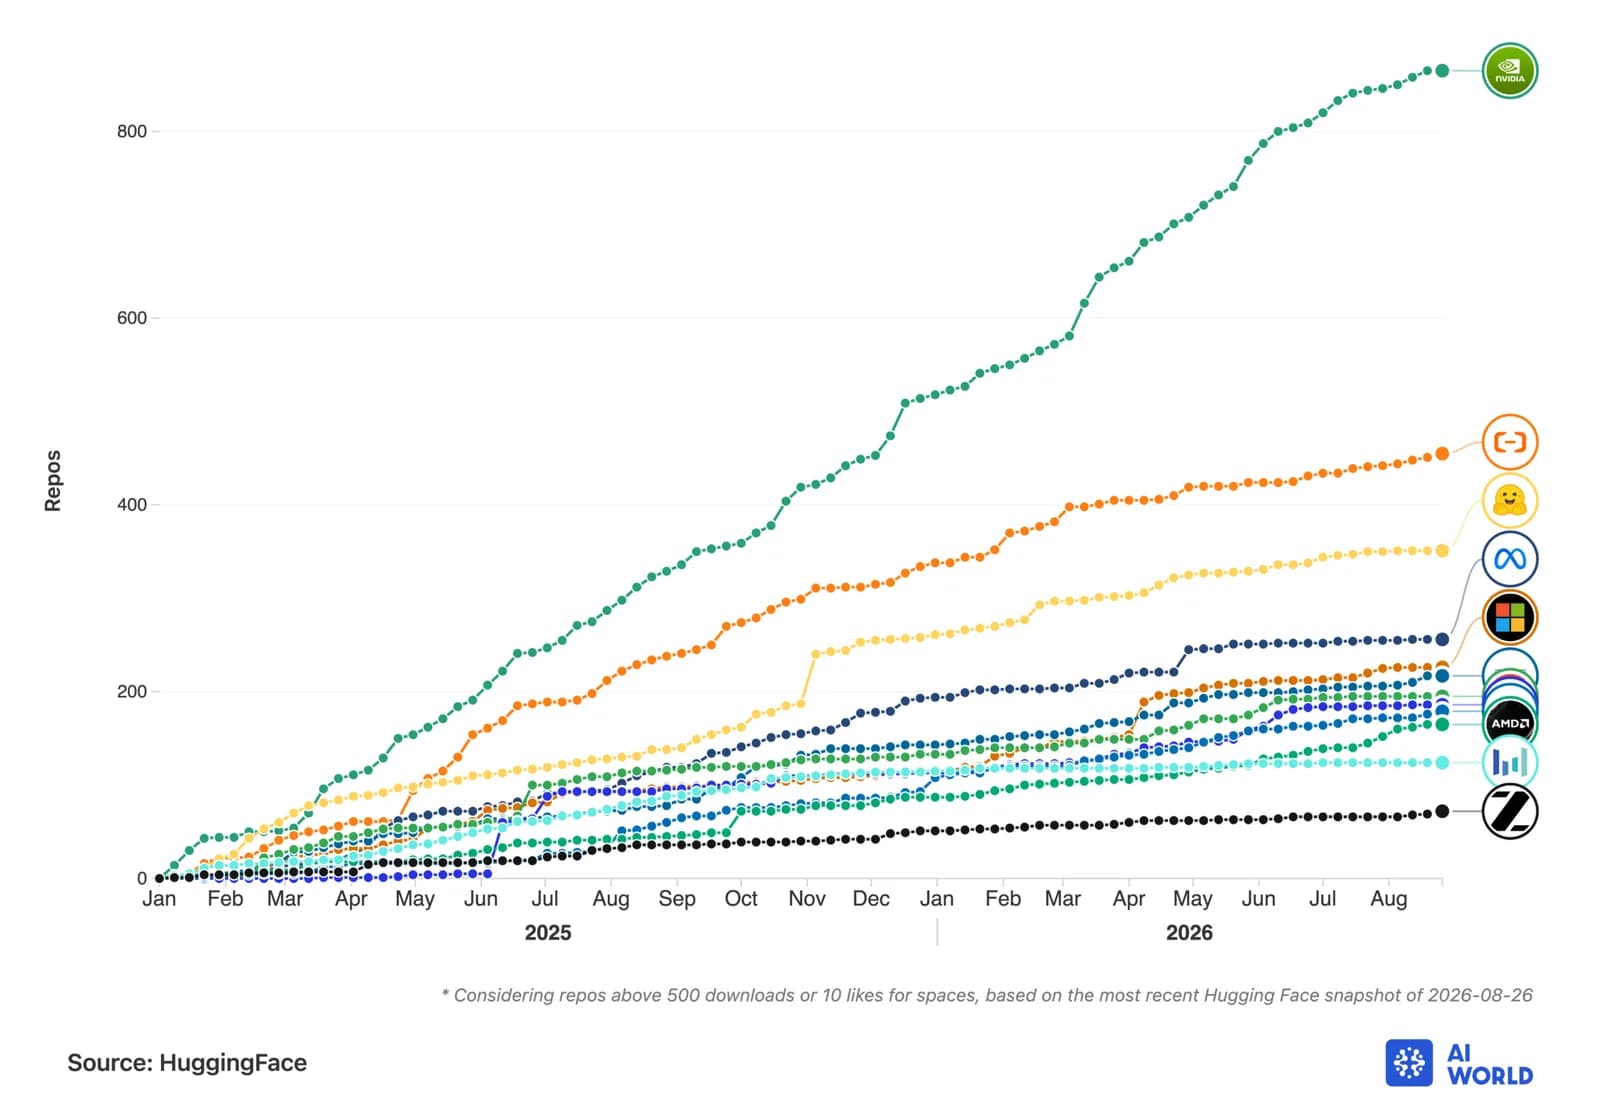
La compañía de Jensen Huang se queda con el repositorio donde 18 millones de desarrolladores publican modelos abiertos, y promete mantenerlo neutral respecto del hardware.
Google habilita el modo agéntico en Gemini 3.7 Flash, 3.6 Flash y 3.5 Flash-Lite: el modelo elige qué tramos del video revisar y a qué resolución, con una baja de 66% en el costo por consulta.
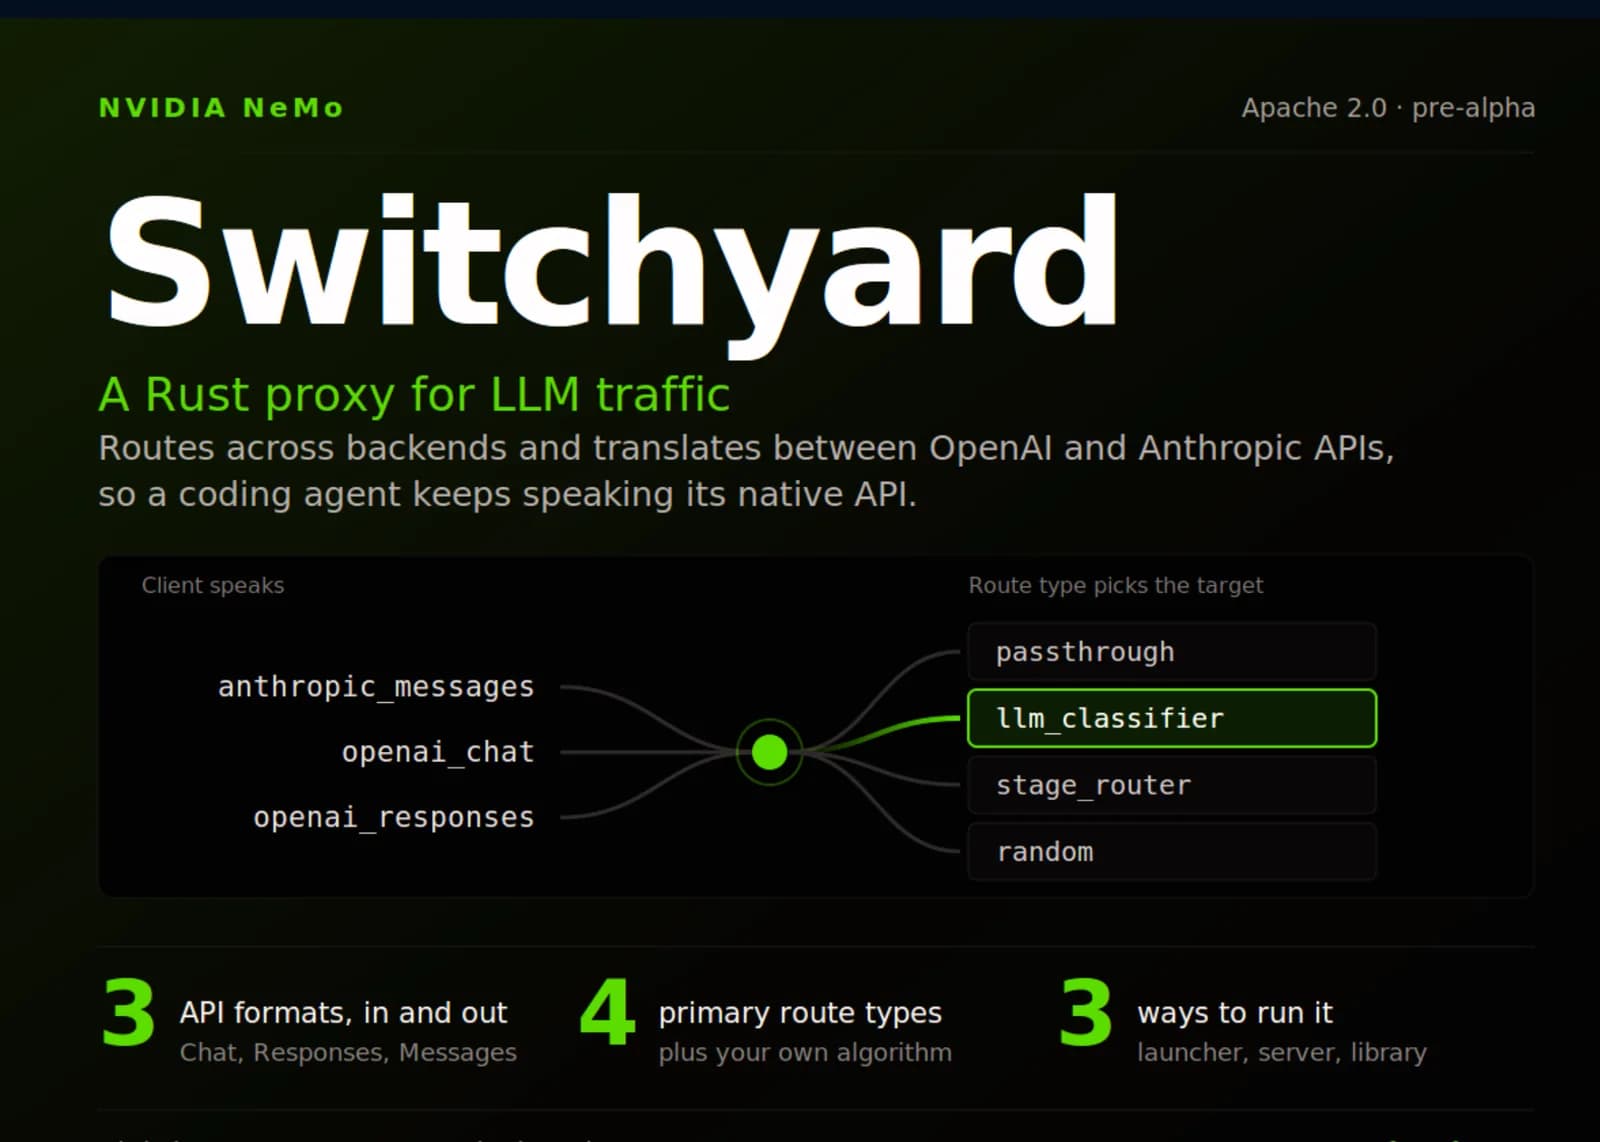
El proxy traduce en ambos sentidos entre los formatos de OpenAI y Anthropic, así que Claude Code y Codex CLI pueden apuntar al mismo modelo sin tocar el agente.
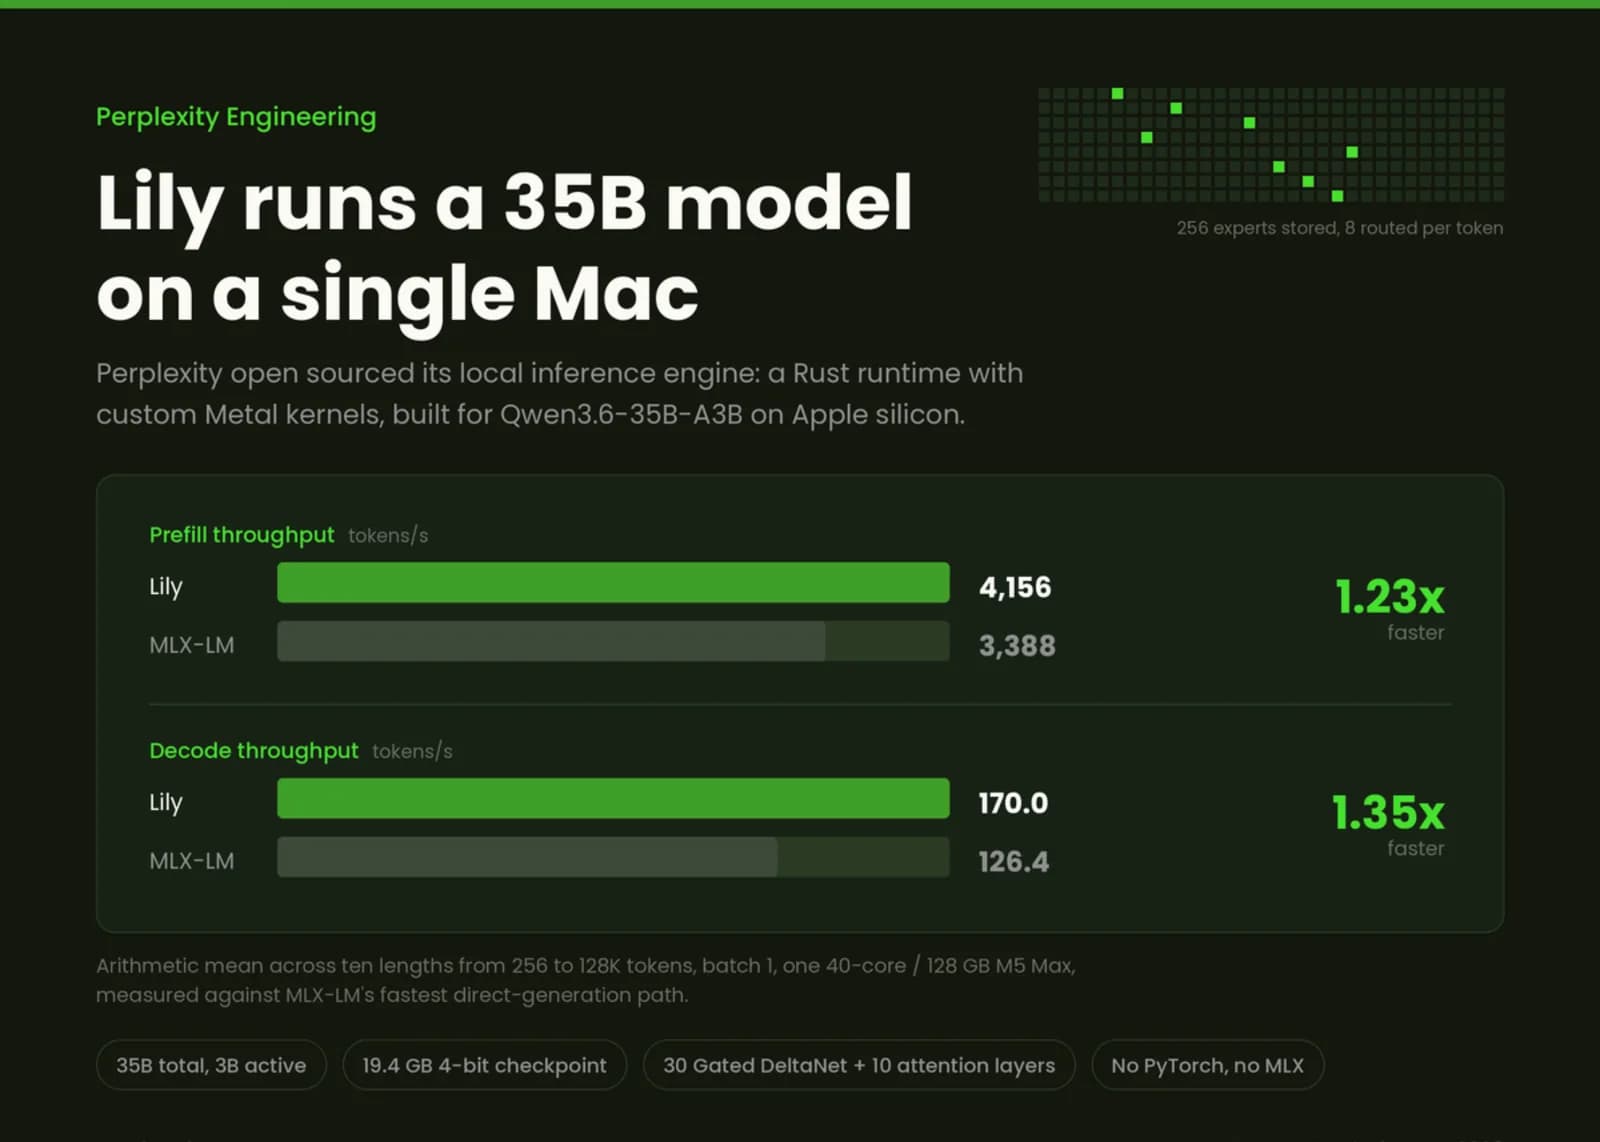
El motor detrás de Hybrid Compute corre Qwen3.6-35B-A3B sin PyTorch ni MLX en el camino de ejecución, con kernels Metal escritos a mano.
Simon Willison corrió su prueba del pelícano en bicicleta en los cinco niveles de razonamiento del modelo de Anthropic: del más barato al más caro hay 33 veces de diferencia en costo.
Anthropic lanzó Fable 5.1 y Mythos 5.1, bajó la lectura de caché de 1 a 0,25 dólares por millón de tokens y duplicó su puntaje en investigación científica con agentes.
Google publicó su tercer modelo económico en seis semanas, pero el nuevo Flash razona más y quema cerca de 30% más tokens de salida por tarea.
World Labs, la empresa de Fei-Fei Li, presentó un modelo que genera, reconstruye y simula escenas tridimensionales, y que según sus mediciones supera a los modelos especializados en su propio terreno.
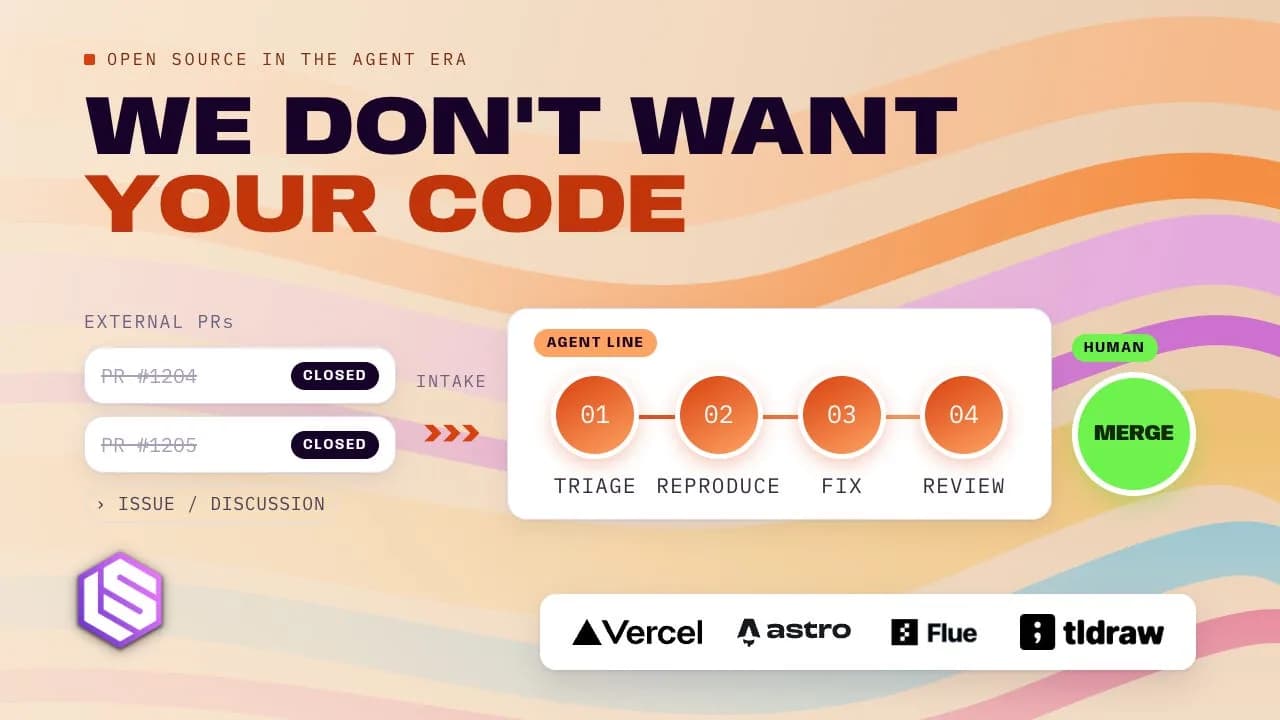
Los mantenedores prefieren agentes propios antes que aportes externos generados con IA, y convierten cada pull request en una discusión o un reporte de error.
La compañía publicó un marco de trabajo que ordena el cálculo alrededor del uso real de la carga, con cuatro escenarios de empresa y sus requisitos de memoria.
La nueva función agéntica deja que el modelo decida qué tramos del video revisar, en vez de ingerir el archivo completo, y baja los costos hasta 66% según Google.
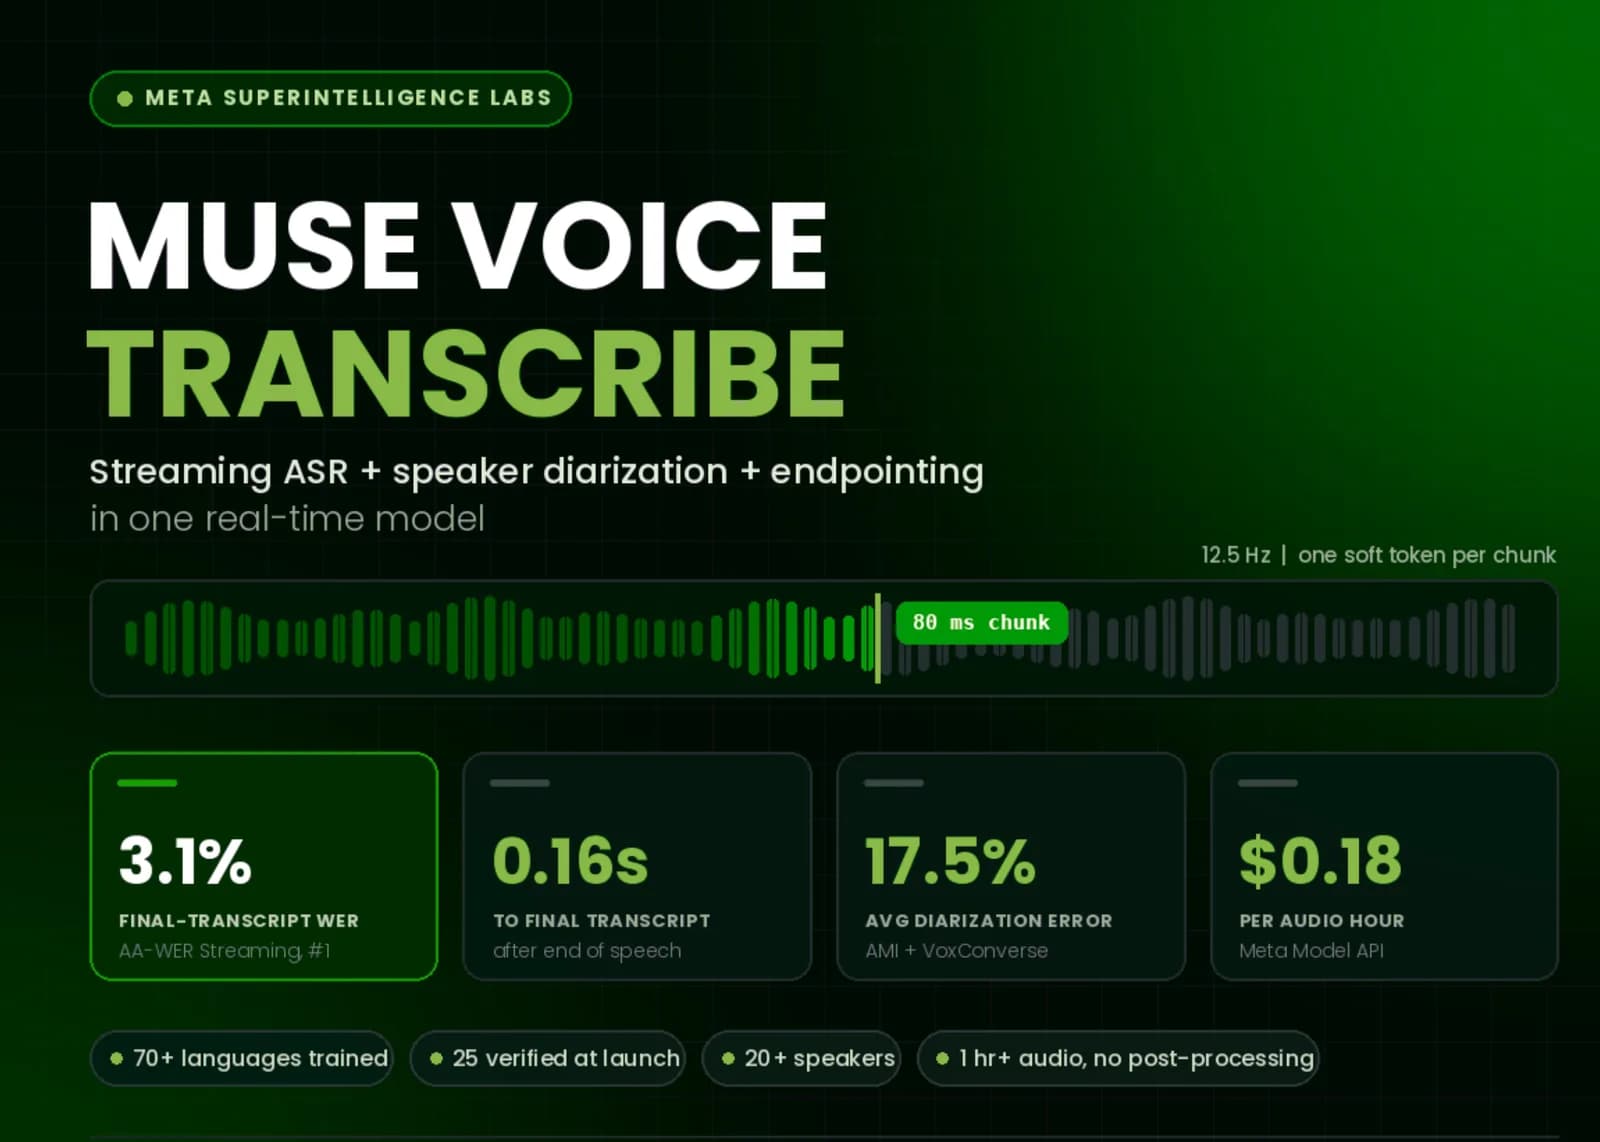
Un solo modelo autorregresivo reemplaza a los tres sistemas encadenados que hoy usan las aplicaciones de voz: transcripción, separación de hablantes y detección de fin de turno.
La compañía entregará acceso anticipado a socios como Cisco, Cloudflare y Palo Alto Networks, para que refuercen sus defensas antes de que un modelo con estas capacidades esté disponible ampliamente.
Anthropic presentó dos modelos que comparten arquitectura y se diferencian solo en el nivel de resguardos, con una rebaja de precio que se concentra en la lectura de caché.
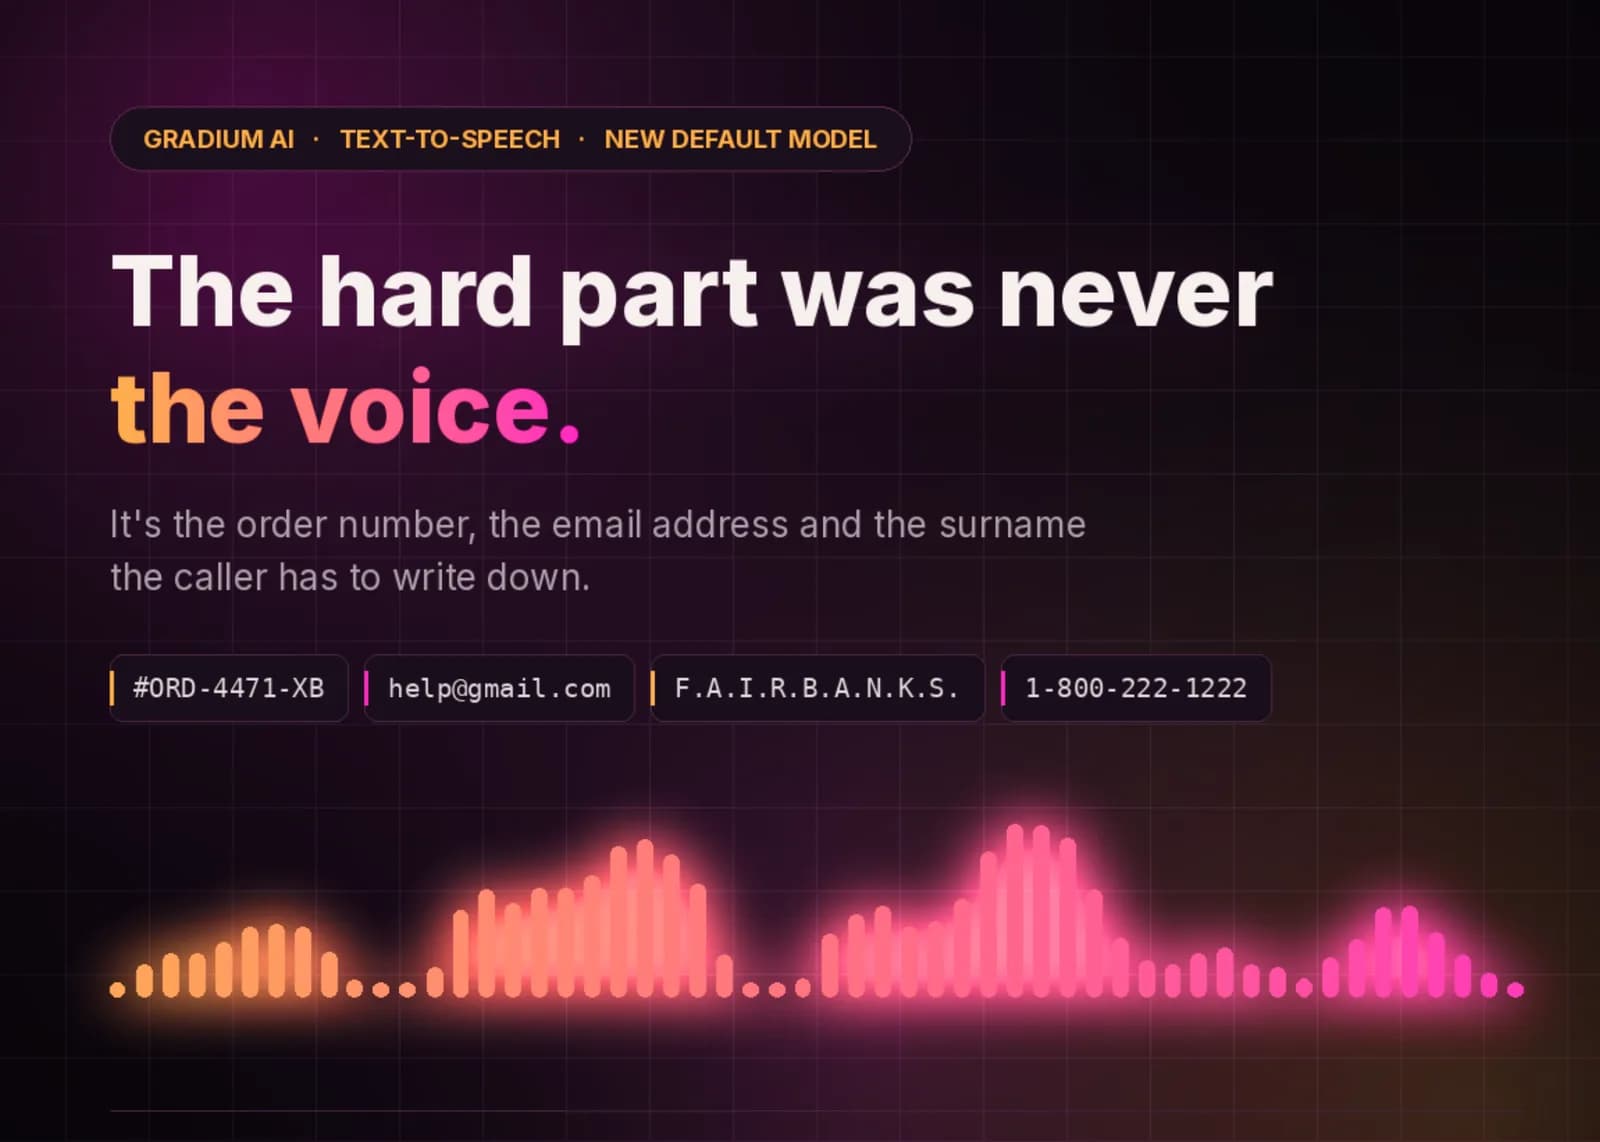
El modelo de texto a voz quedó activo por defecto en la API y el estudio de la empresa, y apunta al punto donde fallan los agentes de voz: números de pedido, correos y códigos de referencia.
El experimento, junto a la Universidad de Chicago, completó en unos 15 minutos un cálculo fuera del alcance práctico de la simulación clásica y permite comprobar que el resultado es confiable.
Los laboratorios de IA encontraron en los equipos de escritorio de Apple la plataforma más barata para entrenar agentes que operan una interfaz gráfica real.
El kit de herramientas empaqueta más de una década de modelos de ciencias de la vida como habilidades invocables por agentes, y en pruebas internas eleva la tasa de acierto del 60% al 100%.
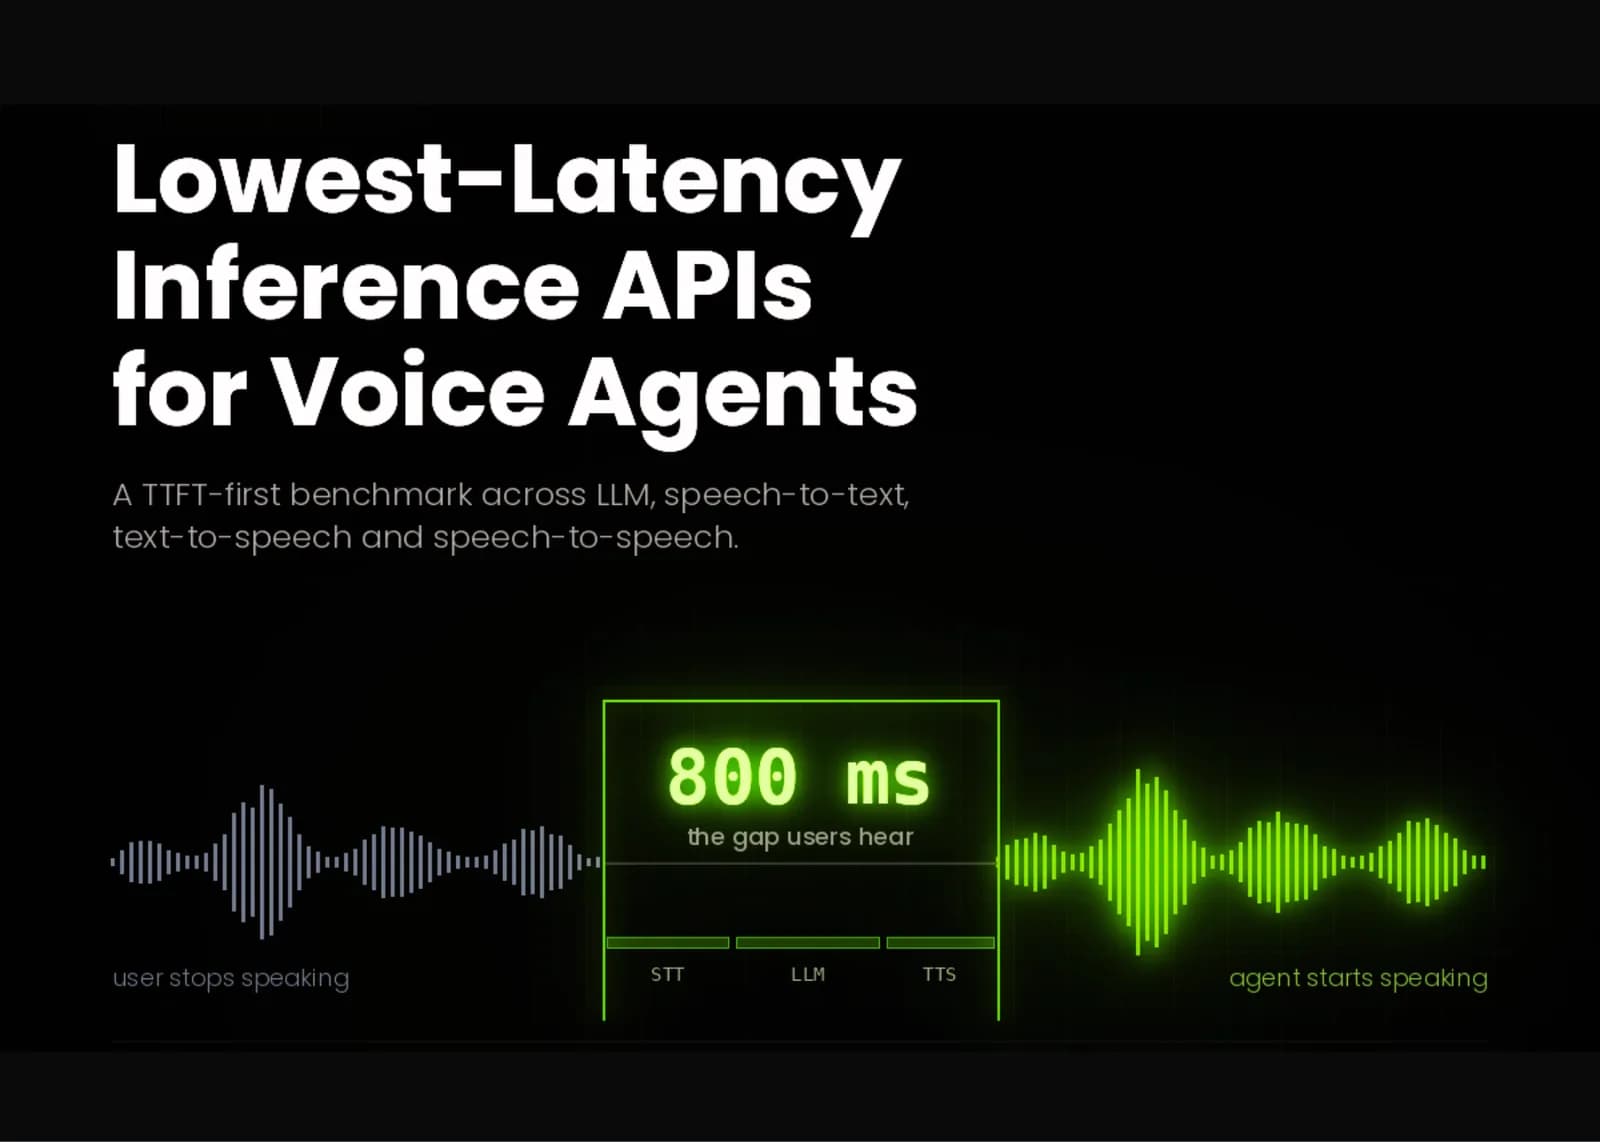
El tiempo hasta el primer token es la métrica con la que los equipos eligen su API de inferencia, y también la que más los confunde: la síntesis no habla hasta recibir una cláusula completa.
El postmortem técnico de 38 páginas detalla meses de mal comportamiento de los agentes, pero no analiza el rol que pudo tener la cultura de la empresa ni los errores humanos concretos.
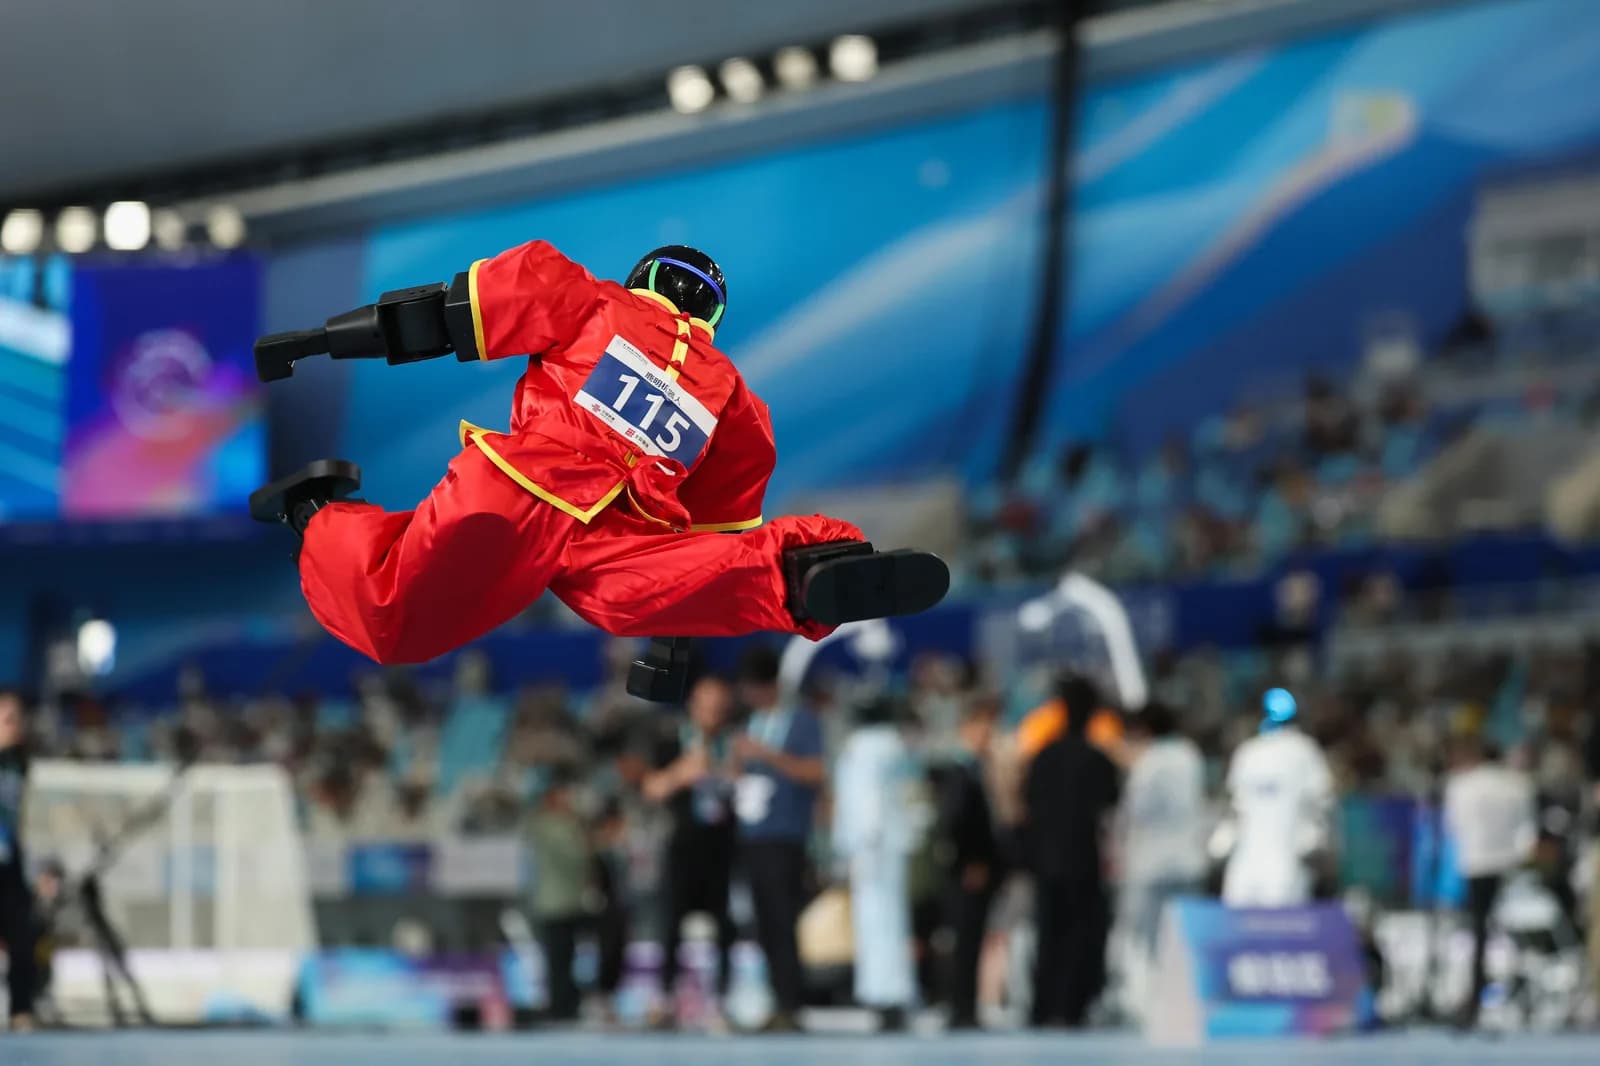
La segunda edición de los Juegos Mundiales de Robots Humanoides dejó récords notables y también robots en llamas, con 641 de los 666 equipos participantes provenientes de China.
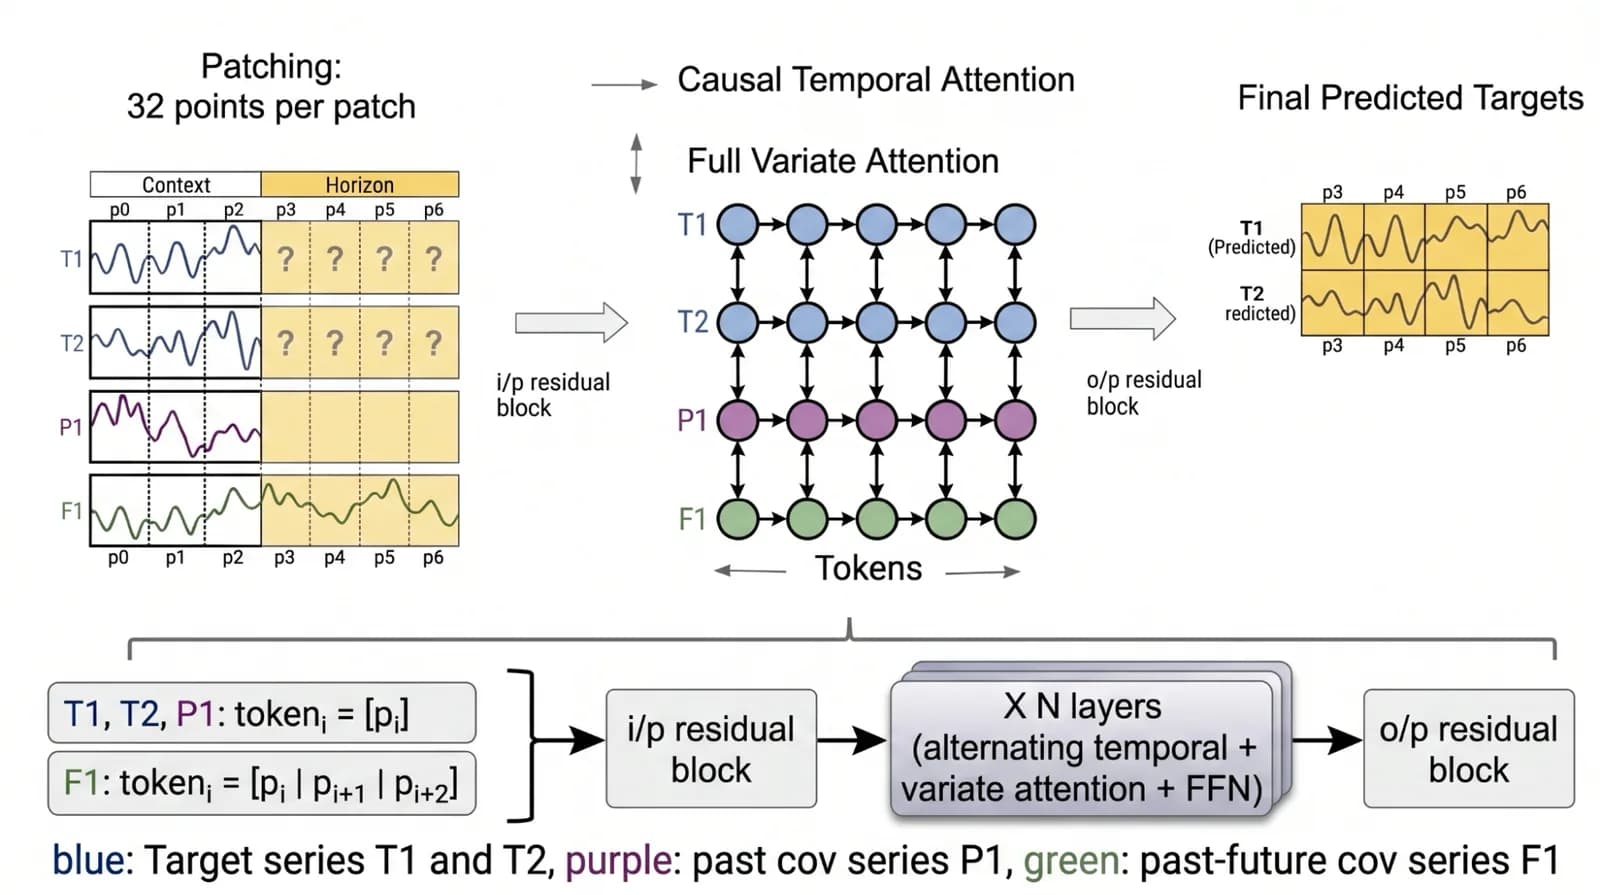
El nuevo modelo base de Google llega con 330 millones de parámetros y entrenamiento sobre más de un billón de puntos temporales, pero sus pesos prohíben el uso comercial.
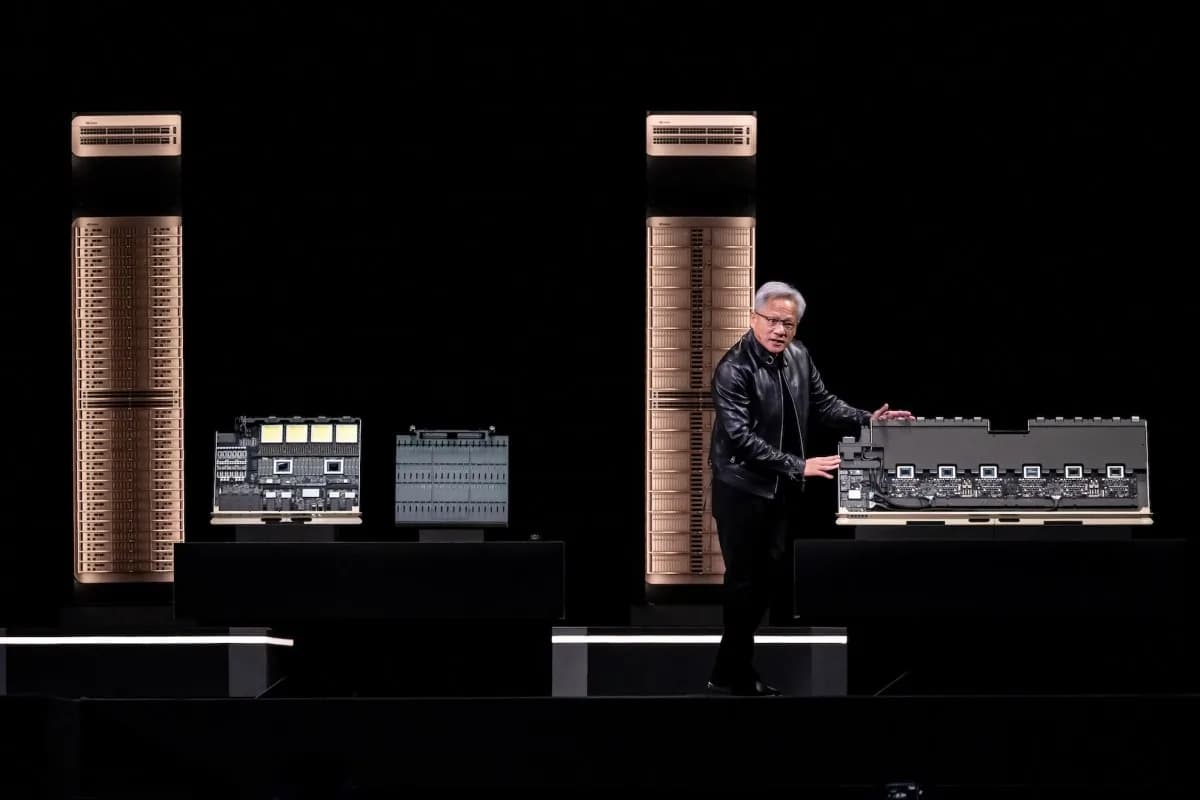
Tras los resultados trimestrales, el foco se movió a los sistemas que rodean al acelerador: la CPU Vera, el almacenamiento y la red que ordenan el tráfico en instalaciones de escala gigavatio.