Kimi K3: el modelo abierto de 2,8 billones que reta a Opus 4.8
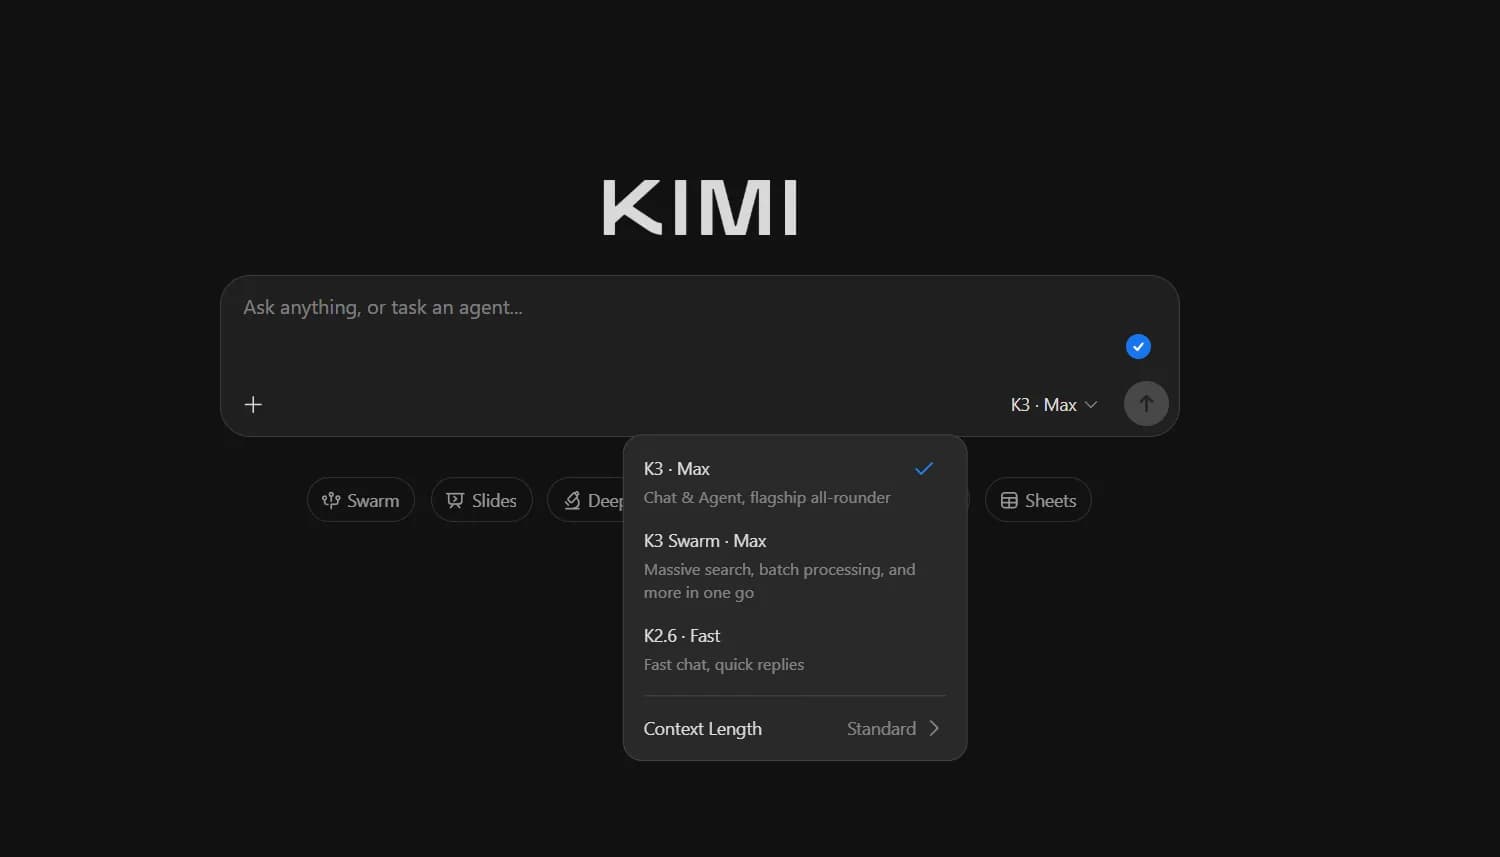
Moonshot AI lanzó su modelo más capaz, con pesos abiertos prometidos para el 27 de julio; supera a GPT-5.5 y Opus 4.8 en sus propios benchmarks, pero cobra como la gama Claude Sonnet.
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.

Moonshot AI lanzó su modelo más capaz, con pesos abiertos prometidos para el 27 de julio; supera a GPT-5.5 y Opus 4.8 en sus propios benchmarks, pero cobra como la gama Claude Sonnet.

El modelo multimodal de 2,4 billones de parámetros llega en versión preview y busca frenar el impulso de Kimi K3 antes de que Moonshot AI salga a bolsa.

Thinking Machines Lab, la empresa de Mira Murati, presenta su primer modelo entrenado desde cero: 975.000 millones de parámetros, multimodal y con pesos abiertos de uso comercial libre.

Desde el 20 de julio, Fable 5 quedará en Max y Team Premium con la mitad de los cupos ya reducidos, mientras los usuarios Pro pierden el acceso y reciben un crédito único de USD 100.

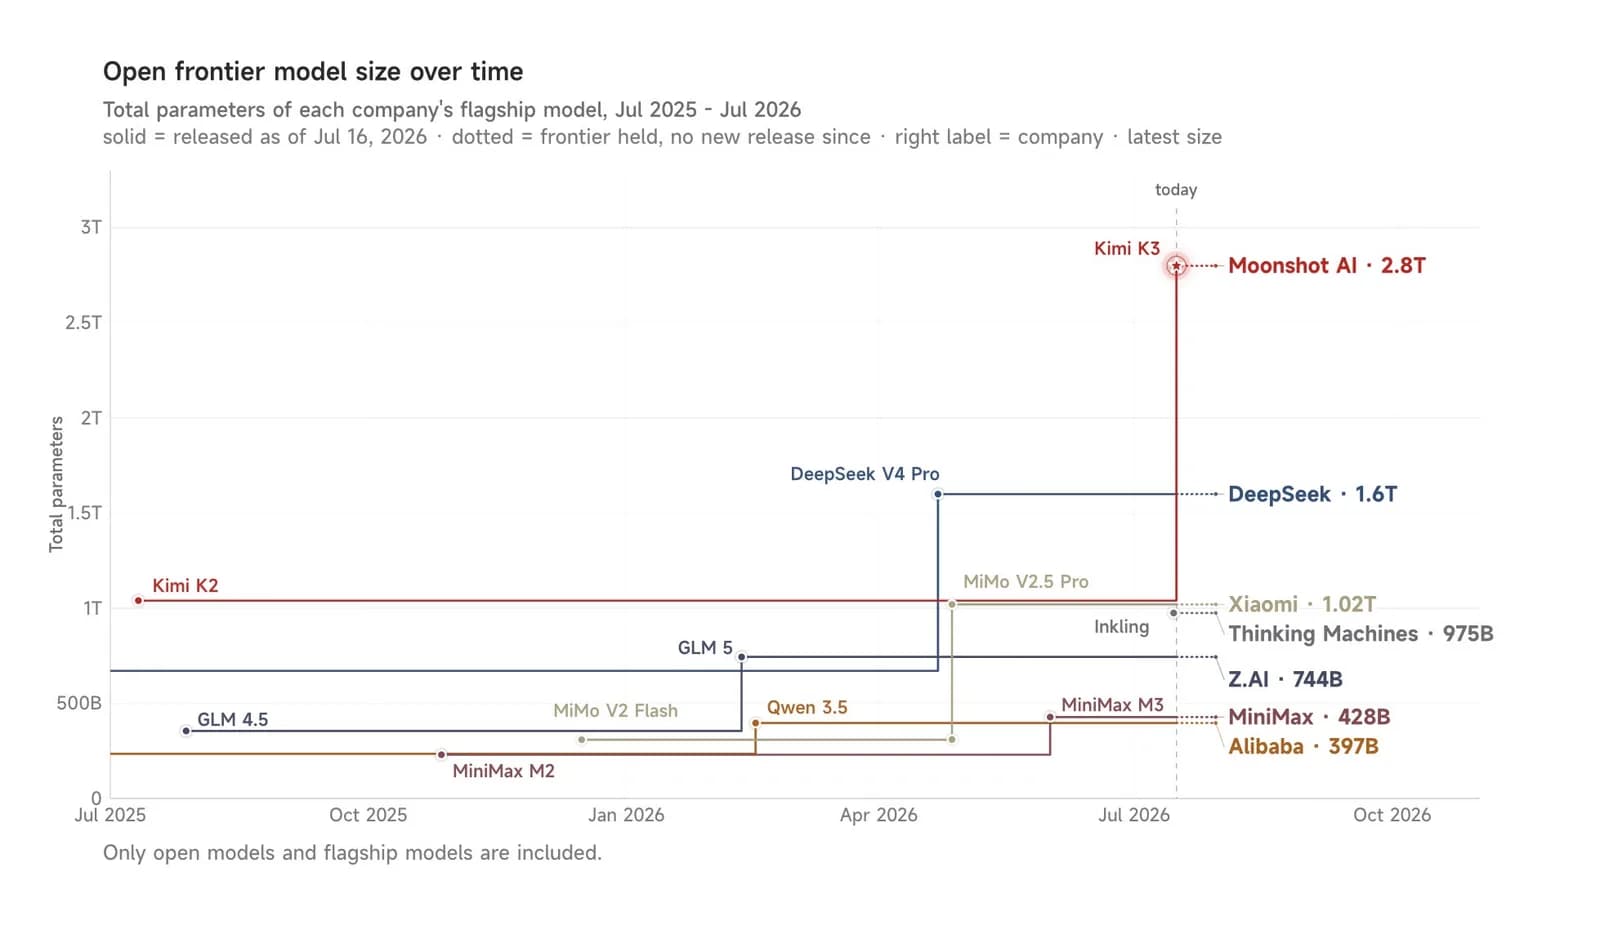
Moonshot AI presenta un modelo de 2,8 billones de parámetros con contexto de 1 millón de tokens y pesos abiertos prometidos para el 27 de julio, que ya lidera el ranking de código frontend.

Google cambió la forma de medir el uso de sus apps de IA: ahora cuenta la potencia de cómputo de cada petición y no la cantidad de solicitudes.

Thinking Machines Lab, la startup de Mira Murati, lidera entre los modelos de pesos abiertos de EE.UU., pero aún queda por detrás de los mejores chinos y arrastra un 63% de alucinaciones.

Google publicó una revisión de su modelo abierto que activa Flash Attention 4, corrige fallos en el llamado a herramientas y elimina respuestas cortadas, todo bajo el mismo nombre.

El nuevo buque insignia de Kimi suma 2,8 billones de parámetros y un millón de tokens de contexto, pero rompe con la era del modelo chino ultrabarato.

La versión 9.1 suma AutoMagicCalib y Multi-View 3D Tracking, dos habilidades que calibran cámaras y siguen objetos entre múltiples vistas sin configuración manual.

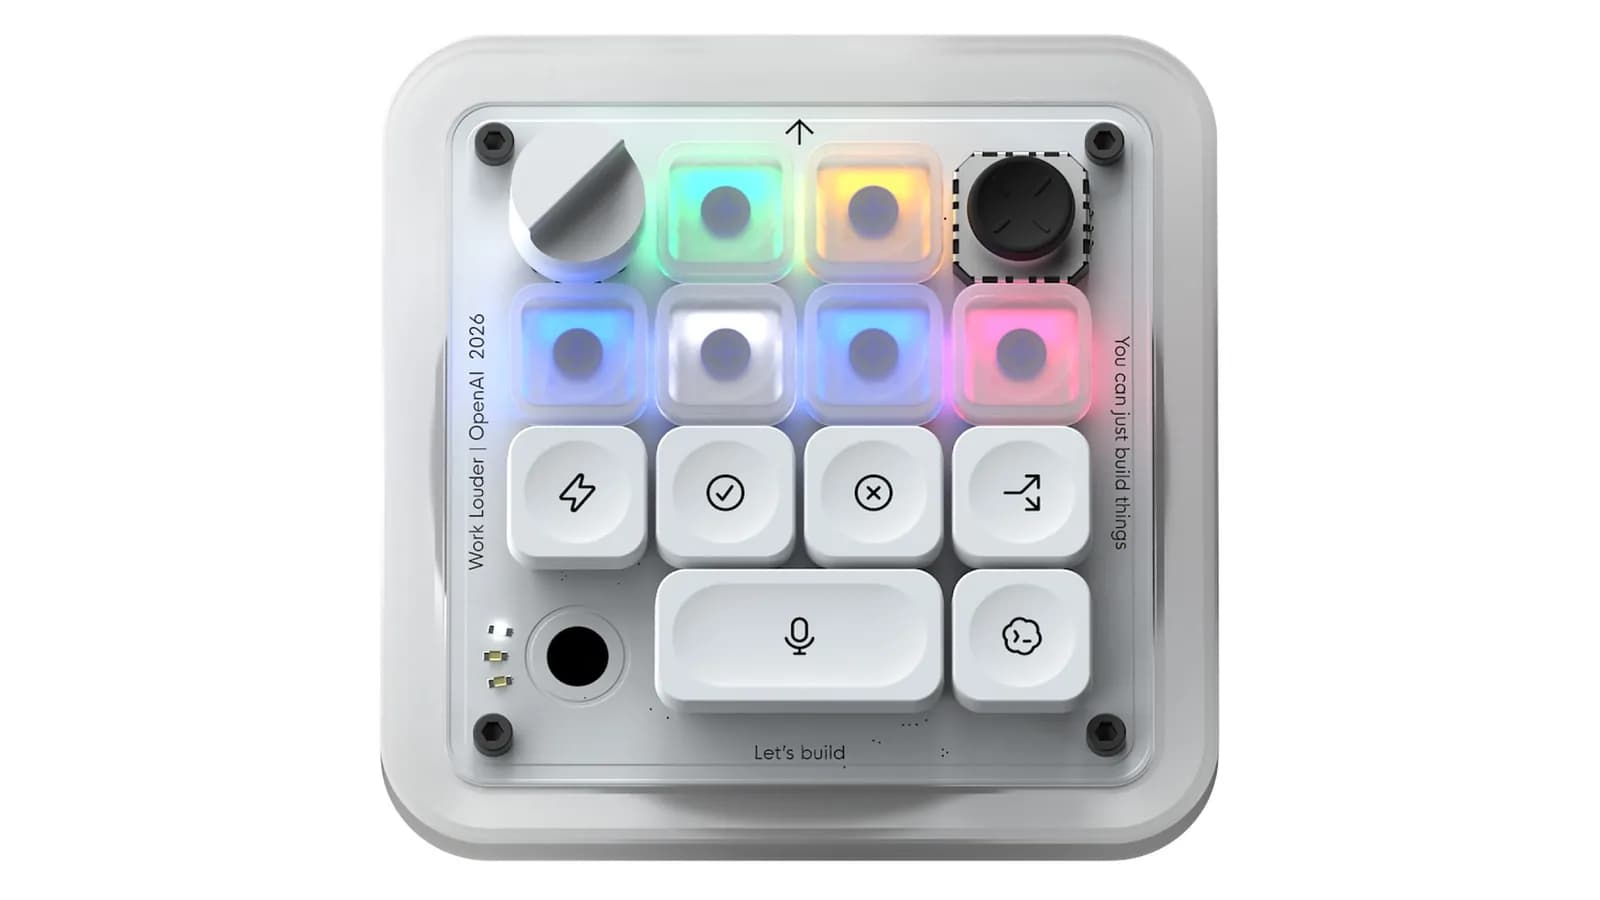
El controlador compacto creado con Work Louder reemplaza los comandos escritos por joysticks, un dial rotatorio y teclas RGB que muestran el estado de cada agente.

La startup de Mira Murati debuta con un modelo de pesos abiertos de 975.000 millones de parámetros y apuesta a que las empresas prefieran adaptar la IA a su medida antes que arrendar modelos cerrados.

Inkling es un modelo open-weight de 975.000 millones de parámetros entrenado desde cero para entender texto, audio y video, y podría posicionar a la startup de Mira Murati frente a OpenAI y Anthropic.

Los nuevos módulos basados en la arquitectura Thor llevan supercómputo de IA compacto a robots humanoides y máquinas autónomas, con rangos que van de 70 TOPS a 2.000 teraflops.

PrismML comprimió un modelo de 27.000 millones de parámetros a menos de 4 GB conservando cerca del 90% del rendimiento, y Apple ya estaría probando la tecnología para su IA en el dispositivo.

Con TAO, LoRA y un agente de programación, NVIDIA post-entrenó su modelo de razonamiento visual para preguntas sobre video y comprimió a un día lo que antes tomaba una semana de ingeniería.

Un agente de código puede montar el entorno, lanzar experimentos y afinar modelos por su cuenta. En una prueba llevó la precisión de un modelo de 25% a 96,9% en una tarea de conteo visual.

La oferta gratuita para docentes verificados de escuelas K-12 en Estados Unidos incluye Claude, Claude Code y el agente Cowork, con la promesa de no entrenar modelos con datos de estudiantes.

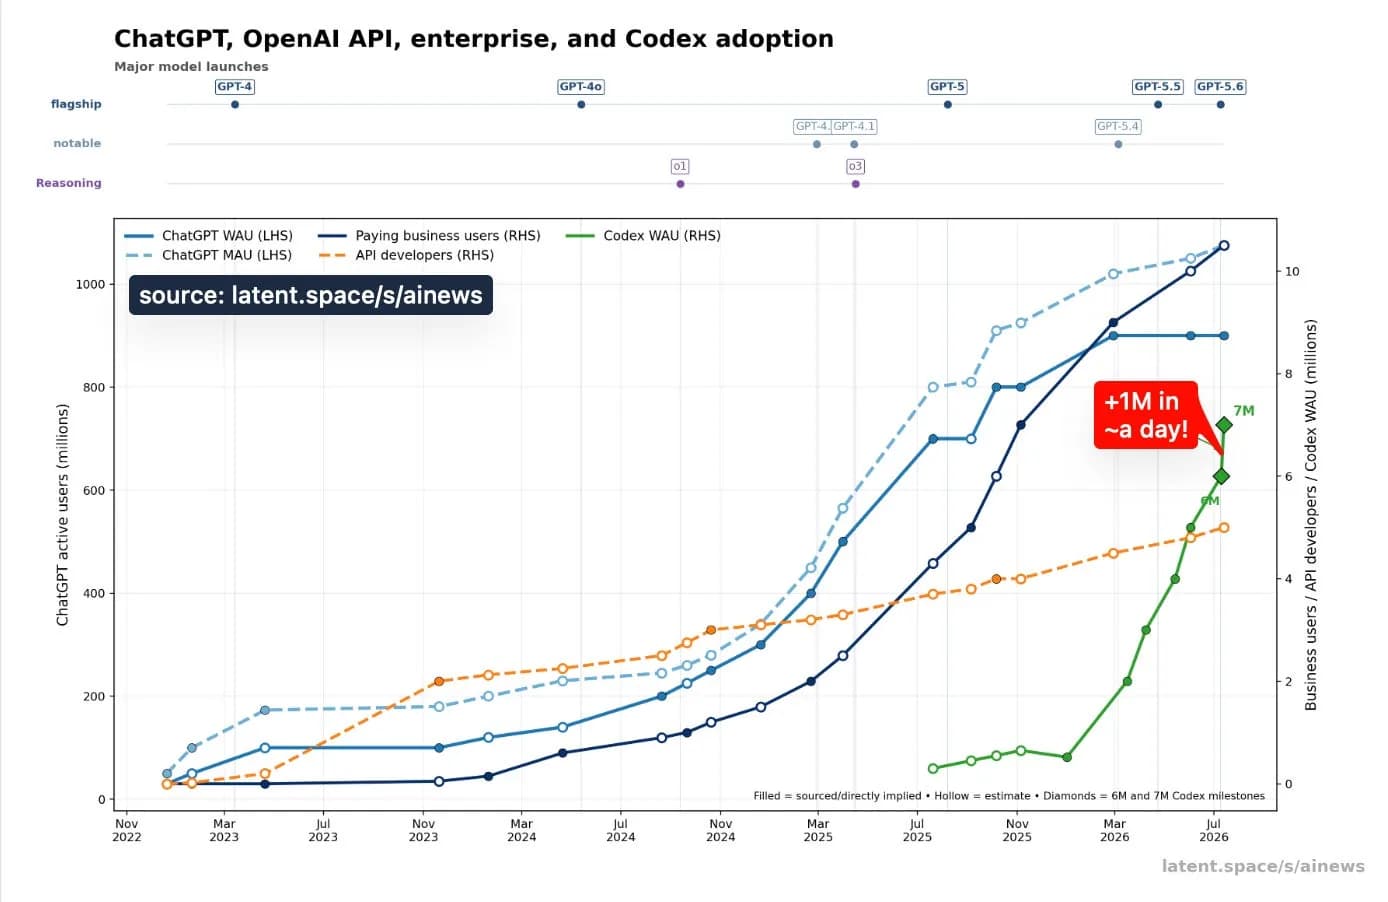
El agente de programación de OpenAI sumó cerca de un millón de usuarios en un día, mientras Anthropic dejó de publicar cifras comparables de Claude Code.

La nueva guía apunta a usuarios comunes, no a desarrolladores: cuatro bloques opcionales y la idea de decir qué se quiere en vez de detallar cada instrucción.

El ganador del Premio Turing 2024 y padre del aprendizaje por refuerzo moderno dice que el deep learning actual es "débil e ineficiente" y arranca su propia startup en Toronto.

Un consorcio alemán libera un modelo híbrido Mamba-Transformer entrenado en la nube de Deutsche Telekom, con foco deliberado en datos en alemán y solo 3,2B parámetros activos por token.

Un ingeniero de OpenAI explica qué nivel conviene para cada tipo de tarea y recomienda empezar bajo y subir solo cuando el problema lo pide, para no gastar tokens de más.

La compañía mantiene el acceso a Claude Fable 5 en sus planes de suscripción hasta el 19 de julio, en vez de pasarlo hoy a pago por uso, en plena guerra de precios de los modelos de IA.